
La fiabilidad es lo que decide si la IA llega a producción.

La mayoría de los pilotos de IA no se atascan por capacidad. Se atascan por confianza. Cuando se pregunta a las empresas qué les impide escalar la IA en operaciones reales, la fiabilidad encabeza la lista, por delante del coste, la integración y el talento.
El World Quality Report 2025, de OpenText, Capgemini y Sogeti, encontró que las alucinaciones y los problemas de fiabilidad eran uno de los principales retos de adopción para el 60% de las organizaciones, junto con la privacidad de los datos (67%) y la complejidad de integración (64%). Por su parte, la investigación de Gong de 2026 halló que el 58% de las empresas tenían proyectos de IA parados y que el 46% de las inversiones previstas en IA estaban frenadas específicamente por problemas de confianza, no de presupuesto. El patrón se repite en todas las encuestas: el entusiasmo es alto, pero la confianza no avanza al mismo ritmo.
La razón es sencilla. Una demo solo tiene que funcionar una vez. Un sistema en producción tiene que funcionar siempre, con entradas que nadie anticipó, delante de clientes y bajo obligaciones de política y cumplimiento. Ese listón es distinto, y es el listón que la fiabilidad tiene que superar.
En operaciones reales, un solo error puede costar más de lo que valen muchos aciertos.
Los casos de uso de negocio son asimétricos. El valor de una respuesta correcta suele ser pequeño y acotado: un ticket resuelto, un resumen exacto. El coste de una respuesta equivocada puede ser grande y no acotado: un reembolso aprobado contra la política, un compromiso inventado ante un cliente, una afirmación de cumplimiento incorrecta, datos de una cuenta entregados a alguien que nunca demostró quién era. Cuando el lado malo de equivocarse eclipsa el lado bueno de acertar, la precisión media es lo que no hay que optimizar. Lo que importa es cómo de malas son las peores salidas y con qué frecuencia se cuelan.
Hay un segundo coste, más silencioso. No toda salida floja es un error claro, pero una calidad inconsistente erosiona la confianza igual de rápido. Una persona de soporte que pilla una vez a la IA equivocándose empezará a revisar todo lo que produce, y eso borra la eficiencia que la IA debía aportar. Un cliente que recibe una sola respuesta robótica o sutilmente incorrecta descuenta todas las respuestas siguientes. La confianza no se puntúa en una sola interacción: es acumulativa y es frágil. Una vez se rompe, la adopción se detiene en silencio, aunque el sistema acierte la mayoría de las veces.
Por eso la fiabilidad no se puede tratar como un paso final. Tiene que estar diseñada dentro de la forma en que el sistema produce cada salida.
Incluso los modelos más potentes alucinan, y las cifras honestas son más altas de lo que se espera.
Una alucinación es contenido fluido, seguro de sí mismo y equivocado. Es una propiedad estructural de cómo generan texto los grandes modelos de lenguaje, no un fallo que un prompt mejor elimine del todo. La tasa varía mucho según el modelo y la tarea, pero nunca es cero.
La forma más clara de verlo es en el resumen con fuente: una tarea en la que se le entrega al modelo el texto de origen y se le indica que use solo eso. Es lo más parecido a cómo se usa la IA en atención al cliente y en pipelines RAG: dada tu documentación de ayuda, responde a partir de ella. Además es el caso fácil, porque los datos están ahí mismo. Y aun así, los modelos inventan.
El Hallucination Leaderboard de Vectara, que puntúa modelos con su modelo de evaluación HHEM, muestra la horquilla a mayo de 2026:
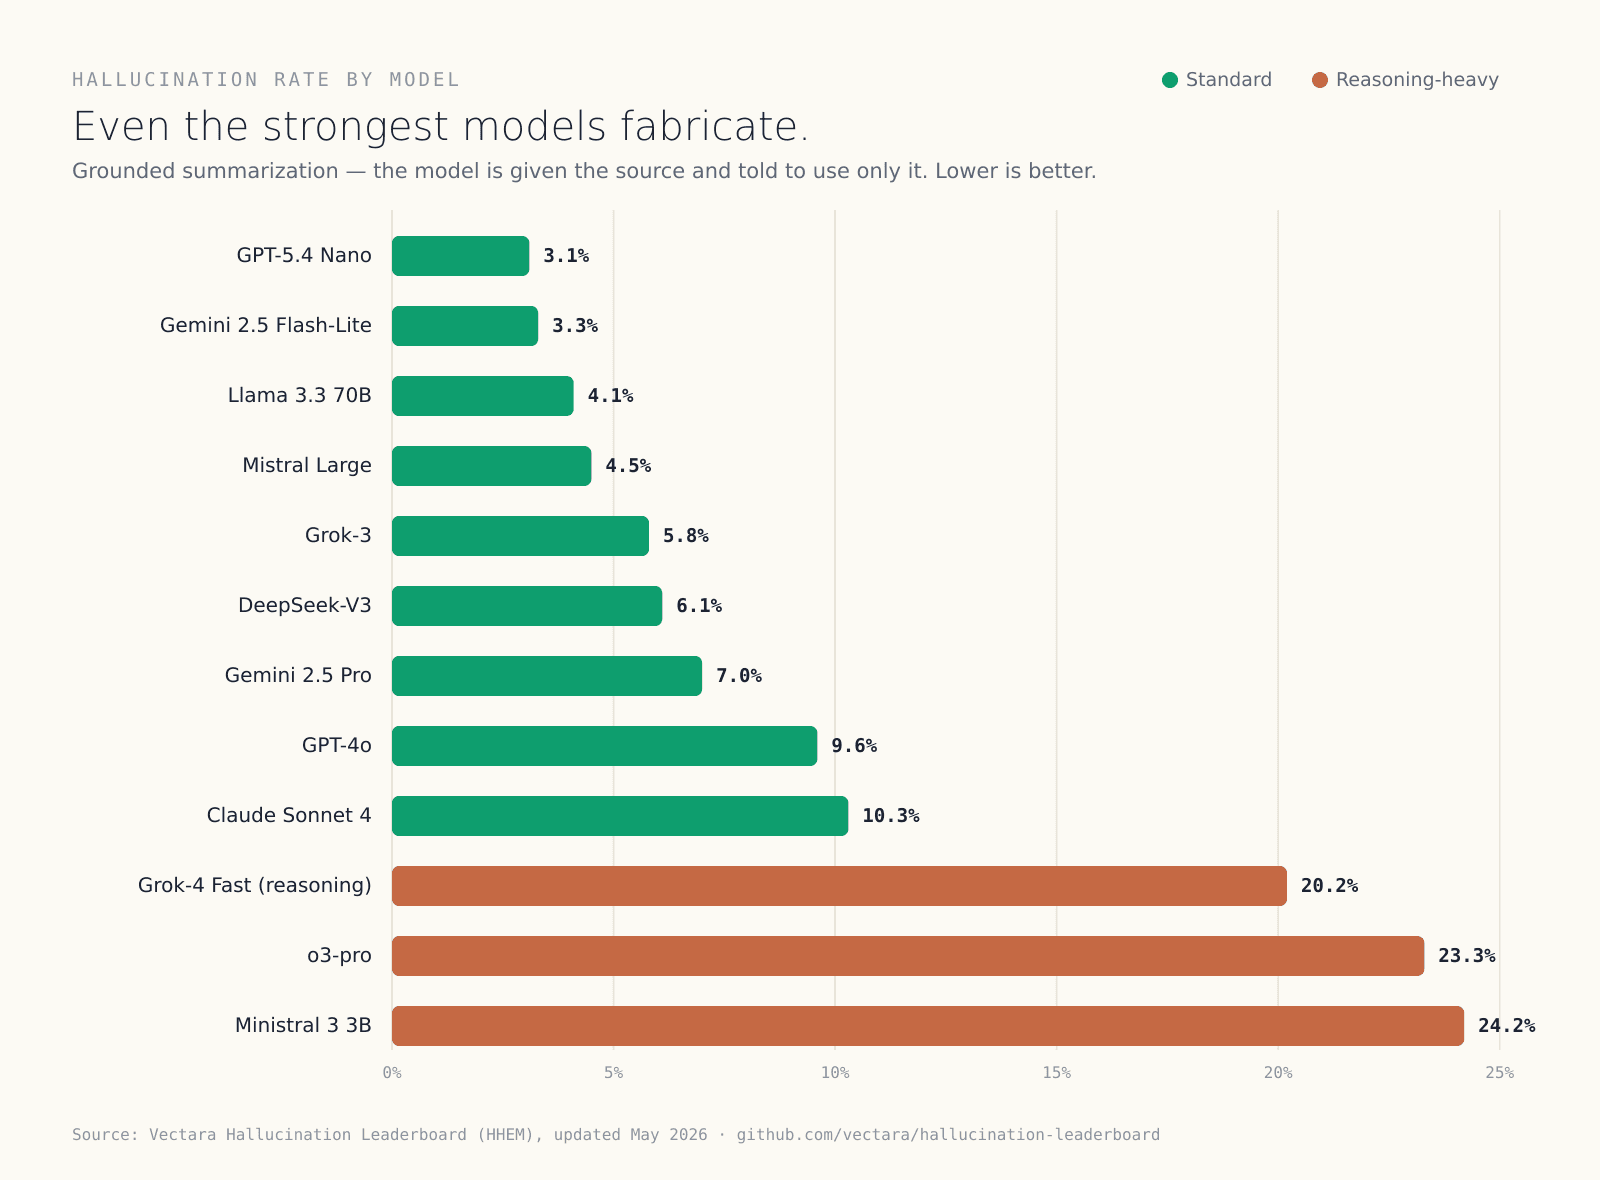
Los mejores modelos se sitúan en torno al 3%. Los modelos insignia más conocidos se agrupan entre el 6% y el 15%. Algunos modelos con mucho razonamiento superan el 20% en la misma tarea con fuente, porque razonar más a fondo da al modelo más margen para introducir afirmaciones que la fuente nunca hizo. Y este es el escenario favorable. Cuando los modelos responden preguntas abiertas sin una fuente que los ancle, las tasas suben con fuerza: RegLab y el Human-Centered AI Institute de Stanford hallaron que los modelos líderes alucinan en el 69% al 88% de las consultas jurídicas específicas, y en al menos el 75% de las preguntas sobre el fundamento central de una sentencia.
La conclusión no es que un modelo concreto sea malo. Es que ningún modelo por sí solo es lo bastante fiable para operaciones de negocio críticas. Una cifra de un solo dígito suena pequeña hasta que la multiplicas por el volumen de una cola de soporte real, y hasta que recuerdas que el coste de esas pocas salidas no se reparte por igual.
¿Por qué la fiabilidad es un equilibrio entre inteligencia y controlabilidad?
Es un equilibrio clásico en machine learning, y se ve con claridad en las aplicaciones de IA. A medida que los sistemas ganan capacidad, también se vuelven más difíciles de controlar por completo.
Inteligencia es algo más que recordar respuestas conocidas. Significa extender lo conocido a casos poco familiares, reconocer patrones difusos y tomar decisiones útiles cuando la entrada está incompleta. Son exactamente las cualidades que hacen valiosa a la IA avanzada.
Pero esas mismas cualidades aumentan la imprevisibilidad. Un sistema capaz de pensar más allá de instrucciones rígidas también puede equivocarse más allá de instrucciones rígidas.
Por eso una IA potente nunca será fiable al cien por cien. La fiabilidad puede seguir mejorando y los errores graves se pueden reducir mucho, pero la previsibilidad perfecta solo llega limitando la propia inteligencia. Así que la pregunta práctica no es cómo hacer perfecta a la IA. Es cómo hacer previsible su comportamiento donde importa, y seguros sus errores donde saldrían caros: dos problemas de ingeniería distintos.
¿Qué es la IA fiable? Previsibilidad más seguridad.
La IA fiable es una IA de la que un negocio puede depender en producción: produce de forma constante el resultado que el negocio quiere y nunca divulga información sensible ni ejecuta una acción sensible que no debe. Lo separamos en dos propiedades, porque fallan de forma distinta y se corrigen de forma distinta.
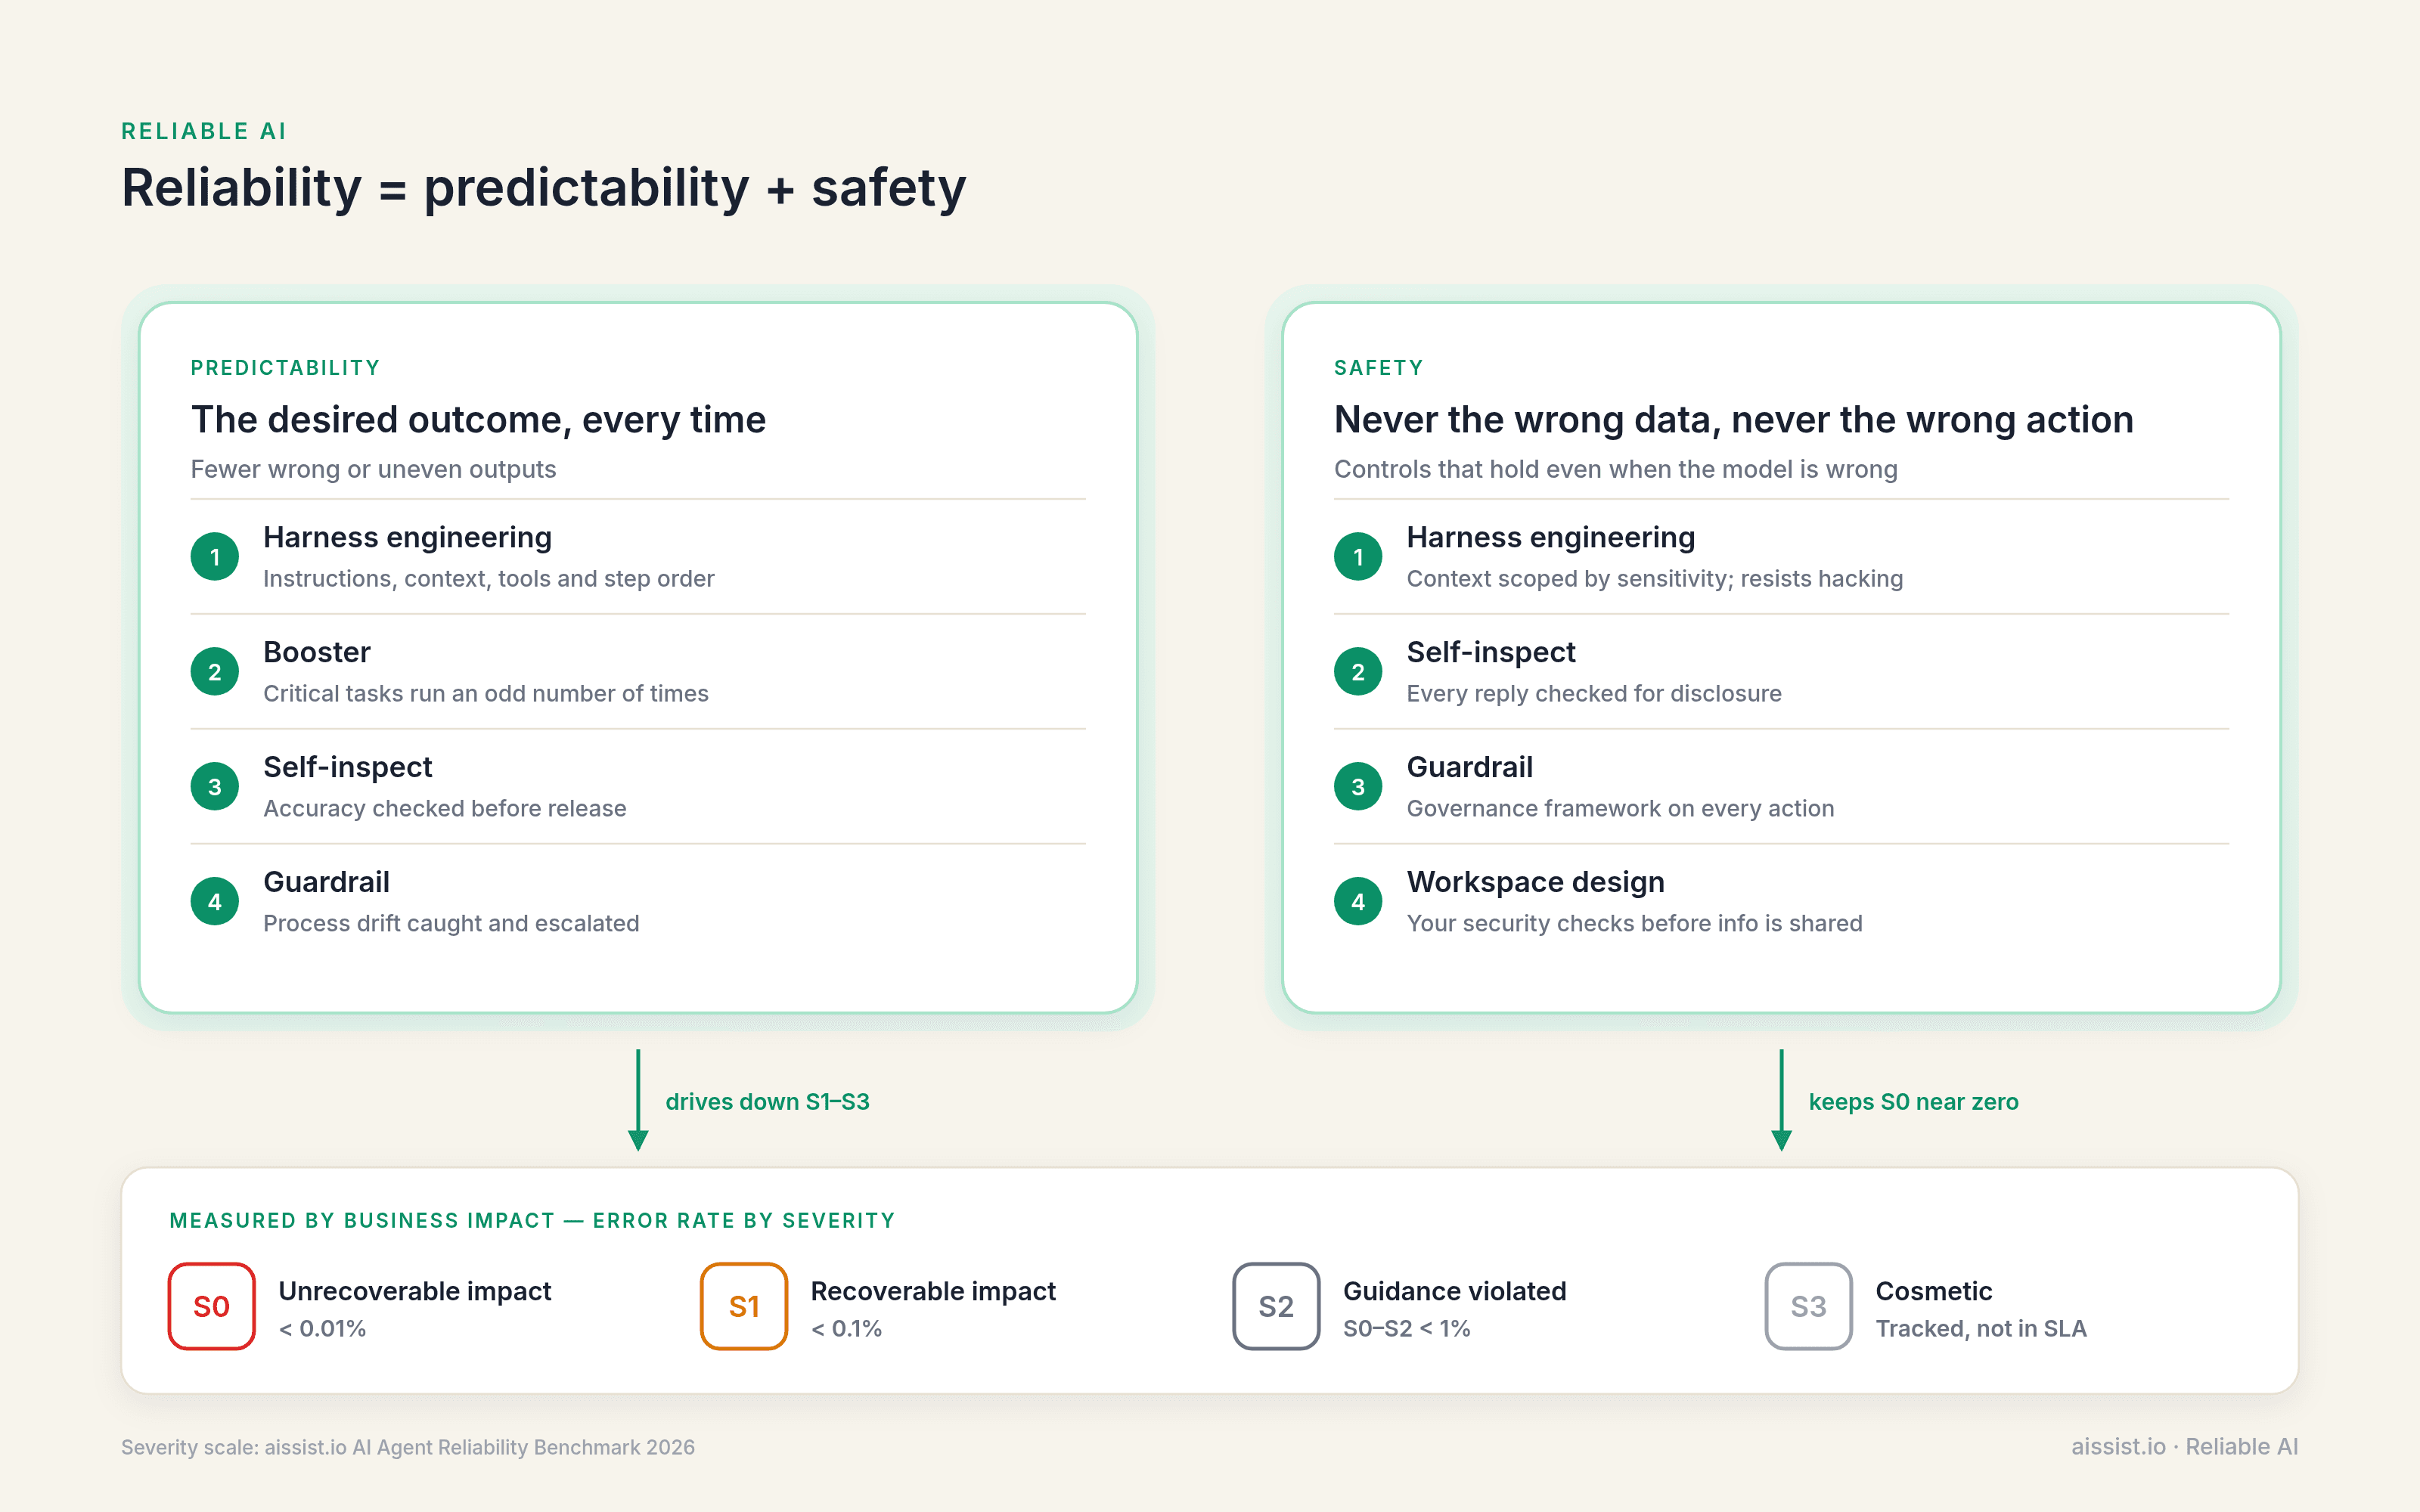
La previsibilidad es la constancia con la que la IA entrega el resultado deseado: la respuesta correcta, la rama correcta del flujo, el tono correcto, igual en la conversación diez mil que en la primera. Un fallo de previsibilidad es una salida equivocada o desigual: una fecha de entrega errónea, un paso saltado, una respuesta que suena distinta cada vez que se pregunta.
La seguridad es la garantía de que la información y las acciones sensibles nunca se ejecutan por error: ningún detalle de pedido entregado a quien no ha demostrado quién es, ningún reembolso fuera de política, ninguna instrucción del sistema revelada a quien la busca. Un fallo de seguridad rara vez es una respuesta equivocada. Es una respuesta que suena correcta dada a la persona equivocada, o una acción que nunca debió ejecutarse.
Las dos comparten herramientas —el harness engineering, la autoinspección y los guardarraíles sirven a ambas—, pero las apuntan a cosas distintas. La previsibilidad trata de hacer bien el trabajo. La seguridad trata de lo que no debe ocurrir nunca, ni siquiera el día en que el trabajo sale mal.
¿Cómo se mide la fiabilidad de la IA? Cuatro niveles de impacto en el negocio.
Las dos mitades acaban en el mismo sitio: lo que un error le cuesta al negocio. Medimos la fiabilidad como tasa de error graduada por gravedad, con la escala de cuatro niveles definida en el AI Agent Reliability Benchmark 2026: contada sobre las conversaciones atendidas por la IA, y con cada nivel reportado por separado en lugar de mezclado.
| Nivel | Impacto en el negocio | Ejemplos | Lo protege sobre todo | Objetivo |
|---|---|---|---|---|
| S0 | Cambia un resultado que el negocio no puede deshacer | Un reembolso, descuento o condición contractual fuera de política; una obligación que el negocio debe cumplir; información revelada a quien no debía verla | Seguridad | < 0,01% |
| S1 | Impacto en el negocio, fácil de recuperar | Código promocional, URL, fecha de entrega o artículo equivocados; un precio citado que no se respeta | Previsibilidad | < 0,1% |
| S2 | Sin impacto en el negocio; se incumple una guía interna | Un paso de verificación saltado, la rama equivocada del manual, una conversación sin etiquetar | Ambas | S0–S2 en conjunto < 1% |
| S3 | Cosmético | Redacción, gramática, deriva de tono, formato | Previsibilidad | Se mide, fuera del SLA |
Los niveles explican por qué las dos mitades se diseñan de forma distinta. El trabajo de previsibilidad reduce el volumen de errores S1–S3, los que cuestan un mensaje de seguimiento o un poco de confianza. El trabajo de seguridad existe para mantener S0 cerca de cero: un nivel en el que un solo incidente pesa más que miles de conversaciones buenas, así que los controles tienen que aguantar incluso cuando el modelo se equivoca.
S2 queda entre las dos, y es el nivel que hay que vigilar. Una verificación de identidad saltada no cuesta nada el día que ocurre; simplemente ha quitado el control que separaba una conversación normal de un S0. Por eso las dos mitades lo reclaman.
¿Cómo se construye una IA fiable?
Esa distancia —entre lo que entrega un modelo en bruto y aquello de lo que un negocio puede depender— es justo lo que viene a cerrar una capa de gobernanza de la IA. Por eso Aissist.io no trató la fiabilidad como una función a añadir después, sino como el marco por el que pasa cada salida.
Desde el primer día, Aissist.io se centró en construir un marco de gobernanza de la IA para mejorar la fiabilidad y la calidad de cada salida.
El marco ataca cada mitad con su propio conjunto de mecanismos. La previsibilidad usa harness engineering, booster, autoinspección y guardarraíles. La seguridad usa harness engineering, autoinspección, guardarraíles y diseño del espacio de trabajo. Ningún mecanismo basta por sí solo, así que se apilan: cada uno atrapa un tipo de fallo que los demás dejan pasar.
Previsibilidad: cómo la IA entrega de forma constante el resultado deseado.
Un agente previsible hace lo mismo correcto cada vez que se encuentra la misma situación. Cuatro mecanismos lo consiguen, más o menos en orden de coste.
El harness engineering fija el comportamiento antes de empezar el trabajo.
El harness engineering es la primera capa, y sustituye a lo que antes se llamaba ingeniería de prompts. Un prompt es una instrucción para una llamada al modelo. Un harness es todo lo que rodea al modelo y da forma a su comportamiento: las instrucciones, el contexto que recibe y el que se le niega, las herramientas que puede usar, el orden de los pasos y los controles entre ellos.
La diferencia importa sobre todo en la IA agéntica, donde una ejecución se despliega en muchas tareas. En Aissist, una sola ejecución puede generar de 12 a 20 tareas, y cada una tiene que correr dentro del mismo harness de política, calidad y escalación. Un único harness las mantiene coherentes; veinte prompts ajustados por separado acabarían divergiendo.
El harness engineering por sí solo no basta, pero sin él el resto de la pila de fiabilidad queda mucho más débil.
El booster mejora la fiabilidad preguntando más de una vez.
El booster ejecuta la misma tarea varias veces, normalmente un número impar, compara los resultados y sigue adelante con el que tenga mayor acuerdo.
Es una forma potente de mejorar la fiabilidad, sobre todo en las partes más inciertas o más críticas del sistema. La contrapartida es el coste: puede duplicar o incluso triplicar el cómputo necesario para una decisión, y por eso se dirige a las decisiones que importan y no a cada respuesta.
La autoinspección añade un control de calidad antes de publicar la salida.
Antes de que salga la respuesta final, el sistema se pregunta si es realmente correcta dado el contexto y la información disponible: si responde a lo que se preguntó, si cada afirmación tiene una fuente detrás, si sigue el flujo que definió el negocio.
Funciona mejor cuando la inspección adopta una perspectiva distinta de la generación: el mismo modelo con otro rol, o un modelo más potente que revisa la decisión con criterio. Es la última oportunidad de atrapar un error antes de que lo vea el cliente.
Los guardarraíles mantienen el rumbo de todo el sistema.
Un guardarraíl gobierna el comportamiento del sistema completo, no de una sola salida. Una capa supervisora aparte, en la práctica una policía de la IA, comprueba salidas y acciones frente a la política y las guías del negocio, y decide si dejarlas pasar, detenerlas o escalarlas a una persona.
Para la previsibilidad, el trabajo del guardarraíl es la coherencia: atrapar la deriva de proceso —el paso saltado, la rama equivocada del manual— antes de que se convierta en patrón. Añade cómputo y algo de latencia, por eso se ajusta al riesgo de cada flujo en lugar de aplicarse por igual.
Seguridad: cómo la información y las acciones sensibles nunca se ejecutan por error.
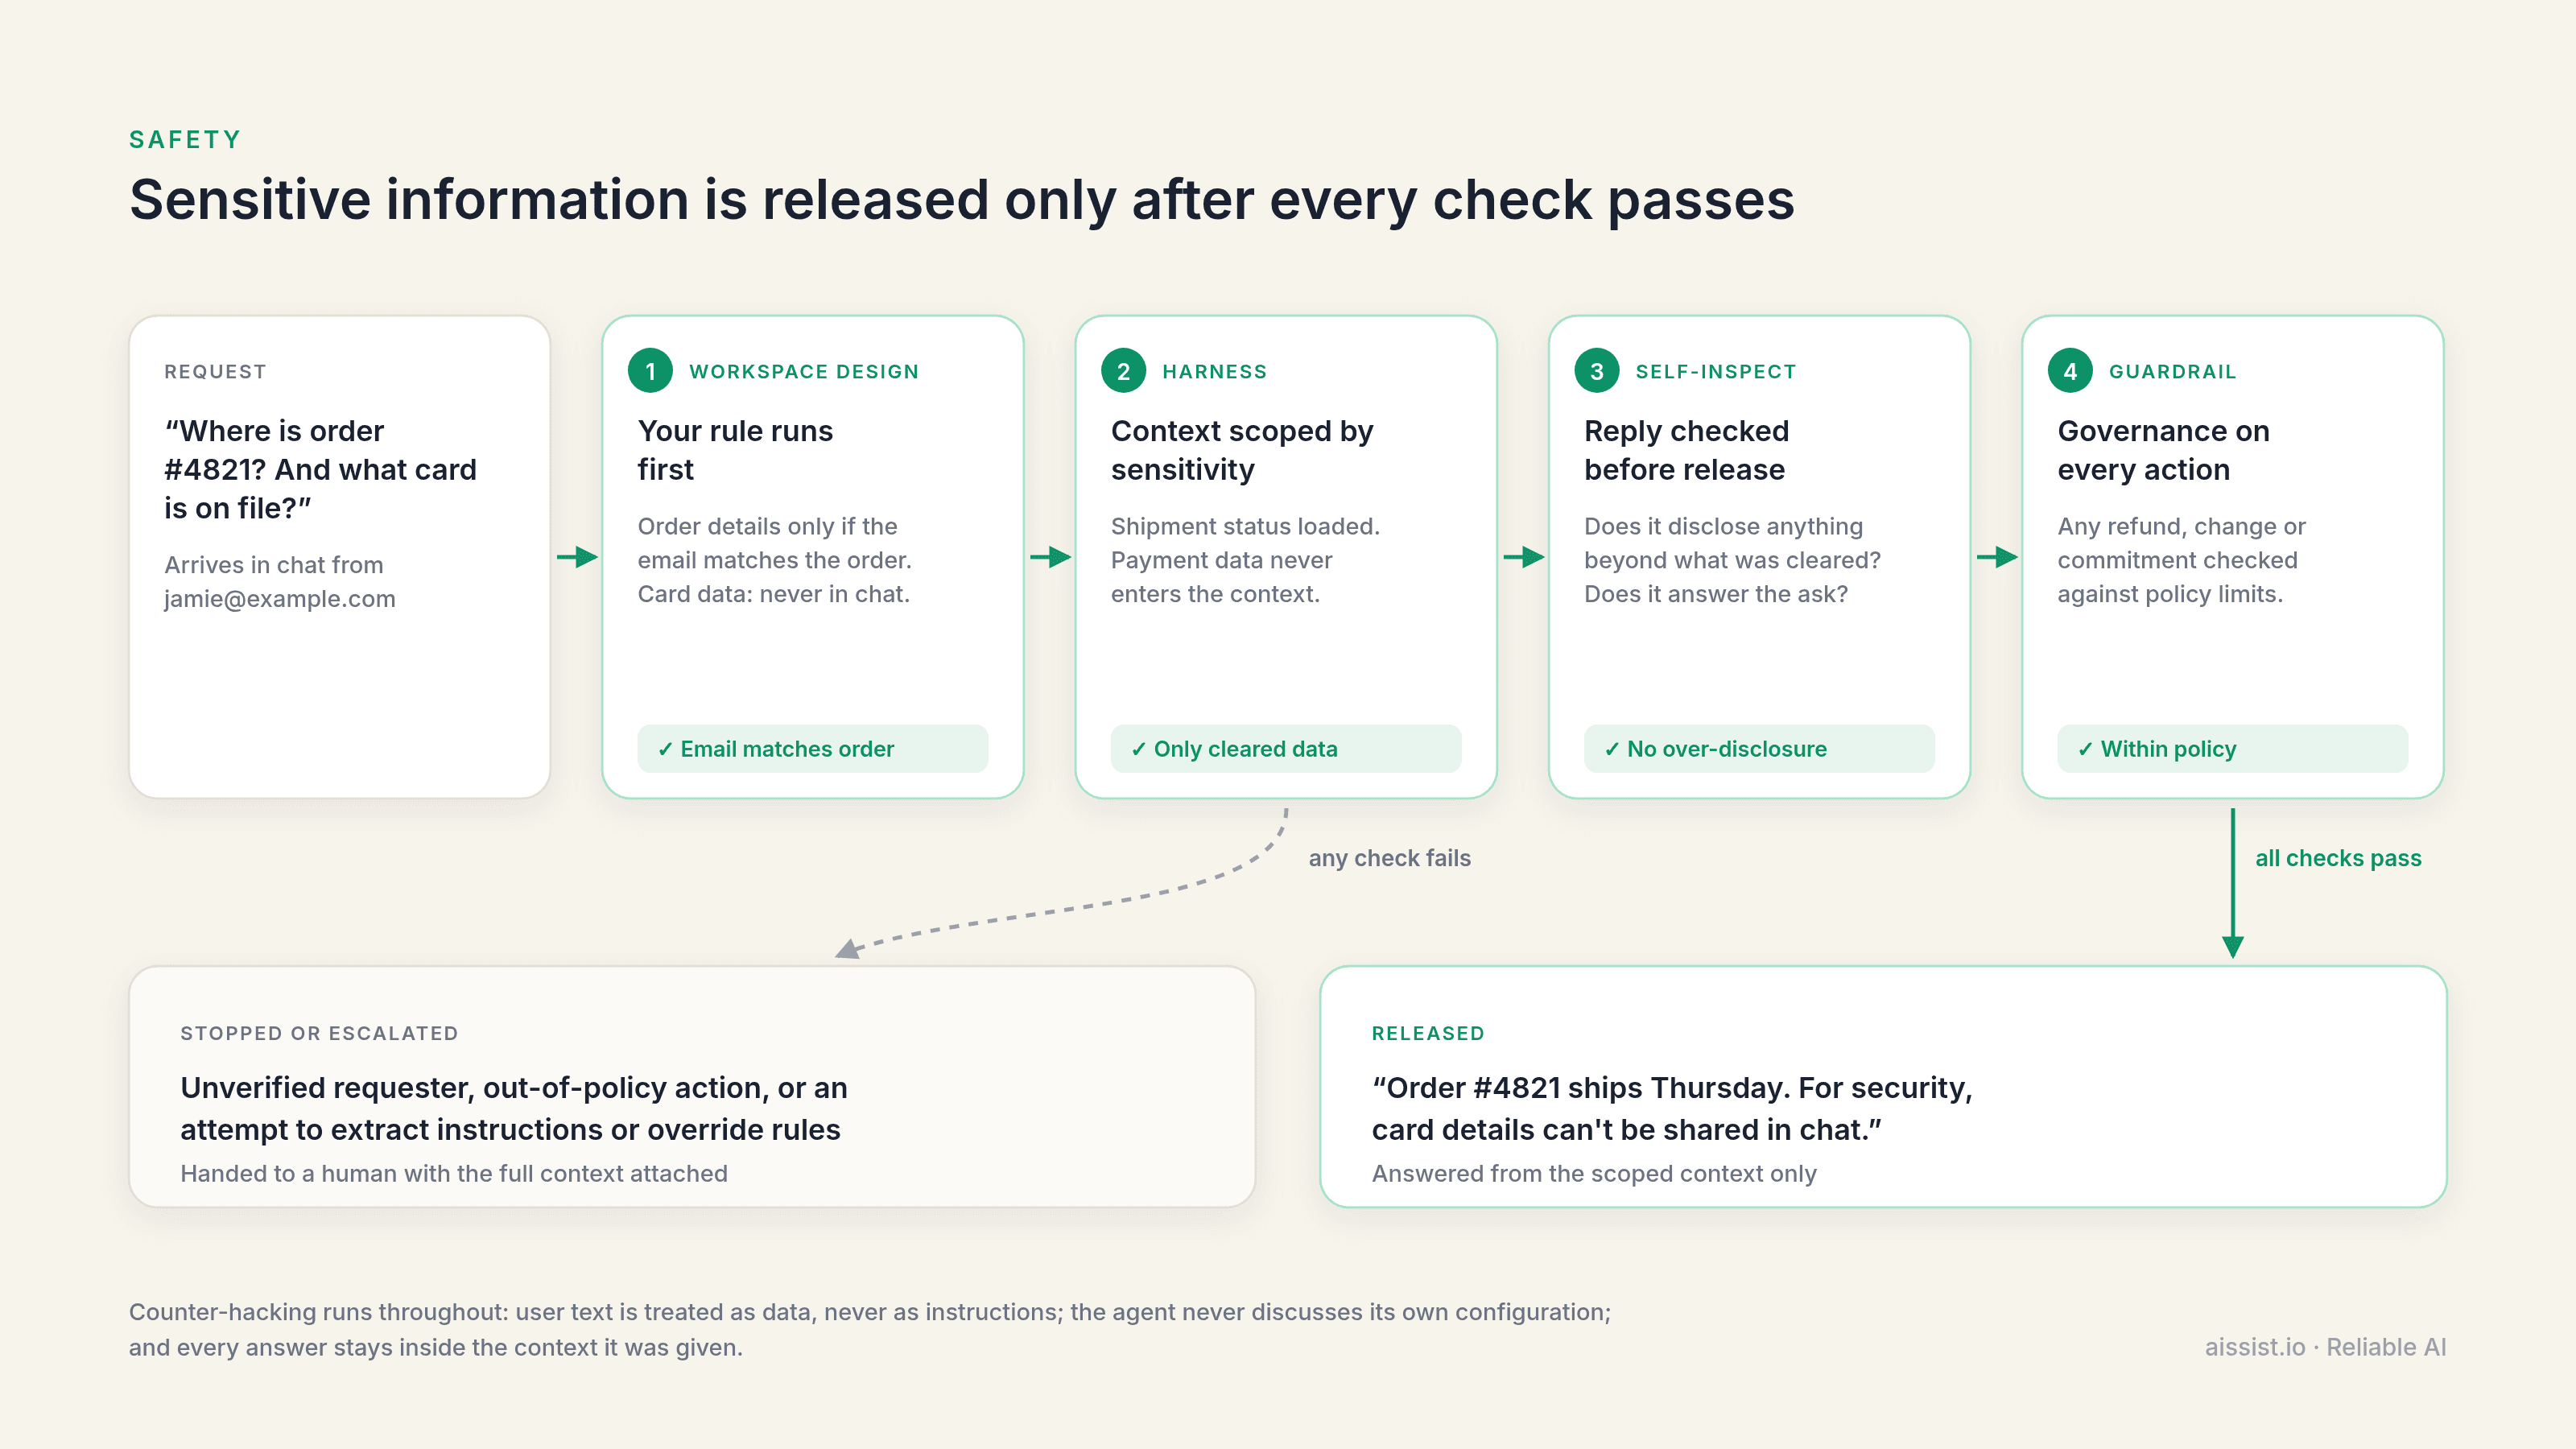
La seguridad parte de otro supuesto: el modelo a veces se equivocará, y a veces alguien intentará que se equivoque a propósito. Así que los controles no pueden depender de que el modelo elija bien. Tienen que hacer imposible la divulgación o la acción equivocada, o atraparla antes de que salga.
El harness engineering decide qué puede ver el agente y de qué no se le puede convencer.
En el lado de la seguridad, el harness engineering gestiona el alcance de la información según su sensibilidad. Un agente que responde una pregunta de envío recibe el estado del envío, no la cuenta completa del cliente, y los datos por encima de cierto nivel de sensibilidad solo entran en contexto después de superar sus controles. Lo que nunca está en contexto nunca se puede filtrar.
El harness también lleva las defensas contra el hackeo. Los clientes —y quienes se hacen pasar por clientes— intentarán convencer al agente de saltarse sus reglas: pedirle que revele sus instrucciones, sondearlo para hacer ingeniería inversa de cómo decide, usar un juego de rol para esquivar una política o pegar texto que finge ser una nueva orden. El harness mantiene al agente anclado al contexto que recibió: responde desde el conocimiento aprobado y los sistemas conectados, trata todo lo que aporta el usuario como datos y no como instrucciones, y no habla de su propia configuración.
La autoinspección revisa cada respuesta en busca de divulgaciones, no solo de errores.
Antes de publicar nada, la autoinspección hace una pregunta de seguridad además de una de calidad: ¿revela esta respuesta algo que esta persona no está autorizada a ver, y coincide esta acción con lo que de verdad se pidió y se autorizó?
Una respuesta puede aprobar en precisión y suspender aquí. Un historial de pedidos correcto enviado a alguien sin verificar es un S0 perfectamente preciso.
Los guardarraíles son el marco de gobernanza por el que pasa cada acción.
El guardarraíl es el marco de gobernanza: la política aplicada a nivel de sistema, con independencia de lo que haya decidido el modelo. Las acciones con consecuencias de negocio —reembolsos, descuentos, cambios de cuenta, compromisos— se comprueban frente a los límites que fijó el negocio, y todo lo que queda fuera se detiene o se escala a una persona con todo el contexto adjunto.
El modelo puede proponer una acción. Solo la capa de gobernanza puede dejar que se ejecute.
El diseño del espacio de trabajo pone las reglas de seguridad en manos del negocio.
Cada espacio de trabajo define los controles de seguridad que deben superarse antes de dar un tipo de información; por ejemplo, el email de la conversación debe coincidir con el del pedido antes de compartir sus detalles, o hay que confirmar un código de un solo uso antes de hablar de datos de la cuenta. Son reglas que escribe el negocio, no comportamientos que se le pide recordar al modelo, así que se cumplen en todas las conversaciones, se formule como se formule la petición.
Eso es también lo que hace auditable la seguridad. Cuando alguien pregunta por qué el agente se negó, o por qué compartió algo, la respuesta es una regla con un responsable, no una suposición sobre lo que pensaba el modelo.
¿Cómo se comparan los mecanismos?
Un mismo mecanismo puede hacer un trabajo distinto en cada lado. Esto es dónde se sitúa cada uno, lo que cuesta y qué niveles de gravedad protege sobre todo.
| Mecanismo | Pilar | Qué hace | Coste | Niveles principales |
|---|---|---|---|---|
| Harness engineering | Previsibilidad | Da forma a instrucciones, contexto, herramientas y orden de pasos para que cada tarea se comporte igual | Bajo | S1–S3 |
| Booster | Previsibilidad | Ejecuta una tarea crítica un número impar de veces y se queda con el mayor acuerdo | Alto | S1 |
| Autoinspección | Previsibilidad | Comprueba precisión y proceso frente al contexto antes de publicar | Medio | S1–S3 |
| Guardarraíl | Previsibilidad | Una capa supervisora atrapa la deriva de proceso y escala | Medio a alto | S2 |
| Harness engineering | Seguridad | Limita la información según su sensibilidad, resiste el hackeo y se ciñe al contexto dado | Bajo | S0 |
| Autoinspección | Seguridad | Revisa cada respuesta y acción en busca de divulgaciones y falta de autorización | Medio | S0 |
| Guardarraíl | Seguridad | El marco de gobernanza aplica límites de política a las acciones; detiene o escala | Medio a alto | S0, S2 |
| Diseño del espacio de trabajo | Seguridad | Controles de seguridad definidos por el negocio antes de dar información | Bajo | S0, S2 |
Preguntas frecuentes sobre IA fiable
¿Qué es la IA fiable?
La IA fiable es una IA de la que un negocio puede depender en producción. Tiene dos mitades: previsibilidad, que produzca de forma constante el resultado deseado, y seguridad, que la información y las acciones sensibles nunca se ejecuten por error.
¿Qué diferencia hay entre previsibilidad y seguridad en la IA?
La previsibilidad trata de hacer bien el trabajo siempre; sus fallos son salidas equivocadas o incoherentes, casi siempre recuperables (S1–S3). La seguridad trata de lo que no debe ocurrir nunca aunque el trabajo salga mal; sus fallos son divulgaciones o acciones que el negocio no puede deshacer (S0).
¿Qué es el harness engineering y en qué se diferencia de la ingeniería de prompts?
Un prompt es una instrucción para una llamada al modelo. El harness engineering diseña todo lo que rodea al modelo y da forma a su comportamiento: las instrucciones, el contexto que recibe y el que se le niega, las herramientas que puede usar, el orden de los pasos y los controles entre ellos. En la IA agéntica una ejecución puede generar de 12 a 20 tareas, así que la coherencia y la seguridad salen del harness, no de un prompt concreto.
¿Cómo se evita que un agente de IA filtre información sensible?
Mantener los datos sensibles fuera del contexto del agente hasta que superen sus controles, aplicar reglas de verificación definidas por el negocio en el espacio de trabajo, tratar el texto del usuario como datos y no como instrucciones, autoinspeccionar cada respuesta antes de publicarla y dejar que una capa de gobernanza detenga o escale todo lo que quede fuera de política.
¿Cómo se mide la fiabilidad de la IA?
Como tasa de error por gravedad sobre las conversaciones atendidas por la IA, en cuatro niveles: S0 cambia un resultado que el negocio no puede deshacer, S1 tiene impacto recuperable, S2 incumple una guía interna sin impacto y S3 es cosmético. Aissist.io se fija S0 por debajo del 0,01%, S1 por debajo del 0,1% y S0–S2 en conjunto por debajo del 1%. El método completo está en el AI Agent Reliability Benchmark 2026.
¿Puede una IA ser fiable al cien por cien?
No. Las cualidades que hacen útil a la IA —extenderse a casos nuevos y decidir con información incompleta— son las mismas que la hacen imprevisible, y la previsibilidad perfecta solo llega limitando la inteligencia. Lo que sí se puede diseñar es previsibilidad donde importa y controles de seguridad que mantengan los errores caros raros y contenidos.