
Atención al cliente con IA · Transparencia y evaluación
IA evaluable: no puedes desplegar lo que no puedes medir
Lo más difícil de desplegar IA no es conseguir que responda, sino demostrar que funciona. En nuestra propia revisión de los proveedores de esta categoría, aproximadamente el 90% no ofrecía ninguna evaluación real, o solo una etiqueta tosca como «éxito». Es nuestro recuento de nuestros propios competidores, no un estudio independiente: no hemos publicado la lista de proveedores ni los criterios, así que tómalo como una afirmación que hacemos y no como un hallazgo que puedas comprobar.
7 min de lectura · Actualizado en julio de 2026
Elaborado por Rob Jiang, ingeniero jefe de IA. Cifras leídas de sus fuentes el 24 de agosto de 2026. Publicado por Aissist.io, que vende un producto de la categoría aquí medida: nuestros propios despliegues aparecen entre las cifras y están identificados como nuestros.
- →Lo más difícil de desplegar IA no es conseguir que responda, sino demostrar que funciona. La IA evaluable es una IA que puedes ver por dentro, medir y mejorar.
- →En nuestra propia revisión de proveedores de soporte con IA —un recuento nuestro, no un estudio publicado—, aproximadamente el 90% no ofrecía ninguna evaluación real, o solo una etiqueta tosca de una única métrica como "éxito", así que los compradores no pueden distinguir una solución real de una suposición.
- →Mide con dos enfoques en cada conversación: basado en resultados (resolución, CSAT, ROI) y control de calidad basado en contenido (cumplimiento de políticas, mensajes correctos).
- →La puntuación de "brechas de intención" no es una evaluación real del contenido: mide tu taxonomía, no tu IA. Y como la IA ya forma parte del equipo, exígele la misma vara de medir que a tus agentes humanos.
La mayoría de las conversaciones de compra de IA se centran en lo que la IA puede hacer. La pregunta más difícil e importante es cómo sabrás que lo está haciendo bien. De eso trata la IA evaluable —una IA que puedes ver por dentro, medir y mejorar—, y se está convirtiendo rápidamente en el factor decisivo para que un despliegue de IA sobreviva al contacto con el mundo real.
Importa porque los fallos de la IA son silenciosos. Una integración rota lanza un error; una respuesta de la IA sutilmente errónea o fuera de política simplemente sale por la puerta, y te enteras semanas después por un cliente que se ha ido o por un incidente de cumplimiento. Sin una medición continua, vuelas a ciegas entre el momento del lanzamiento y el momento en que algo sale mal.
La cifra principal procede de la revisión propia de Aissist de los proveedores de soporte con IA; las cifras de control de calidad manual son de Solidroad. El listón que tiene que superar la IA evaluable es una cobertura del 100%: medir todo lo que hace la IA, de forma continua.
El verdadero reto
Transparencia y evaluación, no capacidad
El reto central del despliegue moderno de IA es la transparencia y la evaluación, y se descompone en cuatro preguntas que todo operador necesita responder. Si no puedes responderlas, no tienes un despliegue: tienes un riesgo funcionando en producción.
¿Cómo lo mides?
Define las métricas de antemano —resolución, CSAT, ROI, cumplimiento de políticas— y haz que se puedan calcular en cada conversación, no solo en una muestra.
¿Cómo sabes que funciona bien?
Contrasta las cifras con evidencias que se puedan inspeccionar. Si no puedes abrir la transcripción que hay detrás de un "resuelto", la métrica es una afirmación, no un hecho.
¿Dónde están las carencias?
Saca a la luz los modos de fallo de forma continua —respuestas fuera de política, mensajes erróneos, escalaciones no realizadas— para detectarlos en horas, no en semanas.
¿Cómo lo mejoras?
Cierra el ciclo: devuelve las carencias al sistema y vuelve a medir, para que la calidad se acumule en lugar de degradarse.
Sin embargo, un número sorprendente de soluciones lo hacen imposible por diseño. En nuestra propia revisión del mercado, aproximadamente nueve de cada diez proveedores no ofrecen ninguna evaluación o solo exponen una única métrica tosca: un recuento de «éxitos» o «resueltos» sin forma de inspeccionar qué se dijo, a quién ni por qué. Eso no es un producto; es un acto de fe. Y el mercado ha dejado de aceptarlo: «algoritmo propietario, confía en nosotros» ya no supera las compras enterprise, donde los equipos exigen cada vez más documentación de transparencia —reproducibilidad, registros de auditoría y supervisión humana— antes de firmar un contrato (Hrizn).
Lo que está en juego se amplifica por la poca visibilidad que tenían los equipos incluso antes de la IA: el control de calidad tradicional revisa manualmente solo el 1–2% de las interacciones y deja aproximadamente el 98% como una caja negra (Solidroad). La IA evaluable tiene que superar el statu quo, no heredar sus puntos ciegos, y eso significa puntuar el 100% de lo que hace la IA. Ese es justo el trabajo de una capa de análisis como Pulse™.
Dos enfoques
Las dos formas de medir la IA
La evaluación basada en resultados pregunta «¿consiguió el resultado?»; la basada en contenido pregunta «¿dijo lo correcto?». Un despliegue serio usa ambas: cada una es ciega a lo que ve la otra. Una IA puede cerrar un caso (buen resultado) citando por el camino una política de reembolsos equivocada (mal contenido).
¿Consiguió el resultado?
La tasa de resolución (¿resolvió realmente la IA la incidencia, o solo respondió?) y el CSAT (¿quedaron satisfechos los clientes?), y, por encima de ambos, el ROI: la resolución y la satisfacción sopesadas frente al coste. Las métricas de resultado son lo que cuenta al final: te dicen si la IA está generando valor de negocio.
- Tasa de resolución
- CSAT
- ROI (coste × resolución × satisfacción)
¿Dijo lo correcto?
Control de calidad clásico sobre el fondo de cada respuesta: ¿cumplió la política, generó el mensaje correcto, se mantuvo precisa y fiel a la marca, y evitó decir algo que no debía? Detecta lo que los resultados pasan por alto: una IA puede cerrar un caso citando por el camino una política de reembolsos equivocada.
- Cumplimiento de políticas
- Corrección de los mensajes
- Precisión y tono
La clave es que ambas se apliquen a todas las conversaciones, no a una muestra. La evaluación con cobertura completa es la diferencia entre gestionar con evidencias y gestionar a ciegas. Para profundizar, consulta cómo medir el verdadero ROI de la IA agéntica y el equilibrio entre resolución y CSAT.
Una trampa habitual
Por qué la puntuación de «brechas de intención» no es una evaluación real del contenido
Aquí es donde muchas soluciones se equivocan. Muchas miden una brecha de intención —con qué frecuencia el sistema no logró asociar un enunciado a una intención conocida— y la presentan como evaluación basada en contenido. No lo es, o como mucho es un indicador débil.
El problema es que la puntuación de brechas de intención solo tiene sentido en relación con la estructura de tus intenciones. Si tu taxonomía es gruesa, la IA parece excelente; si es granular, la misma IA parece peor: estás midiendo el mapa, no el territorio. Peor aún, la intención es en sí misma una simplificación excesiva de la atención al cliente. Los casos reales están entrelazados, son ambiguos y tienen varias partes: una sola conversación puede abarcar a la vez un defecto, una pregunta sobre la garantía y una política de reembolsos, y nada de eso se reduce limpiamente a una única «intención».
La verdadera evaluación del contenido examina la respuesta en sus propios términos —precisión, cumplimiento de políticas, exhaustividad, tono— frente a la situación real, no frente a si un clasificador encontró la etiqueta correcta. Es una medición fundamentalmente distinta y más honesta, y por eso apoyarse en las métricas de brechas de intención da una falsa confianza.
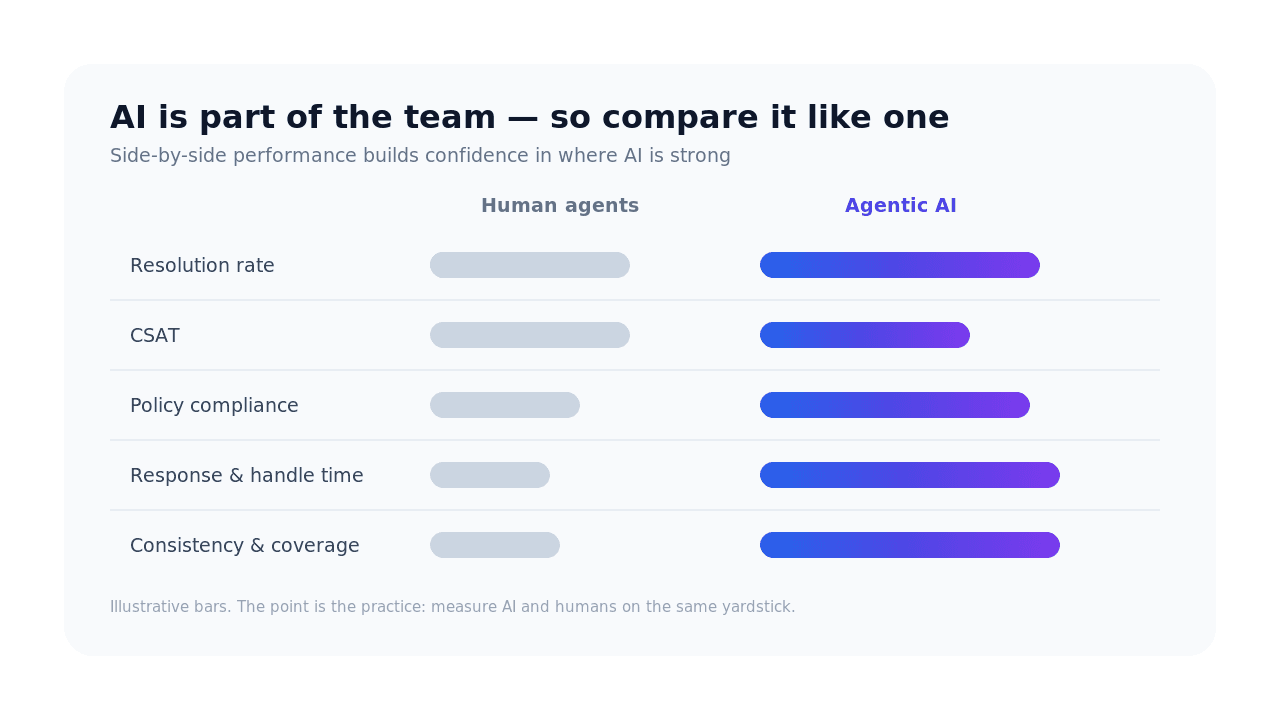
Pon a la IA y a los agentes humanos en el mismo cuadro de mando y el panorama se aclara rápido: dónde la IA iguala o supera a tus agentes y dónde un humano debería seguir siendo el responsable del caso.
La vara de medir humana
Compara tu IA con tus agentes humanos
Hay una evaluación más que cambia la forma en que los líderes piensan en la IA: compararla cara a cara con tus agentes humanos. Pon a la IA y a los agentes humanos en el mismo cuadro de mando —tasa de resolución, CSAT, cumplimiento de políticas, tiempo de gestión, consistencia— y verás con precisión dónde la IA iguala o supera a tus agentes y dónde todavía necesita a un humano. Eso sustituye la ansiedad y el bombo por evidencias, para que puedas asignar el trabajo en consecuencia: deja que la IA se encargue de lo que demostrablemente hace bien y reserva el criterio humano para el resto.
Este enfoque también desactiva la política interna de la adopción de IA. Cuando la IA se mide con la misma vara que todos los demás, deja de ser una misteriosa caja negra acoplada a la organización y se convierte en un compañero de equipo con un historial conocido e inspeccionable. La comparación continua —y la mejora continua de las carencias que revela— es el ciclo que un sistema como Evolve™ está diseñado para cerrar, y solo funciona sobre una base de IA fiable y transparente.
Diligencia debida
Qué preguntar a tu proveedor
Antes de fiarte de cualquier cifra de rendimiento de la IA, consigue estas respuestas por escrito:
¿Podemos ver las conversaciones reales de la IA, todas y no una muestra escogida?
¿Está verificada la "resolución", o es una etiqueta autodeclarada sin ninguna transcripción detrás?
¿Evaluáis el contenido, no solo el resultado: el cumplimiento de políticas y la corrección del mensaje en cada respuesta?
¿Vuestra puntuación de "contenido" es en realidad una puntuación de brechas de intención, que mide nuestra taxonomía en lugar de vuestra IA?
¿Qué parte de las interacciones puntuáis: el 100% o una muestra, como el control de calidad manual heredado?
¿Podemos comparar la IA con nuestros agentes humanos en el mismo cuadro de mando y con las mismas métricas?
Preguntas frecuentes
Preguntas frecuentes
¿Qué es la IA evaluable?+
La IA evaluable es una IA que puedes ver por dentro, medir y mejorar: cada conversación es visible para la empresa, el rendimiento se cuantifica con métricas claras, las carencias salen a la luz de forma continua y hay un camino definido para mejorarla. Es lo contrario de un despliegue de caja negra que comunica una cifra de titular sin dejarte inspeccionar lo que la IA hizo realmente.
¿Por qué es importante la transparencia de la IA en la atención al cliente?+
Porque los fallos de la IA son silenciosos: una respuesta errónea o fuera de política simplemente se envía, y te enteras más tarde por un cliente perdido o un problema de cumplimiento. La transparencia te permite inspeccionar qué dijo la IA y por qué, detectar problemas a tiempo y satisfacer a compras y a los reguladores. En el mercado actual, "confía en nosotros, es propietario" ya no supera una revisión enterprise, que cada vez exige más registros de auditoría y supervisión humana.
¿Cómo se mide si una IA funciona bien?+
Usa dos enfoques complementarios en cada conversación. Las métricas basadas en resultados —tasa de resolución, CSAT y ROI (que combina el coste con la resolución y la satisfacción)— te dicen si la IA genera valor de negocio. El control de calidad basado en contenido —cumplimiento de políticas, corrección de los mensajes, precisión y tono— te dice si está diciendo lo correcto. Una IA puede lograr un buen resultado equivocándose en el contenido, así que necesitas ambos.
¿Qué diferencia hay entre la evaluación de la IA basada en resultados y la basada en contenido?+
La evaluación basada en resultados pregunta "¿consiguió el resultado?" y mide la tasa de resolución, el CSAT y el ROI. La evaluación basada en contenido pregunta "¿dijo lo correcto?" e inspecciona cada respuesta en cuanto a cumplimiento de políticas, precisión y corrección, más cerca del control de calidad tradicional. Las métricas de resultado muestran el impacto en el negocio; las de contenido detectan problemas de calidad que las cifras de resultado pueden ocultar. Los despliegues serios usan ambas.
¿Es la puntuación de brechas de intención una buena forma de evaluar la IA?+
No por sí sola. La puntuación de brechas de intención mide con qué frecuencia el sistema no logró asociar un mensaje a una intención conocida, pero el resultado depende por completo de cómo estén estructuradas tus intenciones: las taxonomías gruesas favorecen a la IA y las granulares la penalizan. La intención también simplifica en exceso la atención al cliente, donde los casos reales están entrelazados y tienen varias partes. Mide tu taxonomía, no si la IA atendió de verdad al cliente.
¿Por qué solo se revisa el 1–2% de las interacciones en el control de calidad tradicional?+
El control de calidad manual está limitado por las personas: los analistas solo pueden escuchar o leer una fracción mínima de las conversaciones, así que la mayoría de los programas muestrean solo el 1–2% de las interacciones y dejan aproximadamente el 98% sin revisar. Ese muestreo crea puntos ciegos y obliga a tomar decisiones a ciegas. La IA evaluable lo resuelve puntuando automáticamente el 100% de las interacciones con criterios coherentes.
¿Cómo debo comparar el rendimiento de la IA con el de mis agentes humanos?+
Ponlos en el mismo cuadro de mando y mídelos igual: tasa de resolución, CSAT, cumplimiento de políticas, tiempo de gestión y consistencia. Como la IA ya forma parte del equipo, evaluarla con la vara de medir del equipo muestra exactamente dónde iguala o supera a tus agentes y dónde siguen haciendo falta humanos. Esa evidencia te permite asignar el trabajo con confianza y mejorar las carencias concretas que revela la comparación.
¿Se puede evaluar la IA sin ver sus conversaciones?+
No: esa es la definición de una caja negra. Si una solución no muestra a la empresa las conversaciones reales de la IA, no puedes verificar las afirmaciones de resolución, hacer control de calidad del contenido, detectar infracciones de políticas ni mejorar nada. La visibilidad completa de cada interacción es la base de la IA evaluable; cualquier métrica que se ofrezca sin ella debe tratarse como no verificada.
Ve, mide y mejora cada conversación de la IA.
Aissist.io está diseñado para ser evaluable: cada interacción visible, puntuada por resultado y por contenido, y comparada con tus agentes humanos con una única vara de medir honesta, con Pulse para el análisis y Evolve para la mejora continua.
Por qué automatizar más puede hacer que los clientes estén más descontentos, y cómo lo rompe una medición honesta.
Tasa de resolución, CSAT y coste en 6 sectores, con cifras declaradas frente a verificadas.
Por interacción, por sesión, por resolución: normalizado al coste por incidencia resuelta.
La cifra de ~90% procede de la revisión propia de Aissist de los proveedores de soporte con IA —nuestros competidores—, y no hemos publicado la lista de proveedores, el tamaño de la muestra ni los criterios de puntuación. Refleja cuán pocos proveedores exponen una evaluación real e inspeccionable, y es una afirmación que hacemos sobre nuestro propio mercado, no un hallazgo auditado. Las cifras de control de calidad manual (1–2% revisado / ~98% sin revisar) son de Solidroad. Las cifras de producto son propias de Aissist; los resultados individuales varían según la mezcla de canales, la complejidad de las intenciones y cómo define cada equipo una resolución.