La evolución de la base de conocimiento: de los grafos de conocimiento a las skills y los subagentes
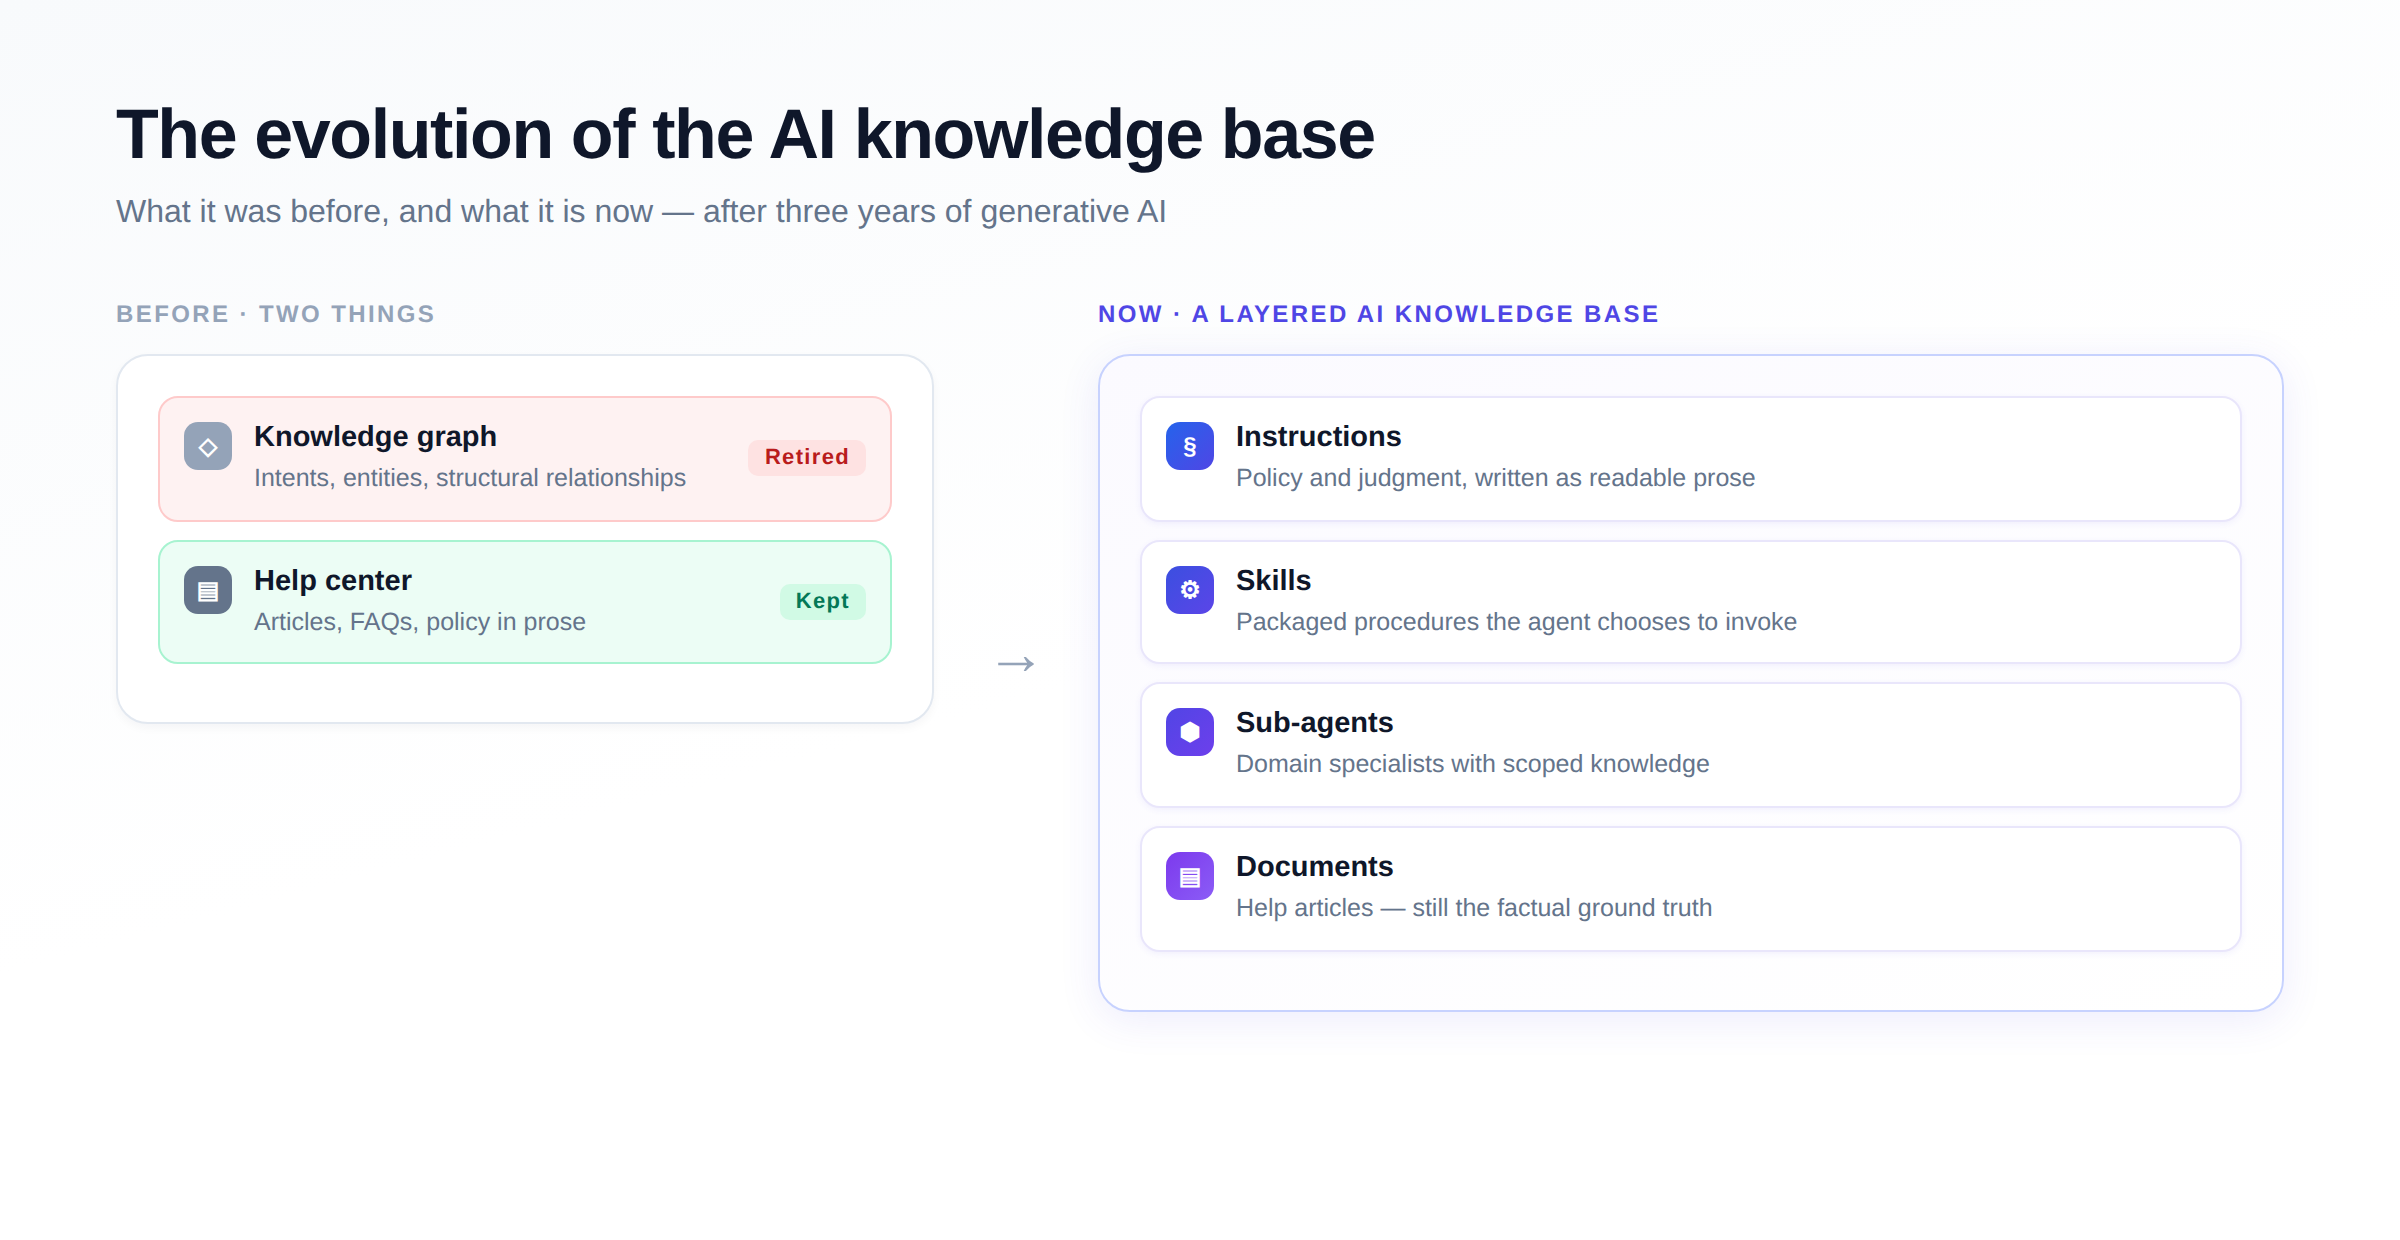
La evolución de la base de conocimiento es el ejemplo más claro de cuánto ha cambiado la IA generativa la fontanería que hay debajo de la atención al cliente. Durante veinte años, «base de conocimiento» significó dos cosas distintas a la vez: un grafo de conocimiento de intenciones, entidades y relaciones estructuradas que le decía a un bot qué quería decir un cliente, y un centro de ayuda de artículos y preguntas frecuentes que le decía al cliente qué hacer. En los tres años transcurridos desde la llegada de la IA generativa, uno de los dos ha sobrevivido y el otro no. Los artículos de ayuda son tan útiles como siempre. El grafo de conocimiento se ha retirado discretamente, y lo que lo ha sustituido no es un grafo mejor. Son las instrucciones, las skills y los subagentes. Si hoy estás construyendo una base de conocimiento con IA, esa distinción determina la mayor parte de tu trabajo.
¿Qué es una base de conocimiento?
Una base de conocimiento es el conjunto organizado de información al que recurre un sistema o una persona para responder preguntas y completar tareas. En atención al cliente, tradicionalmente ha abarcado dos activos distintos: el centro de ayuda orientado al cliente y la estructura orientada a la máquina que permitía al software interpretar una solicitud.
Siempre fueron dos cosas distintas que hacían trabajos distintos. Confundirlas es la razón por la que tantos equipos dicen hoy «tenemos una base de conocimiento» y obtienen resultados muy diferentes de su IA.
Las dos cosas que antes significaba «base de conocimiento»
1. El grafo de conocimiento: conocimiento estructural
La mitad orientada a la máquina. Un mapa de intenciones (lo que quiere el cliente: track_order, request_refund), entidades (el número de pedido, el SKU, la fecha) y las relaciones entre ellas. A veces un auténtico grafo; otras, una taxonomía con un flujo asociado.
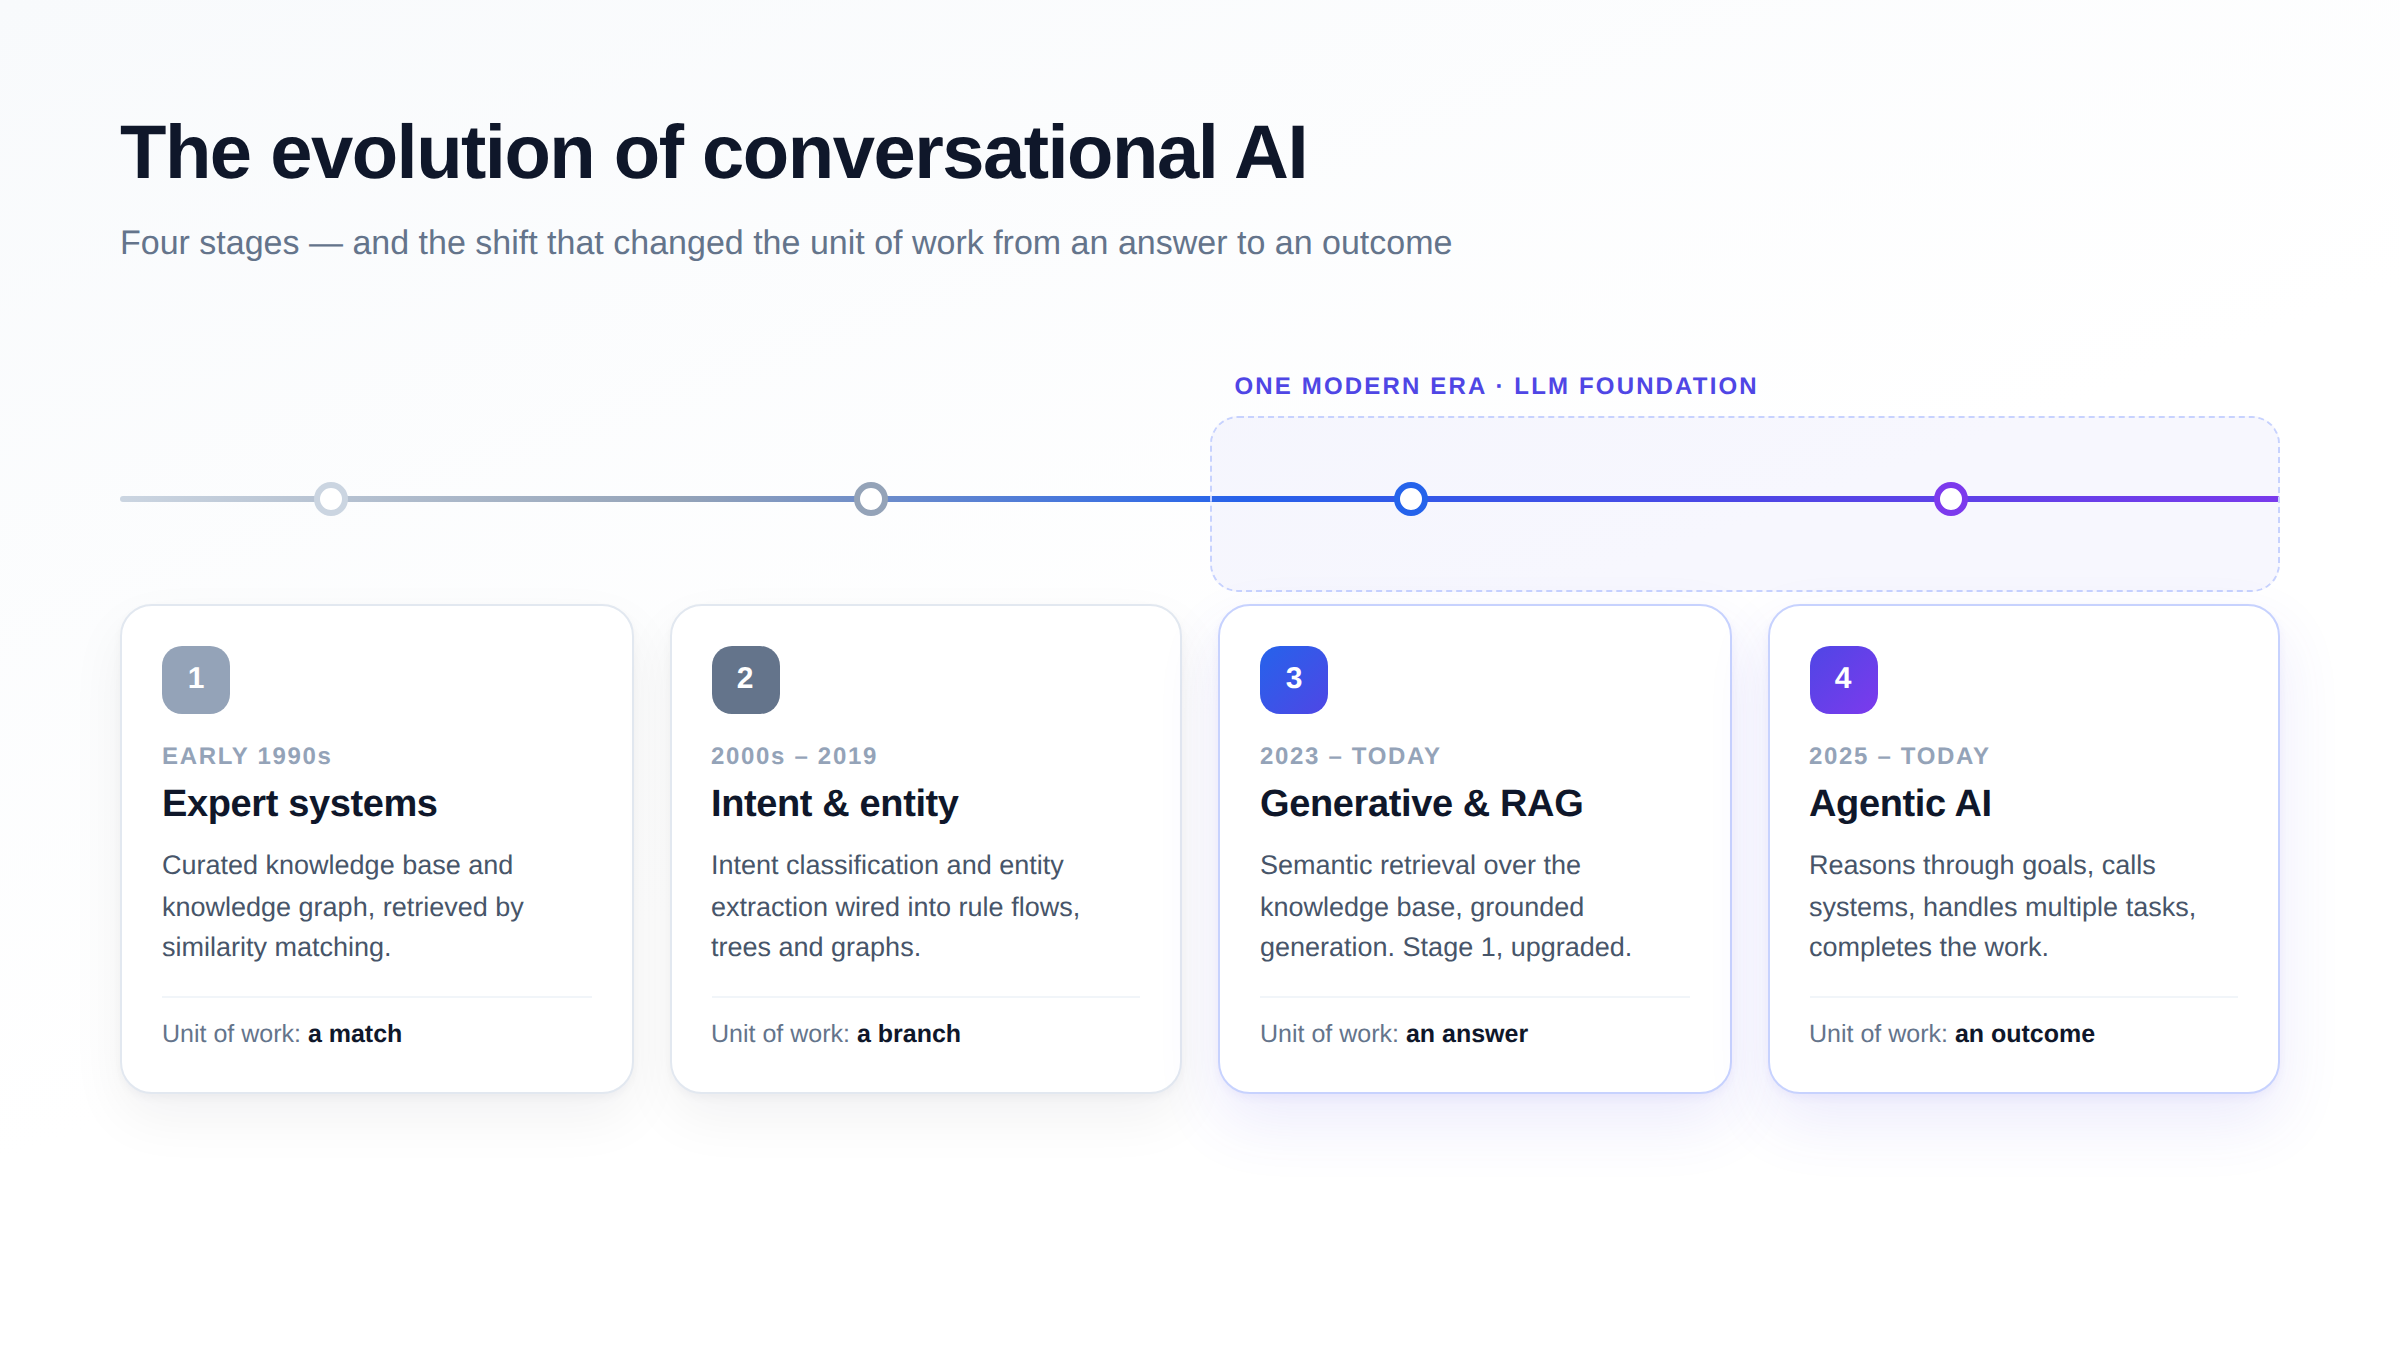
Su propósito era la interpretación. No existían modelos de lenguaje capaces de leer un mensaje, así que el grafo daba al software una estructura finita sobre la que mapear los mensajes. Curarlo —definir intenciones, etiquetar enunciados de entrenamiento, trazar las ramas— era un trabajo considerable y permanente. Es la arquitectura que tratamos como etapa 2 en la evolución de la IA conversacional.
2. El centro de ayuda: artículos y preguntas frecuentes
La mitad orientada a las personas. Orientaciones por escrito: cómo funcionan las devoluciones, qué cubre la garantía, cómo restablecer una contraseña. Las escribían los equipos de soporte y de contenidos, las leían los clientes y, cada vez más, los agentes que necesitaban consultar algo.
Su propósito era la explicación. Transmitía hechos y políticas en prosa.
Cómo ha evolucionado la base de conocimiento en tres años
Los modelos generativos saben leer. Esa única capacidad eliminó la razón de ser del grafo de conocimiento.
Un LLM no necesita que un mensaje se mapee sobre un conjunto finito de intenciones para entenderlo: lee el mensaje directamente, incluidas formulaciones con las que el grafo nunca se entrenó, dos solicitudes en una misma frase y el contexto de mensajes anteriores del hilo. La capa de interpretación que costaba trimestres construir y que nunca dejaba de necesitar mantenimiento se volvió redundante casi de la noche a la mañana.
Los artículos de ayuda, en cambio, ganaron más valor. Su contenido —los hechos y las políticas reales— es exactamente lo que un modelo necesita para mantenerse fundamentado y dejar de inventarse cosas. La prosa escrita para personas resultó ser una entrada excelente para la máquina.
Así que el grafo de conocimiento no perdió frente a un grafo mejor. Perdió porque el modelo absorbió todo su trabajo: convertir el lenguaje en estructura.
Por qué se retiró el grafo de conocimiento
Tres razones, ordenadas según su peso:
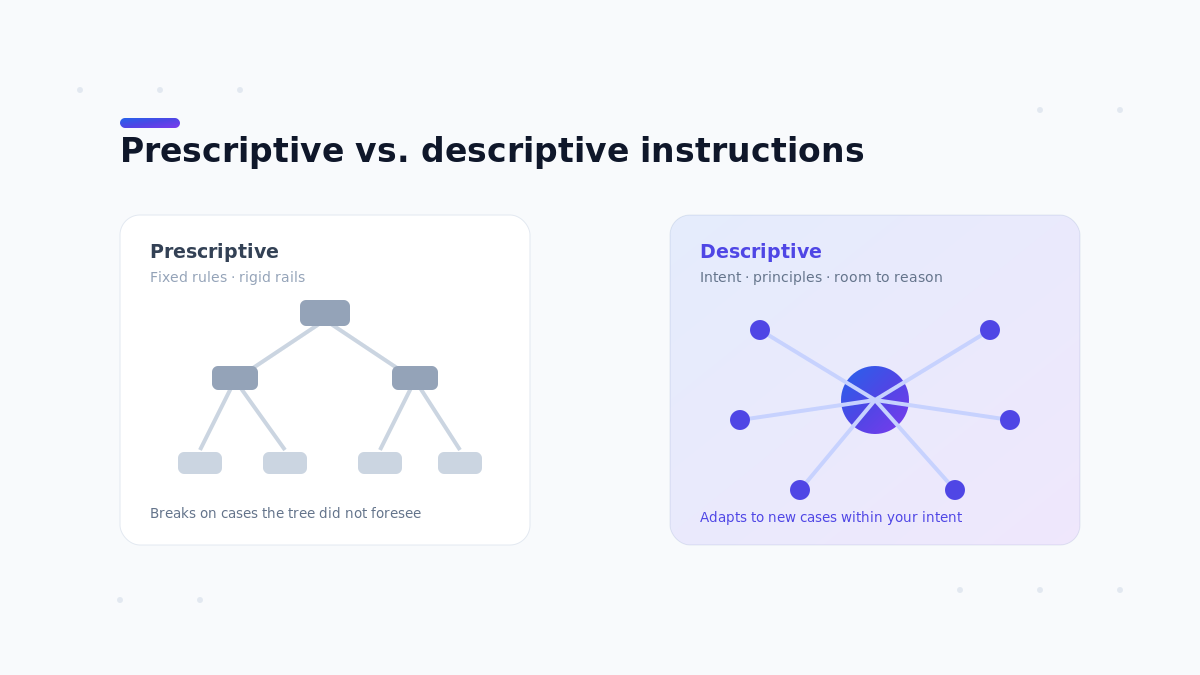
Resolvía un problema que ya no existe. La clasificación de intenciones era un apaño para máquinas que no sabían leer. En cuanto aprendieron, mantener una estructura paralela para describir el significado pasó a ser pura sobrecarga.
Ponía techo a la resolución. Las intenciones son un conjunto cerrado; las solicitudes de los clientes son un conjunto abierto. Cada mensaje real que quedaba fuera de la taxonomía se enrutaba mal, y la solución —más intenciones, más ramas— aumentaba las colisiones y el coste de mantenimiento. La cobertura y la mantenibilidad tiraban permanentemente en direcciones opuestas.
Codificaba la capa equivocada. Un grafo describe qué significa un mensaje. Apenas dice nada sobre qué hacer: la política, el criterio, las excepciones. Ese conocimiento vivía en condiciones de reglas dispersas por las ramas, donde era casi imposible leerlo o auditarlo como un todo coherente.
Una salvedad que conviene dejar clara: los grafos de conocimiento no están muertos como tecnología. Siguen siendo realmente útiles para el modelado de datos empresariales, la búsqueda y los dominios con muchas relaciones. Lo que se ha retirado es su papel como capa de interpretación de la IA conversacional.
Qué lo ha sustituido: la base de conocimiento con IA moderna
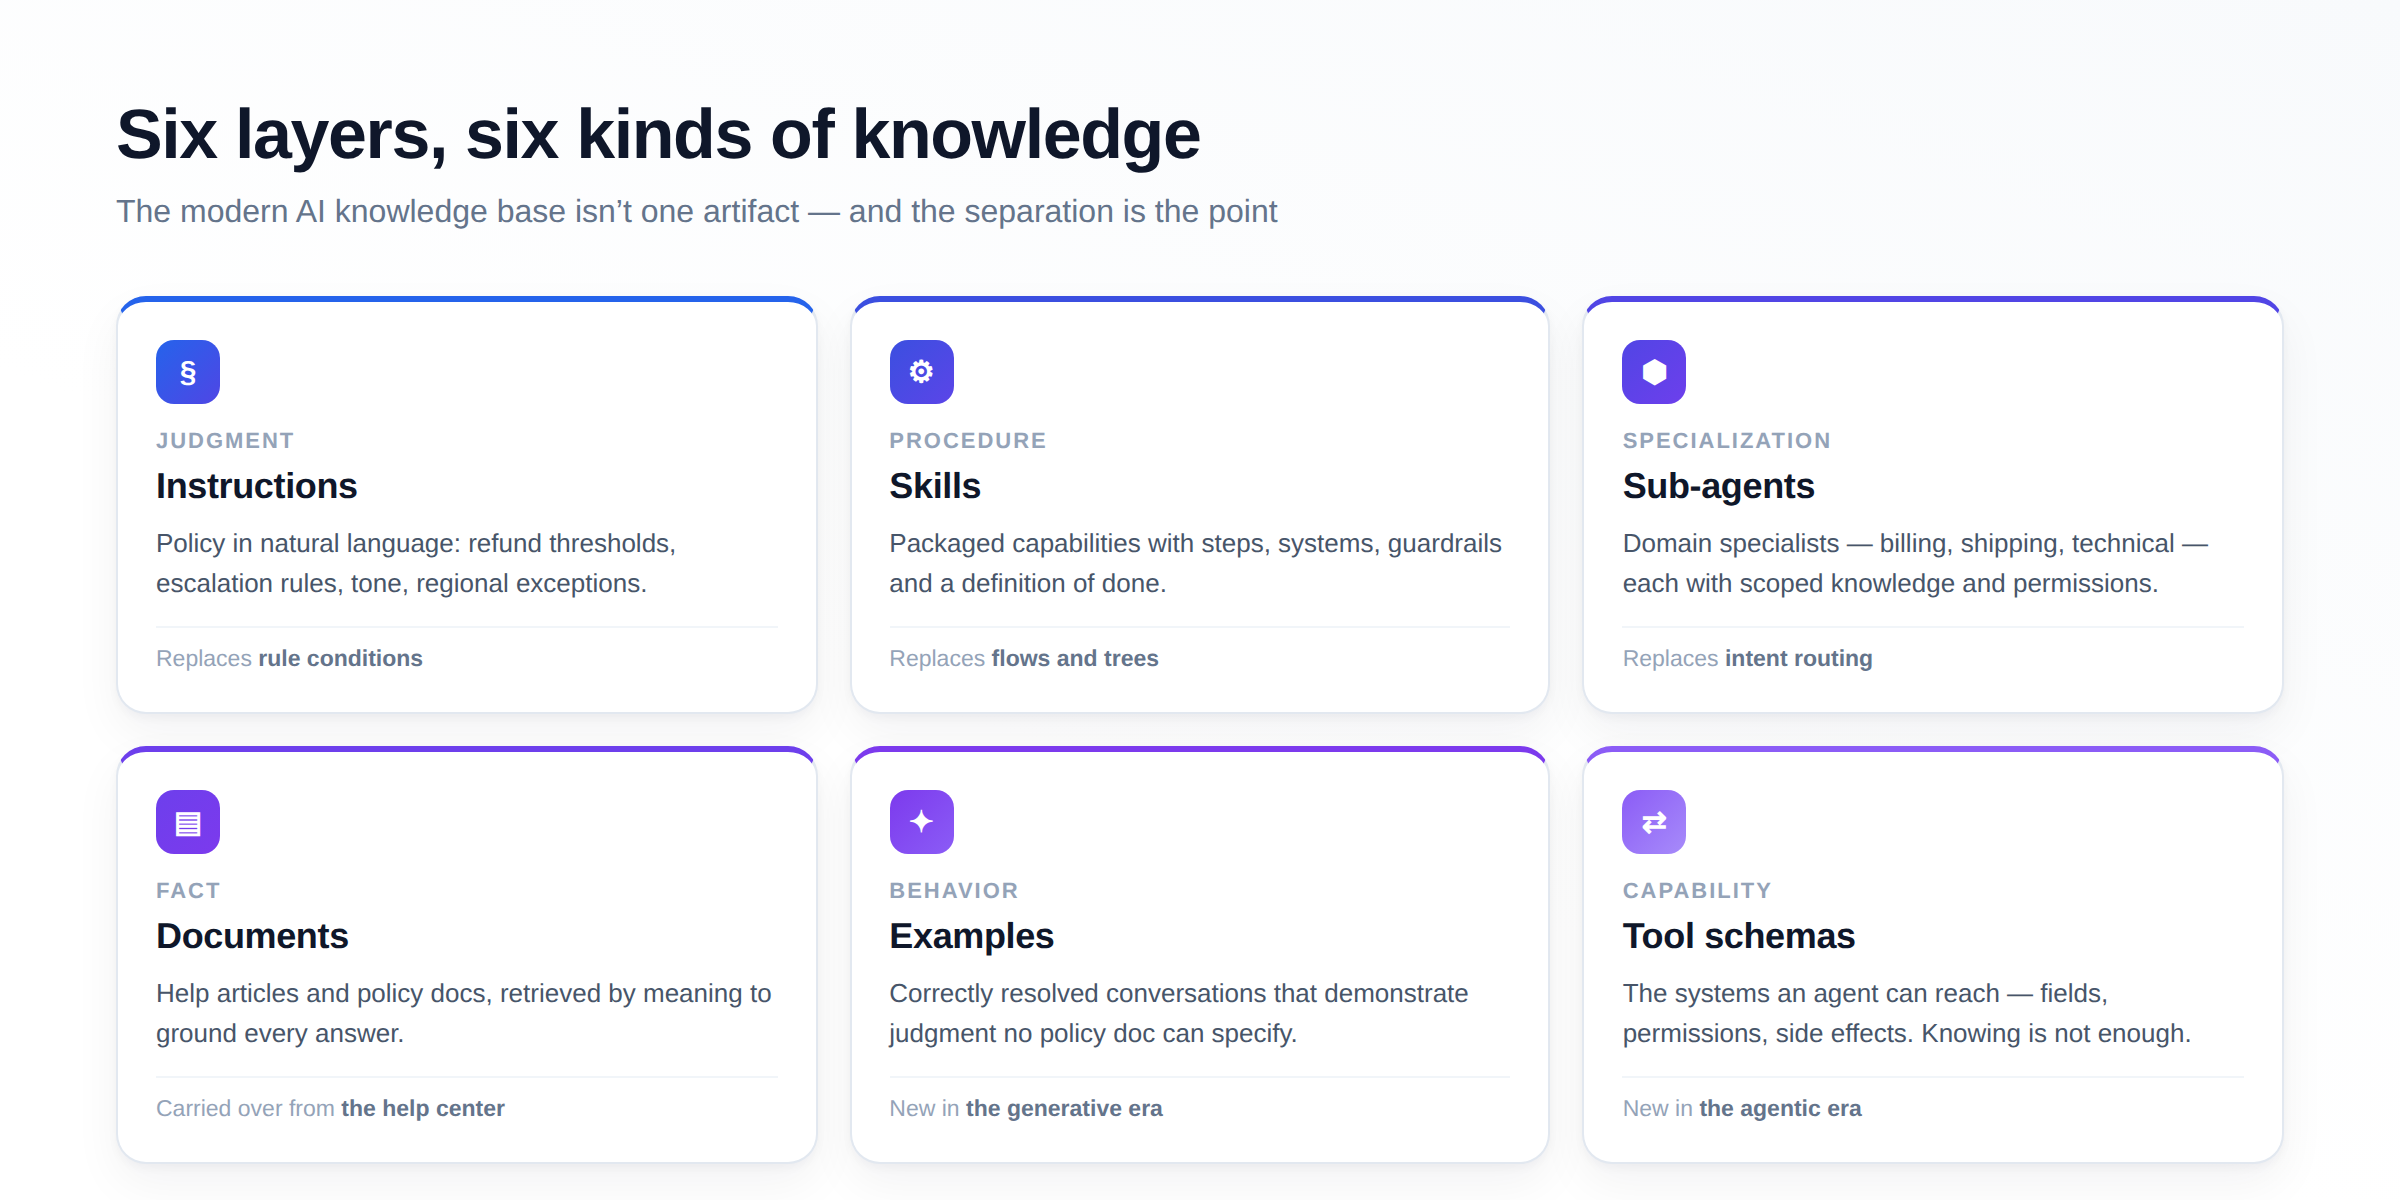
La nueva base de conocimiento no es un único artefacto. Son varios, cada uno con un tipo de conocimiento distinto, y esa división es precisamente la clave.
Instrucciones: el conocimiento operativo
Las instrucciones son políticas y procedimientos en lenguaje natural escritos para el agente. Cuándo emitir un reembolso sin aprobación y cuándo escalar. Cómo verificar la identidad. Qué no prometer nunca. Qué excepciones se aplican en cada región. Qué tono mantener cuando un cliente está enfadado.
Es el conocimiento que antes estaba enterrado en condiciones de reglas repartidas por cien ramas, ahora escrito como prosa legible en un solo lugar. De ello se derivan dos consecuencias. Primero, es auditable: un responsable puede leer la política con la que opera la IA y saber si es correcta. Segundo, es editable por quienes son dueños de la política: responsables de soporte y de operaciones, no ingenieros. Cambiar un umbral de reembolso pasa a ser editar una frase en lugar de abrir un ticket. Escribirlas bien es una habilidad en sí misma; lo tratamos en cómo escribir buenas instrucciones para la IA generativa.
Skills: el conocimiento procedimental
Una skill es un procedimiento empaquetado y repetible que el agente puede invocar: los pasos que implica, los sistemas que toca, las entradas necesarias, los guardarraíles que lo rodean y la definición de terminado. «Procesar una devolución». «Verificar la identidad». «Aplicar un descuento retroactivo». «Redirigir un envío».
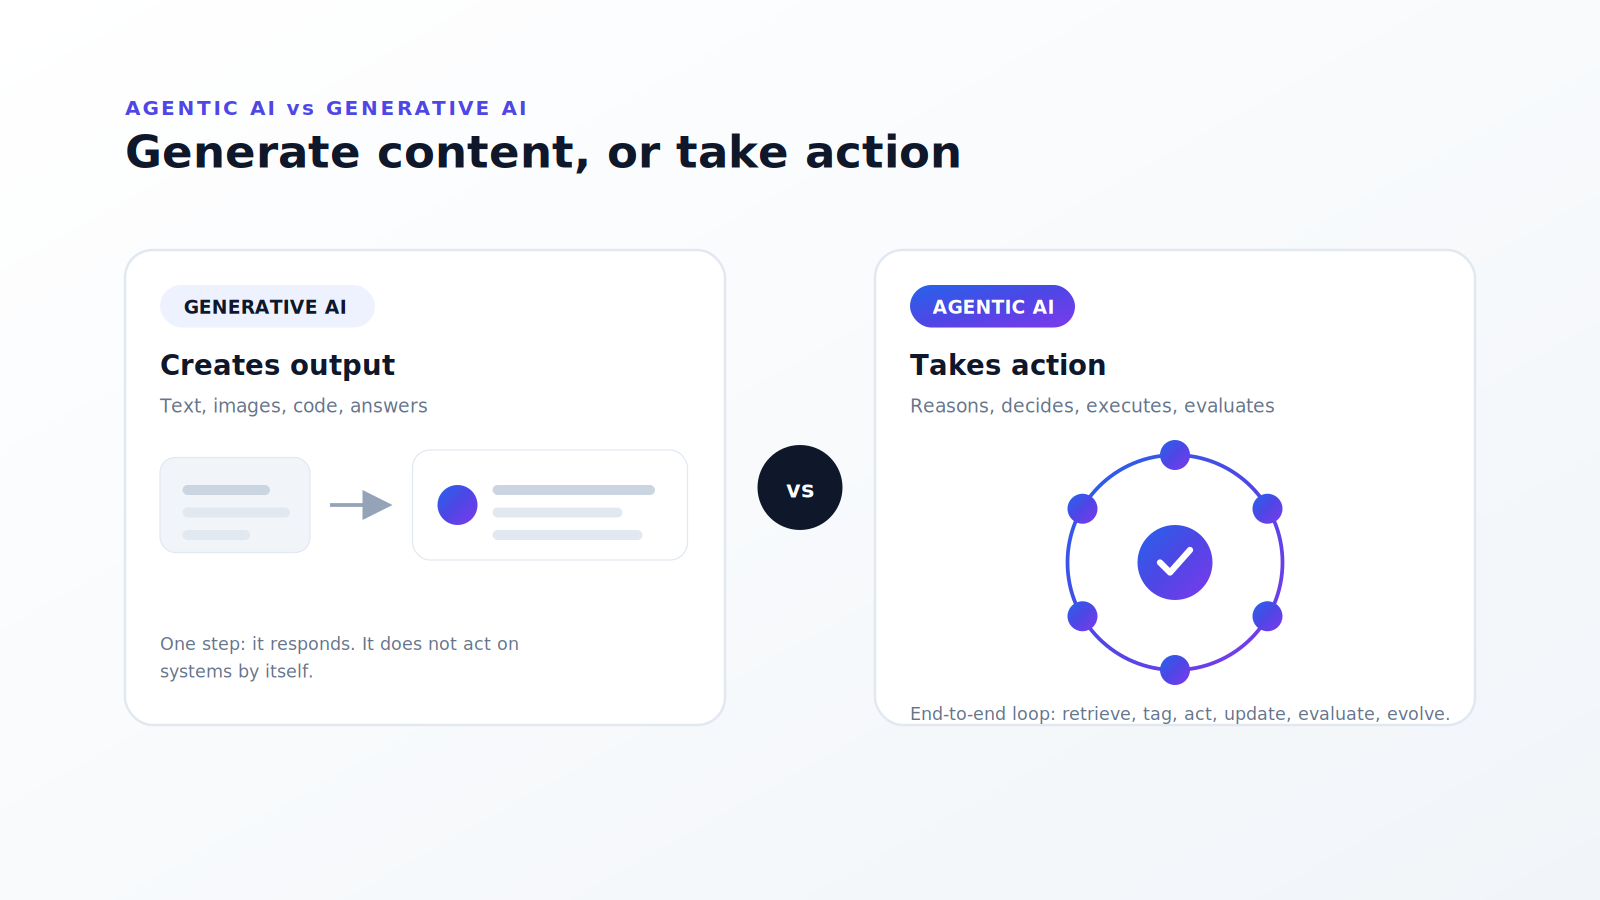
La diferencia con un flujo es quién tiene el control. Un flujo era un camino fijo por el que se arrastraba al sistema. Una skill es una capacidad que el agente decide usar cuando su razonamiento indica que hace falta, y puede encadenar varias en una misma conversación, en un orden que nadie ha guionizado de antemano. Eso es lo que permite que un único mensaje con tres solicitudes dependientes se resuelva de verdad en lugar de enrutarse mal.
Subagentes: el conocimiento especializado
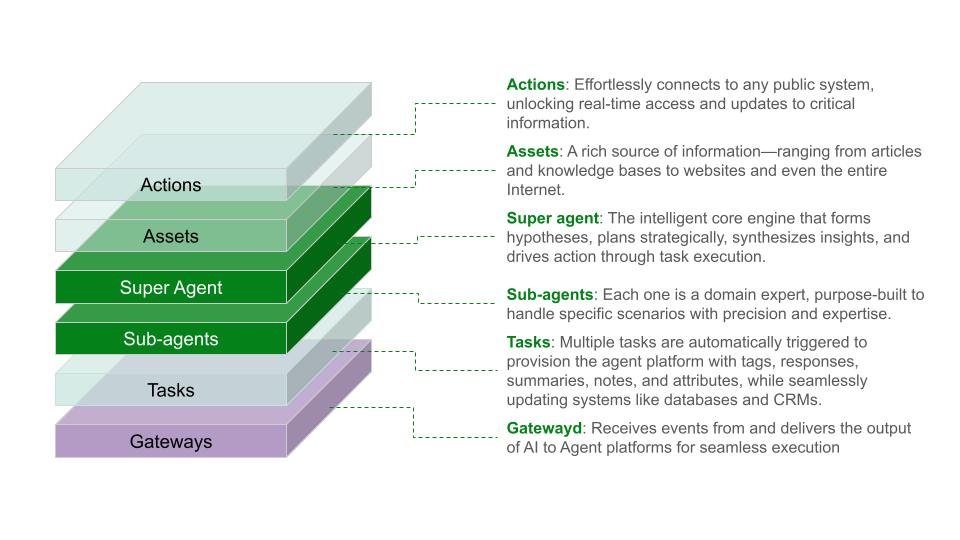
En lugar de que un único modelo lo contenga todo, el trabajo se reparte entre agentes especializados: un agente de facturación, un agente de envíos, un agente de soporte técnico, un agente de ventas. Cada uno tiene sus propias instrucciones, sus propias skills y sus propios permisos, coordinados por una capa de orquestación que enruta y delega.
Es conocimiento organizado por responsabilidad y no por tema, y es el sustituto estructural directo del enrutamiento por intenciones. Además, escala en la dirección contraria a un grafo: añadir un dominio significa añadir un agente con su propio conocimiento acotado, no añadir doscientas intenciones que colisionan con la taxonomía existente. Esta es la arquitectura que hay detrás de AgentMesh™ y de la plataforma multiagente en su conjunto.
Documentos: siguen siendo la verdad factual de referencia
Artículos de ayuda, documentos de políticas, especificaciones de producto, tickets anteriores. Es la parte que pasó directamente del mundo antiguo, con un cambio: se recupera por significado en lugar de emparejarse por palabras clave, y se usa para fundamentar la generación en lugar de servirse literalmente.
Su trabajo es ahora más acotado y más importante. Los documentos aportan hechos. Las instrucciones aportan criterio. Mantenerlos separados es lo que impide que un agente trate un artículo de ayuda desactualizado como una política vinculante.
Ejemplos: el conocimiento conductual
Realmente nuevo, y fácil de pasar por alto. Las conversaciones pasadas que se resolvieron correctamente funcionan como conocimiento: muestran el tono, el momento de la escalación y el criterio de una forma que ningún documento de políticas recoge. Una buena escalación es más fácil de mostrar que de especificar.
Esquemas de herramientas y sistemas: el conocimiento de capacidades
Lo que un agente puede hacer forma parte de lo que sabe. Las definiciones de los sistemas a los que puede acceder —los campos, los permisos, los efectos secundarios de cada llamada— forman parte de la base de conocimiento moderna tanto como cualquier artículo, porque un agente que no puede actuar sobre un hecho solo puede contárselo al cliente.
Los artículos de ayuda no han muerto: ha cambiado su función
Conviene ser explícitos, porque aquí es donde los equipos se pasan de frenada. Los artículos de ayuda siguen siendo uno de los activos con más palanca del soporte. Lo que ha cambiado:
Ya no tienen que ser exhaustivos, porque el modelo puede componer una respuesta a partir de varias fuentes en lugar de necesitar un artículo por cada forma de formular una pregunta. Ya no tienen que redactarse como buscan los clientes, porque la recuperación es semántica. Y ya no son lo único que mantienes: son una entrada entre varias.
El error que hay que evitar: tratar tu centro de ayuda como toda tu base de conocimiento con IA. Contiene hechos, no criterio. Una IA fundamentada solo en artículos de ayuda puede explicar con precisión tu política de devoluciones y aun así no tener ni idea de cuándo puede hacer una excepción.
Qué significa esto para mantener una base de conocimiento
El trabajo de mantenimiento ha cambiado de forma. Curar intenciones y etiquetar enunciados ha desaparecido. En su lugar:
Escribe políticas, no ramas. El trabajo de más valor ahora es redactar instrucciones operativas claras y mantenerlas al día a medida que cambian las políticas.
Separa los hechos del criterio. Mantén los documentos factuales y las instrucciones decisorias. Mezclarlos produce un agente incapaz de distinguir qué es vinculante.
Retroalimenta los fallos. Las escalaciones y los errores son la mejor señal que tienes de lo que le falta a la base de conocimiento: una laguna en las instrucciones, una skill que falta o un documento ambiguo. Los sistemas diseñados para la mejora continua cierran ese bucle de forma deliberada en lugar de esperar a una auditoría trimestral.
Audita aquello con lo que la IA opera realmente. Con instrucciones en prosa, por fin es posible. Léelas como leerías el documento de formación de una nueva incorporación.
Conclusiones clave
La evolución de la base de conocimiento va en una sola dirección. Antes significaba un grafo de conocimiento de intenciones y entidades más un centro de ayuda de artículos. La IA generativa retiró el grafo, no sustituyéndolo por uno mejor, sino absorbiendo su trabajo, ya que un modelo que lee no necesita que el lenguaje venga mapeado de antemano en una estructura. Los artículos de ayuda sobrevivieron y ahora importan más, como base factual. Lo que realmente sustituyó al grafo es una base de conocimiento con IA por capas: instrucciones con la política y el criterio, skills con los procedimientos, subagentes con la especialización, documentos con los hechos, ejemplos con el comportamiento y esquemas de herramientas con las capacidades. El trabajo de mantenimiento pasó de etiquetar enunciados a redactar políticas claras, una tarea que corresponde a los equipos de operaciones y no a los ingenieros.
¿Quieres ver cómo es una base de conocimiento con IA en producción? Mira cómo la IA agéntica resuelve casos reales usando tu contenido de ayuda actual y tus políticas. Reserva una demo gratuita →
Preguntas frecuentes
¿Qué es una base de conocimiento con IA?
Una base de conocimiento con IA es el conjunto completo de conocimiento al que recurre un agente de IA para resolver solicitudes. Va más allá de los documentos e incluye instrucciones (políticas y criterio escritos en lenguaje natural), skills (procedimientos empaquetados que el agente puede invocar), subagentes (especialistas de dominio con su propio conocimiento acotado), ejemplos de casos resueltos correctamente y los esquemas de los sistemas en los que el agente puede actuar.
¿Una base de conocimiento es lo mismo que un centro de ayuda?
No. Un centro de ayuda es contenido orientado al cliente: artículos y preguntas frecuentes que explican cómo funcionan las cosas. Una base de conocimiento es más amplia: incluye ese contenido más el conocimiento orientado a la máquina que un sistema necesita para interpretar las solicitudes y actuar sobre ellas. Muchos equipos usan los términos indistintamente, y por eso «tenemos una base de conocimiento» dice tan poco sobre lo bien que funcionará su IA.
¿Se siguen usando los grafos de conocimiento en la IA de atención al cliente?
Rara vez como capa de interpretación. Su función original —mapear el lenguaje sobre un conjunto fijo de intenciones y entidades— se volvió redundante con modelos que leen el lenguaje directamente. Los grafos de conocimiento siguen siendo realmente útiles para el modelado de datos empresariales, la búsqueda y los dominios con muchas relaciones, pero mantener uno para clasificar mensajes de soporte es hoy, en gran medida, sobrecarga.
¿Qué son las instrucciones en una base de conocimiento con IA?
Las instrucciones son políticas y procedimientos en lenguaje natural escritos para el agente: cuándo reembolsar sin aprobación, cómo verificar la identidad, qué no prometer nunca, qué excepciones regionales se aplican, qué tono mantener. Sustituyen a la lógica que antes estaba dispersa en condiciones de reglas y ramas de árboles de decisión y, al estar en prosa, quienes son dueños de la política pueden leerlas y editarlas directamente.
¿Qué diferencia hay entre las skills y los flujos?
Un flujo es un camino fijo, definido de antemano, por el que se arrastra al sistema. Una skill es una capacidad que el agente decide invocar cuando su razonamiento determina que hace falta, con pasos, sistemas, guardarraíles y una definición de terminado. La diferencia práctica es que un agente puede encadenar varias skills en una misma conversación, en un orden que nadie ha guionizado, y eso es lo que hace resolubles las solicitudes con varias tareas.
¿Qué son los subagentes?
Los subagentes son agentes de IA especializados, cada uno responsable de un dominio —facturación, envíos, soporte técnico, ventas—, con sus propias instrucciones, skills y permisos, coordinados por una capa de orquestación. Son el sustituto estructural del enrutamiento por intenciones y escalan mejor: añadir un dominio significa añadir un agente acotado en lugar de añadir intenciones que colisionan con una taxonomía existente.
¿Sigo necesitando artículos de ayuda si tengo un agente de IA?
Sí. Los artículos de ayuda son la base factual que mantiene preciso a un agente en lugar de que se invente respuestas. Lo que ha cambiado es que ya no necesitan ser exhaustivos ni redactarse como buscan los clientes, porque la recuperación es semántica y el modelo puede componer a partir de varias fuentes. Aportan hechos, pero no criterio, que es para lo que sirven las instrucciones.
¿Cómo construyo una base de conocimiento con IA?
Empieza por los documentos que ya tienes: los artículos de ayuda y los documentos de políticas aportan los hechos. Después redacta instrucciones que recojan el criterio que tu equipo aplica pero nunca ha puesto por escrito: umbrales, excepciones, reglas de escalación, tono. Define skills para los procedimientos que implican actuar en otros sistemas. Divide el trabajo en subagentes cuando el conocimiento de un dominio crezca lo suficiente como para interferir con el de otro. Y retroalimenta de forma continua las escalaciones y los fallos.