Los 11 mejores frameworks de orquestación de agentes de IA en 2026
Elaborado por Rob Jiang, Chief AI Engineer. Cada licencia se leyó en el archivo LICENSE del propio proyecto, cada precio en la página de precios vigente del proveedor y cada número de versión en PyPI, npm o el registro de cambios del repositorio, el 21 de septiembre de 2026. Aviso: esta guía la publica Aissist.io, que vende una capa de IA agéntica para atención al cliente y ventas. Aissist.io no es uno de los once frameworks analizados y no compite con ninguno de ellos. Ningún proveedor revisó esta página antes de su publicación.
En resumen: todos los frameworks de orquestación de agentes de IA componen bien los agentes; solo tres de los once que hemos puntuado (Google ADK, Microsoft Agent Framework y Pydantic AI) te dan contabilidad de tokens por paso desde el paquete de código abierto sin ninguna plataforma de proveedor de por medio.
Para qué es mejor cada uno, de un vistazo
- El mejor para agentes reanudables sin runtime del proveedor: Google ADK
- El mejor para agentes que deben sobrevivir a todo: Temporal
- El mejor para equipos .NET y agentes alojados en Azure: Microsoft Agent Framework
- El mejor para agentes con forma de grafo y control fino del estado: LangGraph
- El mejor para Python con tipado seguro que no cierra opciones: Pydantic AI
- El mejor para equipos de TypeScript: Mastra
- El mejor para poner en marcha rápido un prototipo multiagente: CrewAI
- El mejor para agentes duraderos de baja latencia en un solo binario: Restate
- El mejor para la contabilidad de coste y latencia por paso: Inngest
- El mejor para pipelines orientados a eventos y con muchos documentos: LlamaIndex Workflows
- El mejor para el camino más corto del prompt al agente funcional: OpenAI Agents SDK
Esa diferencia es toda la decisión de compra, y ninguna de las páginas que posicionan hoy para esta búsqueda la mide. Todos los frameworks publican la misma lista de funciones: agentes, herramientas, traspasos, memoria, un grafo o un equipo (crew). Lo que los separa en producción es más concreto y mucho menos divertido de vender: qué ocurre cuando un worker muere a mitad de una ejecución de seis pasos, si las llamadas al modelo que ya has pagado se vuelven a facturar al recuperarse y si una ejecución puede esperar tres días a una persona sin mantener un proceso abierto.
El AI Index 2026 del Stanford HAI plantea claramente lo que está en juego: los agentes de IA «están mejorando, pero siguen fallando aproximadamente uno de cada tres intentos en benchmarks estructurados», con los modelos líderes obteniendo entre un 62.9% y un 70.2% de pass@1 en τ-bench. Con esa tasa de fallos, la recuperación no es un caso límite. Es el bucle principal.
Cómo hemos comparado estos frameworks de orquestación de agentes de IA
Puntuamos once frameworks sobre 30, cinco puntos por cada uno de seis criterios, y los ordenamos por el total. Los criterios tratan deliberadamente de la supervivencia y no de la ergonomía, porque la ergonomía es lo que ya cubren todas las demás páginas comparativas.
| # | Criterio | 5 puntos significa |
|---|---|---|
| A | Ejecución duradera del estado del flujo de trabajo | El estado de ejecución, no solo el historial del chat, persiste en el almacenamiento que elijas, dentro del paquete de código abierto |
| B | Repetición tras un fallo | Una ejecución que se cae se reanuda desde el último paso completado, y las llamadas al modelo completadas no se vuelven a ejecutar |
| C | Interrupción con intervención humana | Una API de pausa/reanudación de primer nivel cuyo estado pendiente sobrevive al reinicio del proceso |
| D | Contabilidad de coste y latencia por paso | Uso de tokens y tiempos atribuidos por paso, desde el paquete OSS, sin necesidad de plataforma del proveedor |
| E | Licencia y portabilidad | Licencia aprobada por la OSI, sin excepciones, sin dependencia de una sola nube para la durabilidad en producción |
| F | Pruebas de escala en producción | Cifras de adopción publicadas y profesionales identificados con su cargo, no solo recuentos de estrellas |
Qué descalifica a una herramienta: cualquier cosa por debajo de 18/30, cualquier cosa que no esté disponible de forma general y cualquier cosa sin documentación técnica pública. Los once superaron el listón; el rango va de 20 a 28. Los empates se deshacen sumando las puntuaciones de repetición e interrupción, y después por las pruebas en producción, y así es como tres frameworks con 21 puntos acaban en el orden en que aparecen.
Dos exclusiones. Los productos de IA conversacional que se promocionan como frameworks son plataformas de proveedor con un SDK añadido, e incluirlos vaciaría de sentido la columna de licencias. Microsoft AutoGen tiene su propia sección fechada en lugar de un puesto, porque puntuar un proyecto congelado frente a proyectos vivos lo favorecería.
El aviso de sesgo, desde el principio: este es el blog de Aissist.io, y Aissist vende una capa operativa de IA para atención al cliente y ventas. No estamos en esta lista: no somos un framework de orquestación, y clasificarnos a nosotros mismos en un repaso para desarrolladores sería el tipo de movimiento que hace ilegible una página. Lo que sí somos es usuarios intensivos de esta capa, que es el único motivo por el que tenemos una opinión que merece la pena publicar.
Fuentes: documentación de los proveedores, archivos LICENSE leídos en los repositorios y no en páginas de marketing, metadatos de versiones de PyPI y npm, páginas de precios vigentes y casos de éxito publicados, todo consultado el 21 de septiembre de 2026. Los recuentos de estrellas son las cifras redondeadas que muestra GitHub. La ficha completa por criterio es el gráfico siguiente.
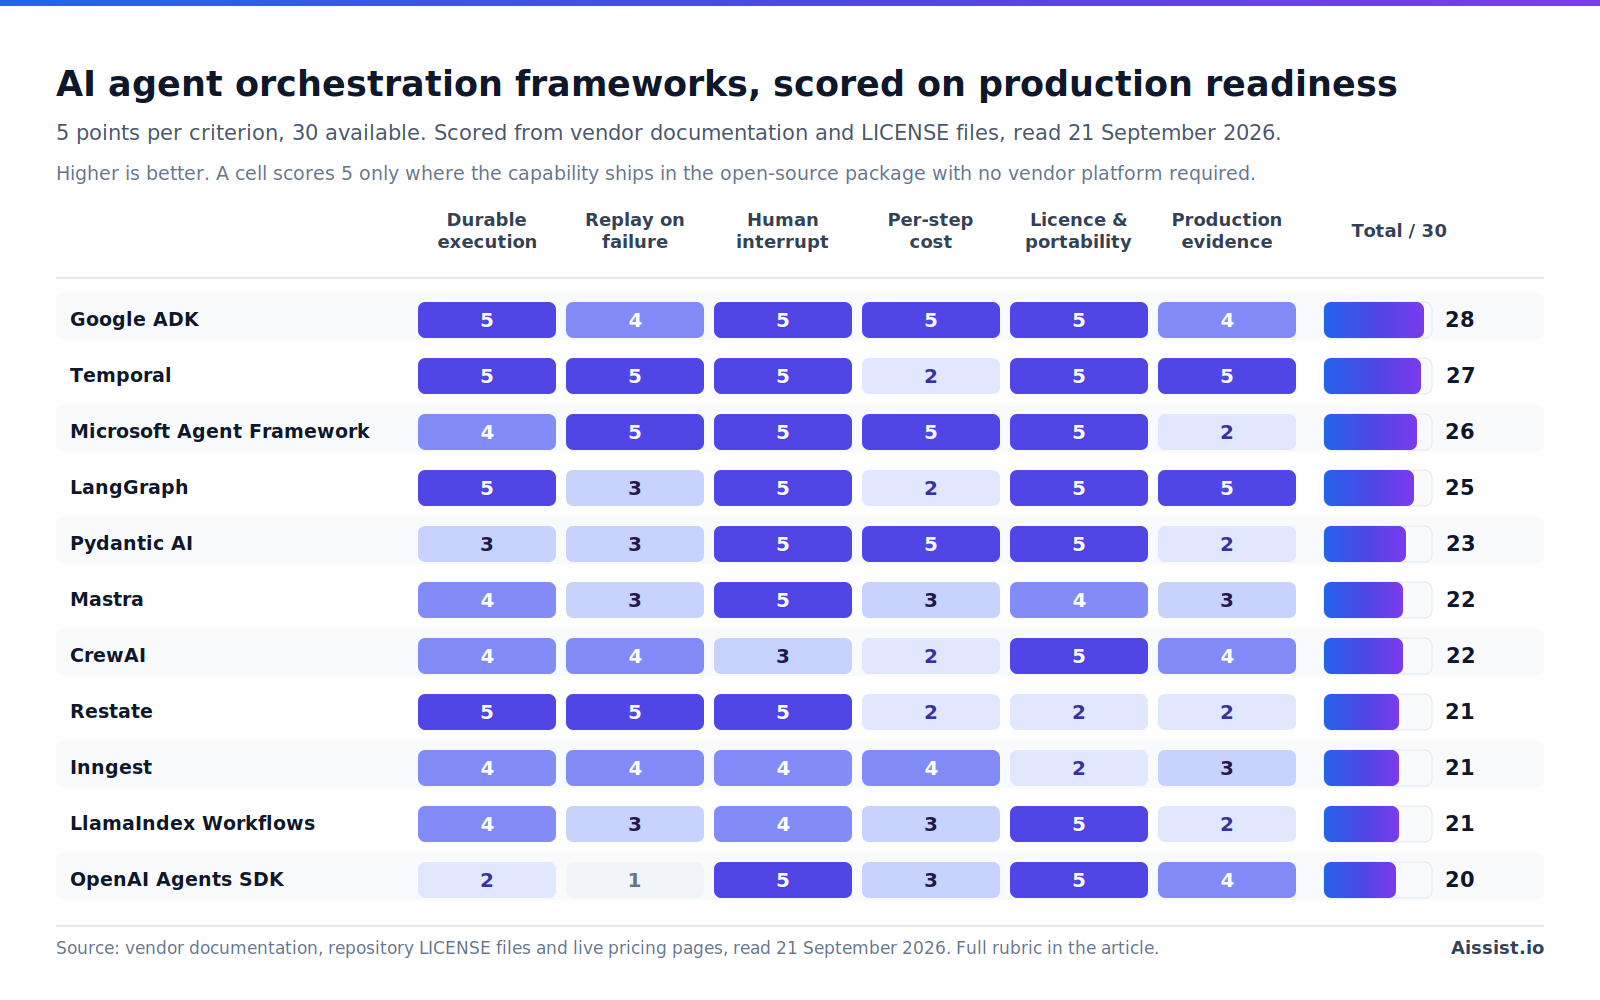
Los 11 frameworks de orquestación de agentes de IA de un vistazo
| Framework | Ideal para | Ejecución duradera | Repetición tras un fallo | Interrupción HITL | Contabilidad de costes por paso | Licencia | Puntuación |
|---|---|---|---|---|---|---|---|
| Google ADK | Agentes reanudables sin runtime del proveedor | Sí: Events + DatabaseSessionService (Postgres/MySQL/SQLite) | Sí: ResumabilityConfig; las herramientas pueden volver a ejecutarse | Sí: require_confirmation, LongRunningFunctionTool | Sí: spans OTel GenAI, cualquier backend OTLP | Apache-2.0 | 28 |
| Temporal | Agentes que deben sobrevivir a todo | Sí: Event History basado en eventos | Sí: las llamadas al modelo se ejecutan como Activities, no se repiten al reproducir | Sí: Signals, esperas de meses, worker inactivo | Sin coste de tokens nativo; OTel + partners | MIT | 27 |
| Microsoft Agent Framework | Equipos .NET y agentes alojados en Azure | Sí: checkpoints del flujo de trabajo; Cosmos DB para entornos distribuidos | Sí: RestoreCheckpointAsync; las llamadas a agentes completadas no se repiten | Sí: RequestPort, sobrevive a los checkpoints | Sí: semconv OTel GenAI, cualquier backend OTLP | MIT | 26 |
| LangGraph | Agentes con forma de grafo y control fino del estado | Sí: checkpointers (Postgres, Mongo, SQLite) | Parcial: viaje en el tiempo, pero las llamadas al LLM se vuelven a lanzar al reproducir | Sí: interrupt() + Command(resume=…) | El coste requiere LangSmith | MIT | 25 |
| Pydantic AI | Python con tipado seguro que no cierra opciones | Delegada: Temporal, DBOS, Prefect, Restate, AWS Lambda | Heredada del backend elegido | Sí: DeferredToolRequests, requires_approval | Sí: nativo de OpenTelemetry | MIT | 23 |
| Mastra | Equipos de TypeScript | Sí: snapshots en un proveedor de almacenamiento configurado | Parcial: reanudación desde una suspensión; repetición tras caída sin documentar | Sí: suspend() / resume() | Observabilidad de Mastra Cloud, medida | Apache-2.0 con excepción ee/ | 22 |
| CrewAI | Poner en marcha rápido un prototipo multiagente | Sí: @persist y CheckpointConfig; SQLite por defecto | Sí: crewai replay -t, reanudación y bifurcación de flows | Bloqueante por consola en OSS; HITL por webhook es Enterprise | Solo agregado en OSS; Tracing necesita una cuenta de AMP | MIT | 22 |
| Restate | Agentes duraderos de baja latencia en un solo binario | Sí: journal con repetición | Sí: «las llamadas al LLM no se repiten» | Sí: promesas duraderas; se suspende sin facturación en reposo | Tiempos del journal; sin coste de tokens nativo | BUSL-1.1 (SDK MIT) | 21 |
| Inngest | Contabilidad de coste y latencia por paso | Sí: memoización de pasos en el estado de la ejecución | Sí: los pasos completados se inyectan, no se repiten | Sí: step.waitForEvent, hasta un año | Coste de tokens y p95 nativos por llamada a la IA, en el panel de Inngest | SSPL-1.0 (AgentKit Apache-2.0) | 21 |
| LlamaIndex Workflows | Pipelines orientados a eventos y con muchos documentos | Sí: snapshots ctx.to_dict() / Context.from_dict() | Parcial: restauración desde snapshot; el código previo a una espera se repite | Sí: InputRequiredEvent / HumanResponseEvent | Hooks de instrumentación; sin panel de costes nativo | MIT | 21 |
| OpenAI Agents SDK | El camino más corto del prompt al agente funcional | Solo la conversación: RunState se serializa en los puntos de aprobación | No: «los streams no reproducen los eventos perdidos» | Sí: needs_approval, ToolApprovalItem | Agregado por ejecución; tiempos por paso mediante Traces alojado | MIT | 20 |
La columna de repetición es la que hay que leer dos veces. Tres de los once (Temporal, Restate y Microsoft Agent Framework) afirman en su propia documentación que las llamadas al modelo completadas no se vuelven a ejecutar al recuperarse. Es un dato de facturación tanto como de fiabilidad.
Para quién está pensado cada uno
| Framework | Lenguajes | Dónde se ejecuta | Estrellas (sep. 2026) | Última versión (sep. 2026) | Plan comercial |
|---|---|---|---|---|---|
| Google ADK | Python, TypeScript, Go, Java, Kotlin | Local, Cloud Run, GKE, Agent Runtime, cualquier contenedor | 21.1k (adk-python) | google-adk 2.9.2, 18 sep. | Agent Compute $0.085/hora por encima de 50 horas gratuitas |
| Temporal | Go, Java, Python, TypeScript, .NET, PHP, Ruby | Servidor autoalojado o Temporal Cloud | 21.7k | — | $50 por millón de Actions; $150 en créditos, 90 días |
| Microsoft Agent Framework | .NET, Python, Go | Local, Azure Functions, alojado en Foundry | 12.6k | Python 1.19.0, 18 sep. | Framework gratuito; Foundry Agent Service medido |
| LangGraph | Python, JavaScript | Biblioteca en proceso, o LangSmith Agent Server | 38.1k | langgraph 1.2.12, 21 sep. | LangSmith Plus $39/licencia/mes + $1.50/LCU |
| Pydantic AI | Python | En proceso; durabilidad mediante el backend elegido | 19.6k | — | Logfire Team $49/mes, 10M spans |
| Mastra | TypeScript | Autoalojado o Mastra Platform | 27.1k | — | Starter $0; Teams $250/mes |
| CrewAI | Python | Autoalojado o CrewAI AMP | 58.8k | crewai 1.15.22, 16 sep. | Basic $0 / 50 ejecuciones al mes; Enterprise solo bajo presupuesto |
| Restate | TypeScript, Python, Java, Kotlin, Go, Rust | Un solo binario, autoalojado o Restate Cloud | 4.4k | — | Gratis 50k acciones duraderas/mes; desde $75/mes |
| Inngest | TypeScript, Python, Go | Tu serverless, tus servidores o el edge; Inngest Cloud | 5.8k (926 para AgentKit) | — | Hobby $0 / 50k ejecuciones; Pro desde $99/mes |
| LlamaIndex Workflows | Python | En proceso, como servidor o mediante llamactl | 451 (llama-agents) | — | LlamaCloud, solo bajo presupuesto |
| OpenAI Agents SDK | Python, TypeScript | En tu proceso; Agents API alojada por OpenAI | 28.6k | openai-agents 0.22.3, 17 sep. | SDK gratuito; Agents API sin tarifa adicional |
Lee la columna de estrellas como una señal del ecosistema, no de fiabilidad. Las 58.8k de CrewAI y las 38.1k de LangGraph eclipsan las 21.1k de Google ADK, y ADK encabeza nuestra puntuación, mientras se distribuye en cinco lenguajes en repositorios que se cuentan por separado.
1. Google ADK — el mejor para agentes reanudables sin runtime del proveedor
El Agent Development Kit (ADK) de Google es un framework de agentes de código abierto, centrado en el código, para construir, depurar y desplegar sistemas multiagente, que se ejecuta en local o en Cloud Run, GKE, Agent Runtime o cualquier contenedor. La documentación de ADK de Google lo define como «el framework de desarrollo de agentes de código abierto que te permite construir, depurar y desplegar agentes de IA fiables a escala empresarial».
Clase: framework de orquestación con un runtime duradero integrado · Se ejecuta: en tu proceso o en el Agent Runtime gestionado de Google, sin un salto de capacidades entre ambos · Lenguajes: Python, TypeScript, Go, Java, Kotlin.
Ejecución duradera. ADK separa el estado de la conversación del estado de la ejecución y persiste ambos. DatabaseSessionService respalda las sesiones con PostgreSQL, MySQL o SQLite, y la documentación de sesiones afirma que los datos «sobreviven a los reinicios de la aplicación».
Repetición tras un fallo. De primer nivel e inusualmente explícita. La documentación de reanudación dice que la función «permite que un flujo de trabajo de agentes continúe donde lo dejó, evitando tener que reiniciar todo el flujo de trabajo», y se activa con ResumabilityConfig(is_resumable=True). Las tareas completadas persisten como Events, y los flujos de trabajo multiagente conservan el subagente actual, los contadores de bucles y la finalización por agente.
Intervención humana. require_confirmation en una FunctionTool pausa la ejecución y presenta una carga útil a una persona a través de la interfaz web o la API REST; LongRunningFunctionTool termina la ejecución mientras el trabajo externo continúa.
Coste y latencia por paso. En el paquete de código abierto, sin necesidad de plataforma. ADK emite spans OpenTelemetry GenAI que llevan gen_ai.usage.input_tokens y gen_ai.usage.output_tokens por agente y por herramienta, exportables a Cloud Trace, Jaeger, Grafana Tempo o Datadog.
Licencia · adopción · coste. Apache-2.0, leída del LICENSE del repositorio. 21.1k estrellas en adk-python, 13.8 millones de descargas en PyPI en el último mes. El Agent Compute de Agent Runtime es gratuito hasta 50 horas al mes por cuenta y después cuesta $0.085 USD por hora, según la página de precios de Google Cloud.
«Al reconstruir el Xfinity Assistant de Comcast con el Agent Development Kit (ADK), hemos pasado de una simple automatización con guion a una inteligencia generativa conversacional que ofrece a nuestros clientes resolución de problemas personalizada y soporte de autoservicio. Agent Runtime ha sido un acelerador enorme, que nos ha permitido desplegar una arquitectura multiagente sofisticada». — Rick Rioboli, director técnico de Connectivity & Platforms, Comcast
Ventajas: Apache-2.0 con reanudación en el paquete, no en la plataforma; contabilidad de tokens por paso sin ningún proveedor de por medio; cinco lenguajes.
Inconvenientes: la documentación de reanudación advierte de que «las herramientas pueden ejecutarse más de una vez durante la reanudación», así que todas las herramientas deben ser idempotentes; los Custom Agents necesitan cambios de código para reanudarse, y la reanudación desde la UI/CLI no está soportada; Google renombró Vertex AI como Gemini Enterprise Agent Platform en abril de 2026 manteniendo ReasoningEngine en la API, así que espera tutoriales desactualizados en todo el sector.
Nuestra opinión: ADK es la única opción que te da ejecución duradera, reanudación y contabilidad de costes por paso bajo una única licencia permisiva y sin dependencia alojada. No lo elijas si tus herramientas tienen efectos secundarios que no puedes hacer idempotentes: la salvedad de la doble ejecución es el precio del mecanismo de reanudación. Mira cómo se apilan las capas en la práctica en nuestro artículo sobre arquitectura multiagente.
2. Temporal — el mejor para agentes que deben sobrevivir a todo
Temporal es una plataforma de ejecución duradera de código abierto que ejecuta el código de la aplicación como flujos de trabajo que se reanudan automáticamente tras caídas, timeouts y esperas de varios días, autoalojada o como Temporal Cloud. Su documentación de IA afirma que «Temporal da a las aplicaciones y agentes de IA Durable Execution: un Workflow se reanuda automáticamente tras una caída, un timeout de red o una espera de varios días a que una persona apruebe un paso».
Clase: runtime duradero, no un framework de agentes; se ejecuta por debajo de uno · Se ejecuta: en tus workers y tu infraestructura; el Temporal Service autoalojado o gestionado · Lenguajes: Go, Java, Python, TypeScript, .NET, PHP, Ruby.
Ejecución duradera. Basada en eventos. La documentación de arquitectura de Temporal dice que, si se cae el proceso que ejecuta un flujo de trabajo, «el Temporal Service entrega el trabajo a otro proceso, que reconstruye el estado de la ejecución y la reanuda en el punto en que se detuvo, con las variables locales y el progreso intactos».
Repetición tras un fallo. La afirmación más contundente del sector, y la que importa para el coste: la integración con OpenAI Agents SDK de Temporal documenta que «las llamadas al modelo se ejecutan como Activities, de modo que se reintentan de forma duradera y no se repiten durante la reproducción del Workflow».
Intervención humana. Signals y Updates, con una espera realmente inactiva. La guía de aprobaciones de Temporal señala que, con workflow.wait_condition(), «el Worker devuelve la tarea actual al Temporal Server y queda inactivo, sin consumir cómputo», y que esto «funciona igual tanto si la espera es de cinco segundos como de cinco meses».
Coste y latencia por paso. La visibilidad de la ejecución es excelente: cada entrada, resultado de actividad, temporizador y mensaje en orden, con interceptores de OpenTelemetry en todos los workers. El coste de tokens no se registra de forma nativa y necesita una integración como Langfuse o Braintrust.
Licencia · adopción · coste. MIT. 21.7k estrellas. El anuncio de financiación de septiembre de 2026 de Temporal habla de más de 4,300 clientes de pago, más de 43 millones de instalaciones de código abierto en agosto y más de 1.9 billones de acciones en Cloud procesadas ese mes, y menciona a OpenAI, Netflix, Snap y Replit como usuarios. Temporal Cloud factura $50 USD por millón de Actions ($0.00005 cada una), con $150 en créditos durante 90 días.
«Hay cosas que simplemente quieres dar por sentadas cuando construyes un producto, y esta es una de ellas. Con Temporal no tenemos que preocuparnos por la infraestructura de orquestación. Podemos construir sobre las mismas primitivas en las que confiamos desde hace años y centrarnos en hacer avanzar el producto». — Lizzie Siegrist, product manager, Retool
Ventajas: la única opción en la que una caída a mitad de ejecución es de verdad un no-evento; integraciones propias documentadas con diez frameworks de agentes, entre ellos LangGraph, OpenAI Agents SDK, Pydantic AI, Google ADK y Mastra; MIT con una opción real de autoalojamiento. Inconvenientes: el determinismo es un impuesto permanente: la documentación de definición de workflows de Temporal exige que el código del workflow «haga las mismas llamadas a la API de Workflow en la misma secuencia, dada la misma entrada», así que editar la lógica del agente en un workflow en ejecución requiere una estrategia de versionado; el Event History está limitado a 51,200 eventos o 50 MB; la durabilidad «no se extiende a los servidores MCP, que se ejecutan de forma independiente del Workflow». Nuestra opinión: Temporal es lo adecuado cuando el coste de perder una ejecución supera el coste de aprender determinismo, lo que, para agentes de larga duración o que mueven dinero, ocurre casi siempre. No lo elijas si tus agentes son cortos, baratos y sin estado: pagas el impuesto de adopción y no obtienes ninguno de los beneficios.
3. Microsoft Agent Framework — el mejor para equipos .NET y agentes alojados en Azure
Microsoft Agent Framework es un framework abierto y multilenguaje para construir agentes de IA de nivel de producción y flujos de trabajo multiagente en .NET, Python y Go, desplegables en local, en Azure Functions o en infraestructura alojada en Foundry. Es el sucesor fusionado de AutoGen y Semantic Kernel.
Clase: framework de orquestación con un motor de flujos de trabajo duraderos y un runtime gestionado opcional · Se ejecuta: en tu proceso, en Azure Functions o alojado en Foundry · Lenguajes: .NET, Python, Go.
Ejecución duradera. Dos mecanismos. El checkpointing captura, según la documentación de checkpoints de Microsoft, «el estado actual de todos los ejecutores; todos los mensajes pendientes… las solicitudes y respuestas pendientes; los estados compartidos» al final de cada superpaso, con backends en memoria, en archivo y en Cosmos DB. La extensión Durable Task, por su parte, hace que las sesiones de los agentes «sobrevivan a caídas de procesos, reinicios y eventos de escalado sin perder el contexto», y no requiere Azure: funciona con un Durable Task Scheduler alojado en local.
Repetición tras un fallo. workflow.run(checkpoint_id=…) en Python, run.RestoreCheckpointAsync() en .NET. En la vía de Durable Task, Microsoft afirma que «las llamadas a agentes completadas no se vuelven a ejecutar al recuperarse».
Intervención humana. RequestPort, RequestInfoEvent, ctx.request_info() y @response_handler. Las solicitudes pendientes se guardan en el checkpoint y se vuelven a emitir al restaurar: la interrupción sobrevive a la caída, que es la parte que la mayoría de los frameworks se saltan.
Coste y latencia por paso. En el paquete OSS. El framework emite el histograma gen_ai.client.token.usage según las convenciones semánticas de OpenTelemetry GenAI, exportable a Azure Monitor, Aspire, Jaeger o cualquier endpoint OTLP. Azure AI Foundry es opcional.
Licencia · adopción · coste. MIT, leída del LICENSE del repositorio. 12.6k estrellas; el paquete NuGet Microsoft.Agents.AI muestra 8.2M descargas en total. El framework es gratuito; la página de precios de Foundry Agent Service de Azure afirma que «no hay ningún cargo adicional por crear o ejecutar agentes nativos de Foundry con prompts y flujos de trabajo», mientras que los tokens del modelo, las conexiones a herramientas y el cómputo de los agentes alojados se facturan aparte; la página no muestra cifras en dólares en el servidor, así que no publicamos ninguna.
«Esta es la versión lista para producción: API estables y un compromiso de soporte a largo plazo». — Shawn Henry, Principal Group Product Manager, Microsoft, sobre Agent Framework 1.0
Ventajas: el único framework de esta lista que ofrece .NET de primer nivel junto a Python; interrupciones que sobreviven al checkpointing; contabilidad de tokens OTel sin requisito de plataforma.
Inconvenientes: el backend de checkpoints de producción entre procesos es Azure Cosmos DB, lo que orienta discretamente la durabilidad hacia una sola nube; hereda una carga de migración de dos proyectos predecesores; el estado de las versiones es confuso, ya que la página de releases de GitHub iba dos versiones por detrás del CHANGELOG y de PyPI cuando lo comprobamos.
Nuestra opinión: si tu stack es .NET o tus agentes ya viven en Azure, esta es la opción creíble con menos fricción de la lista, y la observabilidad es mejor de lo que sugiere su marketing. No lo elijas para un proyecto nuevo solo en Python, donde ADK o LangGraph tienen una comunidad más asentada.
4. LangGraph — el mejor para agentes con forma de grafo y control fino del estado
LangGraph es un framework y runtime de orquestación de bajo nivel para construir agentes de larga duración y con estado como grafos, que se usa como biblioteca normal de Python o JavaScript o se despliega en el Agent Server de LangSmith. Su documentación general lo define como «un framework y runtime de orquestación de bajo nivel para construir, gestionar y desplegar agentes de larga duración y con estado».
Clase: framework de orquestación con persistencia intercambiable · Se ejecuta: en tu proceso, o en el Agent Server gestionado de LangChain respaldado por PostgreSQL y una cola de tareas duradera · Lenguajes: Python, JavaScript.
Ejecución duradera. Checkpointers, la capa de persistencia mejor documentada de este repaso. La documentación de checkpointers describe un snapshot «del estado del grafo en cada superpaso, organizado en hilos», con savers para Postgres, MongoDB, SQLite y Cosmos DB, y tres modos de durabilidad ("exit", "async" y "sync"), el último de los cuales ofrece «una alta durabilidad a costa de cierta sobrecarga de rendimiento».
Repetición tras un fallo. Presente, con una salvedad que justifica por sí sola esta sección. get_state_history(), update_state() e invocar con un checkpoint_id te permiten reproducir desde cualquier checkpoint o bifurcar en él, y los nodos anteriores no se vuelven a ejecutar. Pero la misma documentación afirma que las llamadas al LLM y las interrupciones «se vuelven a lanzar siempre durante la reproducción», así que la recuperación te cuesta tokens que Temporal, Restate y Microsoft Agent Framework no te cuestan.
Intervención humana. La API más limpia de la categoría. interrupt() «pausa la ejecución del grafo y devuelve un valor a quien lo llamó», guardando el estado y esperando; reanudas con un Command que lleva el valor de reanudación, según la documentación de interrupciones. En producción requiere un checkpointer duradero y un ID de hilo.
Coste y latencia por paso. Dividido, y la división es comercial. El paquete OSS muestra los recuentos de tokens en AIMessage.usage_metadata; el coste en dólares y los percentiles de latencia son funciones de LangSmith, y la documentación de trazas de LangChain señala que «sin ls_model_name, los recuentos de tokens pueden seguir registrándose, pero no se estimarán los costes».
Licencia · adopción · coste. MIT. 38.1k estrellas y 561.7 millones de descargas totales en PyPI, 51.0 millones en los últimos 30 días. LangSmith Developer cuesta $0 por licencia con 5k trazas base al mes; Plus cuesta $39 USD por licencia al mes con 10k, y ambos cobran después $1.50 por LangChain Compute Unit y $1.00 por Storage Unit.
«LangSmith nos permite supervisar todos nuestros agentes, entender qué funciona y qué no, qué llamadas a herramientas han fallado, qué PR acaba de romper el pipeline y qué funciones están adoptando nuestros usuarios». — Kordel France, director de AI Engineering, Toyota Motor North America
Ventajas: la capa de persistencia más madura, con backends reales de Postgres y Mongo; la API de interrupciones más ergonómica; el ecosistema más profundo, con Klarna, Replit y Elastic mencionados en el README del repositorio. Inconvenientes: la reproducción vuelve a lanzar las llamadas al LLM, lo que convierte la recuperación en un evento de facturación; reanudar tras una interrupción «reinicia todo el nodo desde el principio», así que los efectos secundarios previos a la interrupción deben ser idempotentes; la atribución de costes vive en LangSmith, no en la biblioteca. Nuestra opinión: LangGraph es la opción segura por defecto para equipos de Python que quieren control sobre el estado del grafo y pagarán LangSmith para ver los costes. No lo elijas si la recuperación debe ser gratuita: ejecútalo sobre Temporal, con el que se integra directamente.
5. Pydantic AI — el mejor para Python con tipado seguro que no cierra opciones
Pydantic AI es un framework de agentes en Python que añade una estructura tipada y validada a agentes, herramientas y salidas, y que delega deliberadamente la durabilidad en un motor externo en lugar de incluir uno propio. Su documentación de ejecución duradera dice que «te permite construir agentes duraderos que conservan su progreso ante fallos transitorios de la API y errores o reinicios de la aplicación, y gestionar flujos de trabajo de larga duración, asíncronos y con intervención humana con una fiabilidad de nivel de producción».
Clase: framework de orquestación con ejecución duradera intercambiable · Se ejecuta: en tu proceso, con la durabilidad del backend que conectes · Lenguajes: Python.
Ejecución duradera. Delegada por diseño en cinco integraciones mantenidas conjuntamente (Temporal, DBOS, Prefect, Restate y AWS Lambda), más Kitaru y Apache Airflow. La documentación es tajante sobre el límite: «La durabilidad no es almacenamiento».
Repetición tras un fallo. Heredada del backend. Conecta Temporal o Restate y obtienes sus garantías, incluidas las llamadas al modelo que no se repiten; no conectes nada y una caída te cuesta la ejecución.
Intervención humana. De primer nivel e inusualmente bien tipada. Una ejecución pausada termina con DeferredToolRequests como salida, con calls y approvals; reanudas llamando de nuevo al agente con el message_history original y un DeferredToolResults relleno. Las herramientas llevan requires_approval, o lanzan ApprovalRequired y CallDeferred en tiempo de ejecución, según la documentación de herramientas diferidas.
Coste y latencia por paso. Nativo de OpenTelemetry, en el paquete. Pydantic Logfire es el visor propio, pero no es obligatorio: Personal es gratuito con 10 millones de spans, y Team cuesta $49 USD al mes con 10 millones incluidos y $2 por cada millón adicional, según la página de precios de Pydantic.
Licencia · adopción · coste. MIT. 19.6k estrellas, 2.6k forks. El framework es gratuito; la observabilidad es la única superficie de pago, y es opcional.
Ventajas: tipado de principio a fin, lo que detecta el tipo de error de agente que solo aparece en producción; la API de aprobaciones es la más precisa de la lista; no te ata a una única solución de durabilidad. Inconvenientes: no incluye un motor duradero propio, así que «duradero» es una decisión que todavía tienes que tomar y operar; el mecanismo de aprobación «no es un límite de autorización frente a un cliente no fiable», según indica explícitamente; no hemos encontrado ninguna cita de un profesional identificado sobre su uso en producción, lo que es una laguna de pruebas real frente a LangGraph o Temporal. Nuestra opinión: elige Pydantic AI cuando quieras la capa de agentes tipada y la capa de durabilidad intercambiable, y combínalo con Temporal o Restate desde el primer día, no más tarde. No lo elijas si quieres todo incluido: la pila se vende por separado, a propósito.
6. Mastra — el mejor para equipos de TypeScript
Mastra es un framework de TypeScript para aplicaciones y agentes impulsados por IA que combina enrutamiento de modelos, agentes, flujos de trabajo basados en grafos, control con intervención humana y observabilidad, desplegado de forma autoalojada o en Mastra Platform. Su repositorio lo describe como «el framework moderno de TypeScript para aplicaciones y agentes impulsados por IA».
Clase: framework de orquestación con persistencia de flujos de trabajo y una plataforma gestionada · Se ejecuta: en cualquier sitio donde funcione Node, o en la plataforma alojada de Mastra · Lenguajes: TypeScript.
Ejecución duradera. Snapshots en un proveedor de almacenamiento que tú configuras. La documentación de suspensión y reanudación de Mastra afirma que «la suspensión guarda el estado de ejecución actual como un snapshot» y que los snapshots «se almacenan en tu proveedor de almacenamiento configurado y persisten entre despliegues y reinicios de la aplicación».
Repetición tras un fallo. La reanudación desde un punto de suspensión es de primer nivel y está bien documentada; la recuperación tras una caída imprevista no lo está, y por eso Mastra puntúa 3 y no 5 aquí. Los equipos que necesitan una durabilidad a prueba de caídas lo combinan con Temporal, que incluye a Mastra entre sus integraciones propias.
Intervención humana. suspend() y resume(), la expresión más limpia del patrón en TypeScript. Un paso se suspende, su estado se guarda en un snapshot y la ejecución continúa cuando la reanudas, sin una duración máxima documentada. En cambio, .sleep() y .sleepUntil() a nivel de flujo de trabajo ponen la ejecución en waiting: un mecanismo distinto que conviene no confundir.
Coste y latencia por paso. A través de la capa de observabilidad de Mastra, medida en la plataforma. La página de precios factura la observabilidad por eventos (100K incluidos en Starter y después $10 por cada 100K; 1M en Teams y después $8 por cada 100K), junto con las horas de CPU a $0.35 y $0.25 respectivamente.
Licencia · adopción · coste. Apache-2.0 con una excepción: el LICENSE.md excluye el contenido de cualquier directorio ee/, incluidos packages/core/src/auth/ee/ y packages/server/src/server/auth/ee/, que quedan bajo una licencia empresarial aparte. 27.1k estrellas, 2.6k forks. Platform Starter cuesta $0 al mes con usuarios, despliegues y proyectos ilimitados y 15 días de retención; Teams cuesta $250 USD al mes con seis meses de retención, SSO y documentación SOC 2.
Ventajas: la mejor propuesta para TypeScript de la lista, con una suspensión/reanudación que sobrevive a los reinicios; el autoalojamiento es realmente gratuito bajo Apache-2.0; más de 40 proveedores de modelos detrás de un único enrutador.
Inconvenientes: la excepción ee/ hace que «Apache-2.0» necesite un asterisco, y cubre la autenticación, justo la parte que una empresa quiere autoalojar; la repetición tras una caída está poco documentada en comparación con la suspensión; no hemos encontrado ninguna cita de un profesional identificado con su cargo sobre su uso en producción.
Nuestra opinión: si tu equipo escribe TypeScript y no quiere cambiar a Python para tener agentes, Mastra es la opción obvia y su modelo de suspensión está bien planteado. No lo elijas si tu requisito de durabilidad es «sobrevivir a que un nodo muera a mitad de la ejecución» sin añadir un runtime por debajo.
7. CrewAI — el mejor para poner en marcha rápido un prototipo multiagente
CrewAI es un framework de Python de código abierto para orquestar agentes autónomos basados en roles, construido en torno a Crews de agentes que colaboran y Flows de flujos de trabajo orientados a eventos, autoalojado o desplegado en CrewAI AMP. Su introducción lo define como «el framework de código abierto líder para orquestar agentes de IA autónomos y construir flujos de trabajo complejos».
Clase: framework de orquestación con persistencia añadida de forma incremental · Se ejecuta: en tu proceso, o en la infraestructura AMP gestionada de CrewAI · Lenguajes: Python.
Ejecución duradera. Dos mecanismos que se solapan, que es la descripción honesta. El checkpointing «guarda un snapshot del estado de ejecución durante una ejecución para que un crew, un flow o un agente pueda reanudarse tras un fallo o bifurcarse en una rama alternativa»; por separado, el decorador @persist guarda el estado del Flow, con SQLiteFlowPersistence por defecto. Conviene no confundirse: CrewAI Memory es un sistema de recuperación con embeddings y RAG, no persistencia del estado de ejecución.
Repetición tras un fallo. Dos vías: crewai replay -t <task_id> reproduce «desde este ID de tarea, incluidas todas las tareas posteriores», y los Flows se reanudan mediante kickoff(inputs={"id": uuid}) o se bifurcan mediante restore_from_state_id. Una salvedad: las escrituras automáticas de checkpoints son «de mejor esfuerzo: una escritura fallida se registra y la ejecución continúa».
Intervención humana. Por niveles, y el nivel importa. human_input=True pide información al usuario antes de la respuesta final de una Task, y @human_feedback usa por defecto un proveedor de consola bloqueante; el HITL no bloqueante por webhook que de verdad necesita un despliegue en producción (una ejecución que queda en Pending Human Input y se reanuda por API) es una función Enterprise.
Coste y latencia por paso. Solo agregado en el paquete de código abierto. La documentación de Flows afirma que «cada entrada del UsageMetrics devuelto es la suma de todas las llamadas al LLM realizadas dentro de una única invocación de flow.kickoff()»: sin atribución por paso, sin campo de coste, sin tiempos. CrewAI Tracing, que sí captura «tiempos de ejecución, uso de tokens y costes», requiere crewai login y una cuenta de AMP, aunque esa cuenta tiene un plan gratuito.
Licencia · adopción · coste. MIT. 58.8k estrellas, la cifra más alta de la lista, y 112.6 millones de descargas totales en PyPI. El blog de CrewAI habla de «unos 2 mil millones de ejecuciones de sistemas agénticos en los últimos 12 meses», y la empresa afirma que el 65% de las Fortune 500 lo usan. El plan Basic cuesta $0 con 50 ejecuciones de flujos de trabajo al mes; Enterprise es solo bajo presupuesto, y la tarifa de exceso por encima de 50 ejecuciones no se publica.
Ventajas: el camino más rápido, con diferencia, de cero a un crew multiagente funcional; MIT sin excepciones; la mayor comunidad de esta lista. Inconvenientes: la durabilidad llegó en tres sistemas separados en lugar de uno, y la persistencia por defecto es SQLite local; el HITL asíncrono de nivel de producción está detrás de Enterprise; pese al tamaño de la comunidad, no hemos podido verificar ni una sola cita de un profesional identificado con su cargo sobre el uso de CrewAI en producción, una laguna extraña con 58.8k estrellas. Nuestra opinión: CrewAI se gana sus estrellas por el tiempo hasta el primer crew, y para explorar esa es la métrica que importa. No lo elijas como capa de durabilidad de un sistema en el que una ejecución perdida cuesta dinero: el paquete OSS te llevará a una demo más rápido que a un SLA.
8. Restate — el mejor para agentes duraderos de baja latencia en un solo binario
Restate es un runtime de aplicaciones duradero distribuido como un único binario, que combina ejecución duradera, estado por claves, colas, RPC y temporizadores, autoalojado o como Restate Cloud. Su página principal lo describe como «un runtime de aplicaciones de baja latencia con ejecución duradera, estado por claves, colas, RPC, temporizadores, control de flujo y control operativo en un solo binario».
Clase: runtime duradero con una biblioteca documentada de patrones de agentes · Se ejecuta: un binario autoalojado, o Restate Cloud · Lenguajes: TypeScript, Python, Java, Kotlin, Go, Rust.
Ejecución duradera. Journaling con repetición. La documentación de conceptos clave de Restate dice que registra «cada paso de la ejecución de tu código en un journal», guardando «tanto la operación como su resultado», y ante un fallo «reproduce el journal, saltándose los pasos completados y reanudando exactamente desde donde se quedó».
Repetición tras un fallo. La afirmación más explícita que publica cualquier proveedor de la lista. El patrón de agentes duraderos de Restate afirma sin rodeos: «Los pasos completados se reproducen desde el journal (sin volver a ejecutarse)», «La ejecución se reanuda desde el primer paso incompleto» y «Las llamadas al LLM no se repiten (ahorrando coste y tiempo)». Cada respuesta del LLM se persiste y se reproduce desde el journal al recuperarse.
Intervención humana. Promesas duraderas. En el patrón de intervención humana, un agente crea una promesa duradera, toma un ID de callback y se suspende, «liberando recursos de cómputo (sin facturación en reposo en serverless)», y después se reanuda «desde el punto exacto en que se pausó» cuando un aprobador la resuelve por HTTP. No hay una espera máxima documentada.
Coste y latencia por paso. Visibilidad a nivel de journal: una «vista de journal: inspecciona la ejecución paso a paso de cualquier agente, incluidas las entradas, las salidas y los tiempos». El coste de tokens no se registra de forma nativa.
Licencia · adopción · coste. Esta es la columna que le cuesta puntos a Restate. El servidor es BUSL-1.1, y el archivo LICENSE lo dice con sus propias palabras: «The Business Source License (this document, or the 'License') is not an Open Source license». Pasa a Apache-2.0 cuatro años después de cada versión, y la concesión de uso adicional permite el uso interno en producción pero prohíbe un servicio público de plataforma Restate. Los SDK de cliente son MIT. 4.4k estrellas. Restate Cloud es gratuito hasta 50k acciones duraderas al mes y empieza en $75 al mes; la tarifa de exceso por acción no se publica.
«Aquí todo el mundo se quedó impresionado con lo fácil que fue poner en marcha Restate. En un par de horas implantamos con éxito Restate como orquestador de un pipeline muy propenso a errores y nada duradero, que nos causaba mucho estrés». — Sebastian Hindhede, CTO, Advisoa
Ventajas: la garantía publicada más clara de que la recuperación no vuelve a facturar tus llamadas al modelo; dieciséis patrones de IA documentados, desde agentes en carrera hasta la reversión ante fallos; un solo binario para ejecutar en local, una ventaja real de experiencia de desarrollo frente a un plano de control con varios servicios. Inconvenientes: BUSL-1.1 no es código abierto, y algunos equipos de compras dejan de leer ahí; el ecosistema más pequeño de la lista, con 4.4k estrellas y sin recuentos de clientes publicados; un paso que se bloquea más de un minuto sin registrarse en el journal se suspende y se reintenta por defecto, una trampa sutil para llamadas lentas al modelo que no están bien envueltas. Nuestra opinión: Restate es el runtime duradero mejor argumentado específicamente para agentes, y su biblioteca de patrones parece escrita por gente que ha puesto uno en producción. No lo elijas si tu organización trata las licencias no aprobadas por la OSI como un veto: es una cuestión de política, y no se va a ganar en una revisión de diseño.
9. Inngest — el mejor para la contabilidad de coste y latencia por paso
Inngest es una plataforma de ejecución duradera y orquestación de flujos de trabajo en la que cada paso se ejecuta como una solicitud HTTP independiente contra tus propias funciones serverless, servidores o edge, con un servidor autoalojable con licencia SSPL y una nube gestionada. Incluye AgentKit, un framework de agentes en TypeScript, junto con las primitivas de inferencia step.ai.
Clase: runtime duradero con un framework de agentes añadido · Se ejecuta: en tus funciones, dondequiera que ya se ejecuten; Inngest las invoca · Lenguajes: TypeScript, Python, Go.
Ejecución duradera. Memoización de pasos. La documentación de ejecución de Inngest explica que «cada paso de tu función se ejecuta como una solicitud HTTP independiente» y que los pasos completados se memorizan, de modo que la función «se reanuda saltándose los pasos que ya se han completado».
Repetición tras un fallo. Los pasos completados no se vuelven a ejecutar: «el código del paso no se ejecuta; en su lugar, el SDK inyecta el resultado en el valor de retorno». La pega es de arquitectura: el cuerpo de la función alrededor de tus pasos se vuelve a ejecutar en cada límite de paso, así que todo lo que no esté envuelto en step.run() se rehace cada vez.
Intervención humana. step.waitForEvent pausa una ejecución hasta que llega un evento coincidente, con los límites publicados más claros de toda la lista: duración máxima de la ejecución de 30 días en Free, 90 en Basic y 366 en Pro, y esperas «como máximo… de un año».
Coste y latencia por paso. La más completa de la lista, y no hay color. La documentación de observabilidad de IA de Inngest registra el uso de tokens por llamada a la IA, calcula un «coste estimado» a partir de los tokens no cacheados al precio de catálogo de cada modelo e informa de la latencia p50, p95 y p99 por llamada, automáticamente para los SDK de OpenAI, Anthropic y Google Generative AI una vez cargado un proveedor de OpenTelemetry. Puntúa 4 y no 5 en nuestra rúbrica por un motivo: las cifras llegan al panel de Inngest, no a un backend que controles tú.
Licencia · adopción · coste. SSPL-1.0 para el servidor principal, con una concesión irrevocable de Apache-2.0 efectiva en el tercer aniversario de cada versión; AgentKit es Apache-2.0. 5.8k estrellas para el servidor, 926 para AgentKit. Hobby cuesta $0 al mes con 50k ejecuciones; Pro empieza en $99 USD al mes con 1M incluido. Lee con atención la unidad de facturación: la página de precios de Inngest define una ejecución como «una única ejecución de función duradera más cada paso dentro de ella», así que una función de cinco pasos cuesta seis ejecuciones.
«Las repeticiones y la gestión de errores son fundamentales. Poder repetir funciones es increíblemente útil porque los resultados pueden ser impredecibles. Ya sea una caída del servicio o una incoherencia de datos en algún sitio que afecta a las ejecuciones de las funciones, poder reintentar ese trabajo garantiza que lo procesemos todo de principio a fin sin perdernos nada». — Diego Escobedo, Founding Engineer, Outtake
Ventajas: coste de tokens y latencia p95 nativos por llamada a la IA, algo que no ofrece nadie más; sin workers ni colas que gestionar; límites publicados y concretos en lugar de garantías vagas.
Inconvenientes: SSPL no es una licencia de código abierto aprobada por la OSI; la facturación por paso se multiplica de forma lineal con un bucle de agente muy conversador, con un límite de 1000 pasos y un techo de 32MB de estado por ejecución; waitForEvent tiene dos trampas reales: los eventos enviados antes de que se ejecute la función no se emparejan, y una espera que pierde en una carrera no se cancela.
Nuestra opinión: Inngest es la respuesta adecuada cuando «cuánto costó el paso cuatro y cuánto tardó» es una pregunta que te haces cada semana, y el modelo de ejecución serverless encaja con tu forma actual de desplegar. No lo elijas para bucles de agente de grano fino con cientos de pasos: tanto la unidad de facturación como el límite de pasos juegan en tu contra.
10. LlamaIndex Workflows — el mejor para pipelines orientados a eventos y con muchos documentos
LlamaIndex Workflows es un framework de Python orientado a eventos y asíncrono por diseño para controlar el flujo de ejecución de los agentes mediante pasos que emiten y consumen eventos, utilizable como biblioteca, como servidor o desplegado mediante la CLI llamactl. El proyecto describe Workflows como «una forma orientada a eventos, asíncrona por diseño y basada en pasos de controlar el flujo de ejecución de aplicaciones de IA como los agentes».
Clase: framework de orquestación con persistencia basada en snapshots · Se ejecuta: en tu proceso, detrás de un WorkflowServer o mediante llamactl · Lenguajes: Python.
Ejecución duradera. Snapshots del contexto. La documentación de estado explica que el estado «se serializa cuando haces un snapshot de una ejecución para hacerla duradera, así que limítalo a valores que un serializador JSON pueda codificar», usando ctx.to_dict() y Context.from_dict() con un serializador configurable. La durabilidad es, por tanto, algo que invocas, no algo que ocurra por defecto.
Repetición tras un fallo. Restauración desde un snapshot que hayas tomado. No hay un mecanismo automático de checkpoint por paso equivalente a los superpasos de LangGraph o al event history de Temporal, y la vía ctx.wait_for_event() conlleva un coste de repetición documentado: «El paso siempre se ejecuta al menos una vez hasta el punto de espera, que entonces lanza una excepción interna para pausar la ejecución. Cualquier código anterior a la llamada a wait_for_event debe poder repetirse de forma segura».
Intervención humana. Limpia y con forma de eventos. Un paso devuelve un InputRequiredEvent, otro consume un HumanResponseEvent, y quien llama responde con handler.send_event(HumanResponseEvent(...)). Para esperas que abarcan solicitudes HTTP separadas, el patrón documentado es «hacer un snapshot del contexto tras el prompt, guardarlo y restaurarlo cuando llegue la respuesta»: la durabilidad es explícita, lo que resulta honesto o incómodo según tu temperamento.
Coste y latencia por paso. Mediante hooks de instrumentación y exportadores de OpenTelemetry en lugar de una vista de costes integrada. No hay un panel nativo de coste de tokens en el paquete de código abierto.
Licencia · adopción · coste. MIT. El runtime de Workflows vive en el repositorio llama-agents, con 451 estrellas: una fracción del alcance de la marca LlamaIndex, y una señal razonable de que el runtime es mucho más reciente que la biblioteca de la que procede. Los precios de LlamaCloud no se publican en ninguna página pública; trátalos como solo bajo presupuesto.
Ventajas: el modelo orientado a eventos encaja de forma natural con pasos que se ramifican, se repiten en bucle y se ejecutan en paralelo sin un DSL; MIT sin excepciones; el mejor encaje cuando la recuperación sobre documentos es la carga de trabajo real y no algo secundario.
Inconvenientes: la durabilidad es opcional y manual, así que una caída entre snapshots pierde trabajo; la salvedad sobre la repetición de wait_for_event traslada una carga de idempotencia al código de los pasos; el pequeño repositorio del runtime y los precios no publicados de la plataforma lo convierten en la opción más difícil de evaluar con pruebas de esta lista.
Nuestra opinión: elige LlamaIndex Workflows cuando tu agente sea en esencia un pipeline de documentos con ramificaciones y ya uses LlamaIndex para la recuperación. No lo elijas como capa de orquestación duradera de uso general: hacer snapshots a mano es una buena primitiva y una mala garantía.
11. OpenAI Agents SDK — el mejor para el camino más corto del prompt al agente funcional
El OpenAI Agents SDK es una biblioteca ligera de Python y TypeScript para construir aplicaciones agénticas a partir de unas pocas primitivas (agentes, traspasos, guardarraíles y sesiones) que se ejecuta dentro de tu propio proceso, con una Agents API independiente alojada por OpenAI para los equipos que prefieren no ejecutar el bucle en absoluto. La documentación lo describe como una forma de «construir aplicaciones de IA agéntica en un paquete ligero y fácil de usar, con muy pocas abstracciones».
Clase: framework de orquestación con un runtime gestionado hermano · Se ejecuta: en tu proceso; la Agents API ejecuta el harness Codex de OpenAI en la infraestructura de OpenAI · Lenguajes: Python, TypeScript.
Ejecución duradera. Aquí es donde nuestra rúbrica muerde con más fuerza. Las sesiones «almacenan el historial de conversación de una sesión concreta, lo que permite a los agentes mantener el contexto sin necesidad de gestionar la memoria de forma manual y explícita», con SQLite, Redis, SQLAlchemy, MongoDB o un almacén cifrado como respaldo. Eso es una transcripción duradera, no una ejecución duradera: una caída a mitad de ejecución te devuelve la conversación, no el punto en el que ibas. La excepción es RunState, que se serializa en una interrupción de aprobación mediante state.to_json().
Repetición tras un fallo. No está soportada como mecanismo de primer nivel, y OpenAI lo dice. La documentación de sesiones de la Agents API afirma: «Los streams no reproducen los eventos perdidos. Tras una desconexión, recupera la sesión y sus elementos guardados para recuperar el trabajo». La recuperación consiste en reconectar y volver a recuperar, no en repetir pasos.
Intervención humana. De primer nivel, y mejor de lo que haría pensar el resto de la propuesta de durabilidad del SDK. needs_approval en una herramienta pausa la ejecución y rellena RunResult.interruptions con entradas ToolApprovalItem; llamas a result.to_state(), apruebas o rechazas y vuelves a ejecutar, y, según la documentación de HITL, «la ejecución reanudada continúa donde lo dejó». Como RunState se serializa, la aprobación sobrevive a un reinicio.
Coste y latencia por paso. Agregado por ejecución en el paquete: «El uso se agrega en todas las llamadas al modelo durante la ejecución, incluidas las llamadas al modelo que producen llamadas a herramientas o traspasos». Los tiempos por paso proceden de las trazas, activadas por defecto y consultables en el panel alojado Traces de OpenAI: gratuito, pero alojado.
Licencia · adopción · coste. MIT. 28.6k estrellas y 14.0 millones de descargas en PyPI en el último mes; openai-agents 0.22.3 salió el 17 de septiembre de 2026. El SDK es gratuito y la Agents API, en beta pública desde el 10 de septiembre de 2026, no añade tarifa de plataforma: el anuncio de OpenAI afirma que «no hay tarifas adicionales por usar la Agents API: simplemente pagas los tokens y las herramientas que usan tus agentes».
«En Nash desplegamos miles de agentes de IA de larga duración que gestionan cientos de millones de entregas en redes logísticas globales. La Agents API de OpenAI nos da la capa de sesiones duraderas y de orquestación que necesitamos para agentes que operan de forma continua en producción, gestionando el contexto, la recuperación y la ejecución en varios pasos». — Aziz Alghunaim, cofundador y CTO, Nash.ai
Ventajas: el arranque con menos fricción de la lista, con realmente pocas abstracciones que aprender; el mecanismo de aprobación es excelente y sobrevive a la serialización; MIT, y la opción alojada no cuesta nada más allá de los tokens. Inconvenientes: las sesiones persisten la conversación, no la ejecución, que es la distinción con más consecuencias de toda esta página; la Agents API «actualmente solo admite residencia de datos en Estados Unidos y no admite Zero Data Retention», un veto para cargas de trabajo residentes en la UE o con contratos ZDR; la contabilidad de uso es agregada por ejecución y sin latencia, así que los tiempos por paso implican, en la práctica, usar las trazas alojadas de OpenAI. Nuestra opinión: empieza aquí si estás validando si un agente resuelve el problema en absoluto: nada te lleva allí más rápido, y el diseño de aprobación de herramientas es el mejor del sector. Aborda la cuestión de la durabilidad antes del lanzamiento: la integración de Temporal ejecuta el bucle del agente dentro de un workflow con las llamadas al modelo como activities, que es el camino más corto desde este SDK hasta un sistema que sobrevive a un despliegue.
¿Qué pasó con AutoGen y tienes que migrar?
Microsoft AutoGen está en modo de mantenimiento desde el 2 de octubre de 2025: casi un año, no una semana, digan lo que digan los agregadores. El README de microsoft/autogen lo dice claramente: «AutoGen está ahora en modo de mantenimiento. No recibirá nuevas funciones ni mejoras y, a partir de ahora, lo gestiona la comunidad». A los nuevos usuarios se les remite a Microsoft Agent Framework; a los existentes, a una guía de migración oficial.
Esta es la cronología, con fechas, porque la mayor parte de la cobertura sobre esto no las tiene:
| Fecha | Qué ocurrió |
|---|---|
| 30 sep. 2025 | Sale AutoGen 0.7.5, que sigue siendo la última versión doce meses después |
| 2 oct. 2025 | Eric Zhu anuncia que AutoGen y Semantic Kernel se fusionan en Microsoft Agent Framework; AutoGen entra en modo de mantenimiento |
| 7 oct. 2025 | Microsoft se compromete a dar soporte a Semantic Kernel v1.x durante al menos un año después de que Agent Framework alcance la GA |
| 2 abr. 2026 | GA de Agent Framework 1.0: «API estables y un compromiso de soporte a largo plazo» |
| 18 sep. 2026 | Sale Agent Framework 1.19.0, que limita las sesiones MCP a cada invocación como cambio incompatible |
«AutoGen se seguirá manteniendo (tiene una API estable y seguirá recibiendo correcciones de errores críticos y parches de seguridad), pero no le añadiremos nuevas funciones significativas». — Eric Zhu, mantenedor de AutoGen, microsoft/autogen Discussion #7066
Entonces, ¿tienes que migrar? No con urgencia. AutoGen tiene una API estable, sigue recibiendo parches de seguridad y acumula 60.4k estrellas, más que cualquier framework vivo de nuestra lista. Lo que no tiene es una fecha publicada de fin de soporte: buscamos en el README y en la discusión del anuncio y no hay ninguna. Semantic Kernel obtuvo un compromiso de soporte explícito de al menos un año tras la GA de Agent Framework. AutoGen obtuvo la gestión de la comunidad.
Esa asimetría es la señal real. Migra la próxima vez que toques la capa de orquestación por otro motivo, y considera los cambios incompatibles de la guía como el coste real: el Team orientado a eventos pasa a ser un Workflow tipado y basado en grafos, AssistantAgent es de un solo turno salvo que subas max_tool_iterations mientras que el Agent de Agent Framework es multiturno por defecto, y FunctionTool deja paso a un decorador @tool con esquemas inferidos. Nada de eso se hace en un fin de semana.
¿Cuánto cuesta realmente ejecutar estos frameworks de orquestación de agentes de IA?
Con volúmenes realistas, la capa de orquestación es casi gratuita, y las sorpresas están en las unidades de facturación más que en las tarifas de titular. Este es un escenario pasado por todos los modelos de precios publicados: 2,000 ejecuciones de agente al mes, seis pasos con checkpoint cada una, una aprobación humana por ejecución con una espera media de cuatro horas.
| Plataforma | Unidad de facturación | Este escenario | Coste mensual (sep. 2026) |
|---|---|---|---|
| Temporal Cloud | Actions ($50 por millón) | ~10–12 Actions por ejecución ≈ 22,000 Actions | ~$1.10 de uso; el mínimo del soporte Business es de $500 |
| Inngest | Ejecuciones (ejecución + cada paso) | 2,000 × 7 = 14,000 ejecuciones | $0: dentro del plan Hobby de 50k |
| Restate Cloud | Acciones duraderas | ~16,000 acciones | $0: dentro del plan gratuito de 50k; de pago desde $75 |
| Google Agent Runtime | Horas de Agent Compute | ~50 horas de cómputo | ~$0 en el límite gratuito de 50 horas, después $0.085/hora |
| LangSmith | Trazas + LCU/LSU | 2,000 ejecuciones superan la asignación de 5k trazas de Developer | $39/licencia en Plus, más $1.50/LCU |
| Mastra Platform | Eventos de observabilidad + horas de CPU | ~20,000 eventos | $0 en Starter; $250 en Teams |
| Pydantic Logfire | Spans | muy por debajo de 10M | $0 en Personal; $49 en Team |
| CrewAI AMP | Ejecuciones de flujos de trabajo | 2,000 superan el plan Basic de 50/mes | Enterprise, solo bajo presupuesto |
Tres costes ocultos son los que hacen el daño real. Inngest factura la ejecución más cada paso dentro de ella, así que un bucle de agente muy conversador multiplica su factura por su propio número de pasos. Temporal factura el inicio de los temporizadores como Actions, así que un agente que espera inactivo una aprobación humana no consume cómputo pero sigue acumulando Actions. Y LangSmith registrará los recuentos de tokens sin estimar el coste salvo que añadas los metadatos ls_model_name, el tipo de cosa que descubres en una revisión de presupuesto y no durante la configuración.
Y luego está el coste que nadie pone en una tabla de precios: los tokens que pagas dos veces. Un framework que vuelve a ejecutar las llamadas al modelo completadas al recuperarse vuelve a facturar cada paso que ya habías pagado.
Aissist ejecuta su propia arquitectura multiagente, AgentMesh™, con volumen real de help desk en Intercom, Zendesk, Freshdesk, Gorgias, Kustomer, Front, Salesforce y HubSpot. El benchmark de costes de Aissist publica la regla de facturación de ese trabajo como min(interactions × $0.09, $0.60 per resolution): un techo de $0.60 por resolución. Es nuestra propia cifra en nuestro propio blog, y la etiquetaríamos como declarada por el proveedor si la publicara otro. Con esa economía unitaria, volver a ejecutar una resolución de seis pasos porque se reinició un worker no solo cuesta latencia: vuelve a facturar los pasos que ya habían tenido éxito y vuelve a disparar sus efectos secundarios en el help desk de otra persona. Por eso, de las cinco columnas de capacidades de la tabla comparativa del principio de esta página, la repetición tras un fallo es la que comprobaríamos antes de firmar nada.
¿Cómo elegir un framework de orquestación de agentes de IA?
Elige según el fallo que no te puedes permitir, no según la abstracción que más te guste. Siete reglas, en el orden en que las aplicaríamos:
- Si una ejecución perdida cuesta dinero o toca el sistema de un cliente, elige Temporal o Restate, porque son las únicas opciones cuya documentación afirma que las llamadas al modelo completadas no se vuelven a ejecutar al recuperarse.
- Si necesitas el coste de tokens por paso sin enviar trazas a un proveedor, elige Google ADK, Microsoft Agent Framework o Pydantic AI, porque los tres emiten spans OpenTelemetry GenAI a cualquier backend OTLP que ya tengas.
- Si tu stack es .NET o ya está en Azure, elige Microsoft Agent Framework, porque ningún otro de la lista ofrece .NET de primer nivel y sus interrupciones sobreviven al checkpointing.
- Si tu equipo escribe TypeScript, elige Mastra o Inngest: Mastra si quieres el framework de agentes, Inngest si quieres el runtime duradero y el panel de costes.
- Si todavía estás decidiendo si un agente resuelve el problema, elige OpenAI Agents SDK, porque te lleva a una respuesta funcional más rápido, y aborda la cuestión de la durabilidad antes del lanzamiento.
- Si quieres el máximo control sobre el estado del grafo y pagarás por la observabilidad, elige LangGraph, porque su capa de checkpointers es la más madura y LangSmith es el precio de ver los costes.
- Si quieres la capa de agentes tipada y la capa de durabilidad intercambiable, elige Pydantic AI, y conecta Temporal, DBOS, Prefect, Restate o AWS Lambda desde el primer día y no después del primer incidente.
Una regla que no tiene que ver con productos: elige el runtime antes que el framework si la durabilidad importa, y el framework antes que el runtime si no importa. Los frameworks son fáciles de cambiar y difíciles de querer; los runtimes, lo contrario. Nuestro análisis de desarrollar o comprar cubre la capa que hay por encima de esta decisión, donde la pregunta deja de ser qué framework y pasa a ser si conviene montar el sistema en absoluto.
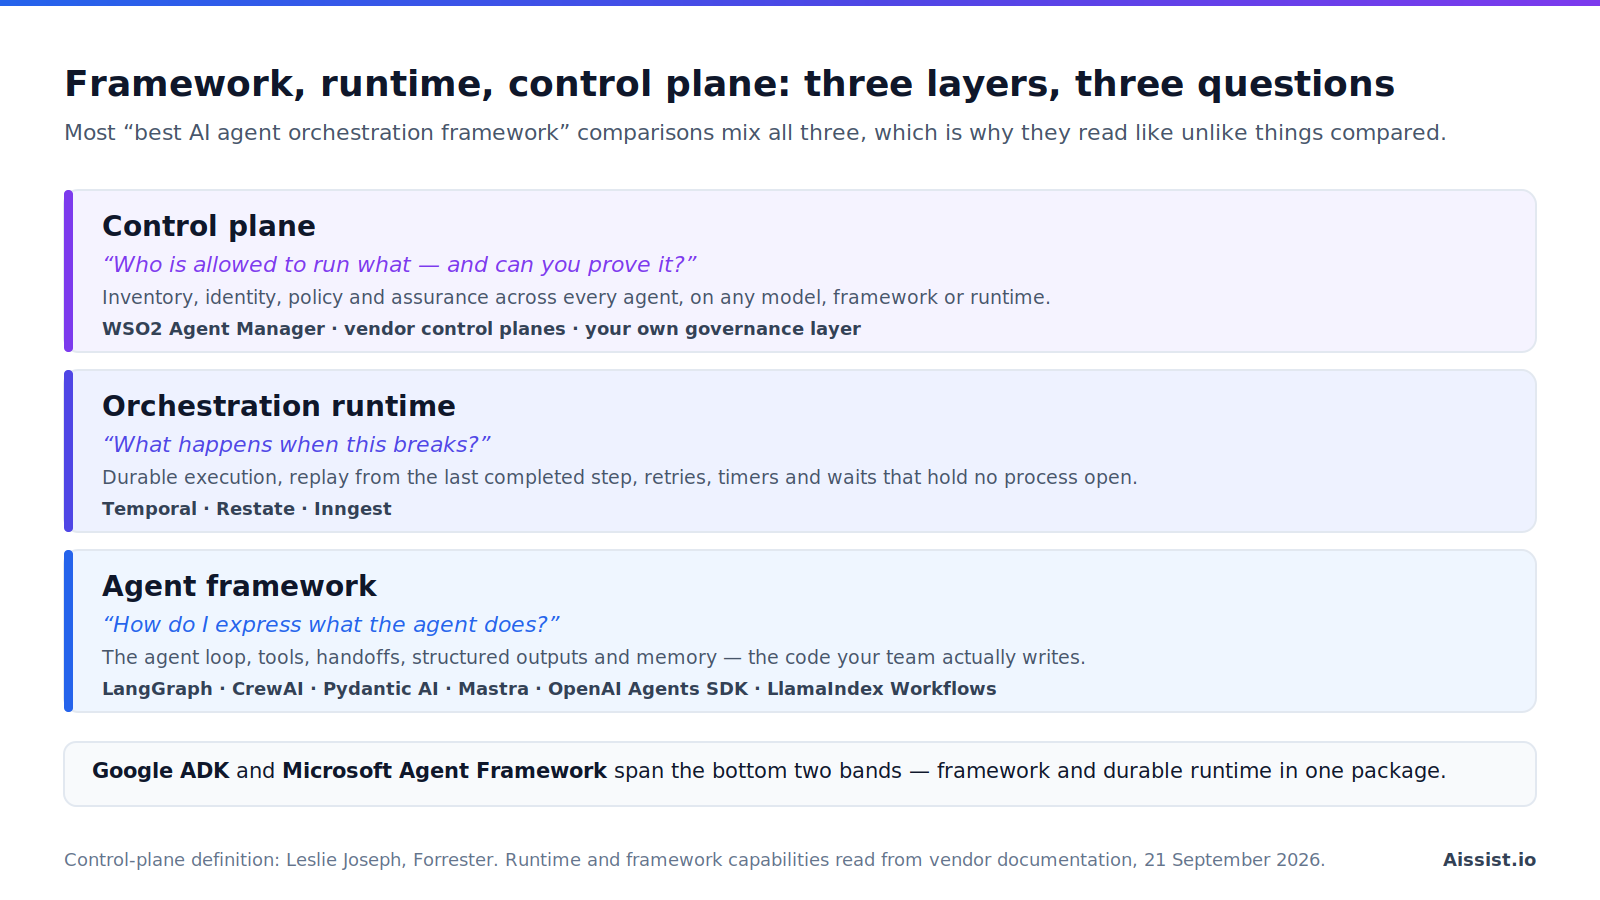
Orquestación, framework de agentes, plano de control: ¿qué diferencia hay?
Estos tres términos describen tres capas distintas, y el mercado los usa indistintamente, por lo que las páginas comparativas de esta categoría parecen estar comparando cosas distintas, y es que lo están haciendo.
Un framework de agentes es la biblioteca en la que escribes los agentes: el bucle, las herramientas, los traspasos, las salidas estructuradas y la memoria. LangGraph, CrewAI, Pydantic AI, Mastra, OpenAI Agents SDK, Google ADK y LlamaIndex Workflows son frameworks de agentes. Responde a cómo expreso lo que hace el agente.
Un runtime de orquestación es aquello sobre lo que se ejecuta el agente: ejecución duradera, reintentos, repetición, temporizadores y esperas que no mantienen ningún proceso abierto. Temporal, Restate e Inngest son runtimes de orquestación; Google ADK y Microsoft Agent Framework incluyen uno. Responde a qué pasa cuando esto se rompe. La documentación de IA de Temporal enumera diez frameworks de agentes sobre los que se ejecuta (entre ellos LangGraph, OpenAI Agents SDK, Pydantic AI, Google ADK y Mastra), lo que te dice cómo se combinan realmente las dos capas en producción.
Un plano de control de agentes es lo que gobierna todo lo anterior. Leslie Joseph, de Forrester, lo define como «un plano de control empresarial que inventaría, gobierna, orquesta y asegura agentes de IA heterogéneos de distintos proveedores y dominios», y sostiene en un análisis de marzo de 2026 que es «el tercer plano funcional de una arquitectura agéntica empresarial, junto al plano de construcción y el plano de orquestación», donde «la gobernanza debe situarse fuera de los entornos de construcción y de orquestación». Responde a quién tiene permiso para ejecutar qué, y si puedes demostrarlo.
Esa tercera capa está llegando rápido. En la encuesta de Forrester a 47 proveedores tecnológicos a finales de febrero de 2026, «el setenta y nueve por ciento de los proveedores participantes reconoce los planos de control de agentes como una categoría de producto significativa y diferenciada», y Zhenya Sun, de IDC, informa de que las empresas destinan ya «una media del 16.7% de su gasto total previsto en IA a la seguridad y la gobernanza de la IA y los agentes». WSO2 lanzó en disponibilidad general Agent Manager, un plano de control con licencia Apache-2.0, el 15 de septiembre de 2026, y lo presenta como «un único inventario para cada agente en cualquier modelo, framework o runtime».
Una categoría más que la gente llama framework: los lenguajes de agentes nativos de una plataforma no son portables. Salesforce publicó en código abierto Agent Script bajo Apache-2.0 en TDX en abril de 2026, y el repositorio es explícito: «Lo que no estamos publicando en código abierto (todavía) es el runtime… puedes analizar, validar, compilar y construir herramientas en torno a Agent Script, pero ejecutar agentes requiere el entorno de ejecución de Salesforce». La orquestación multiagente de Agentforce alcanzó la GA el 11 de septiembre de 2026. Ambas cosas son reales; ninguna es un framework que puedas llevarte contigo. Para ver cómo se apilan estas capas en un sistema que funciona, consulta nuestras notas sobre cómo se coordina la IA multiagente entre funciones de negocio y sobre la capa de gateways entre los agentes y los sistemas sobre los que actúan.
La durabilidad es una propiedad del runtime, no del framework
Estos once frameworks se diferencian mucho menos en cómo componen los agentes de lo que sugiere su documentación, y mucho más en lo que ocurre cuando algo muere a mitad de ejecución. Google ADK encabeza nuestra puntuación como la única opción que incluye ejecución reanudable y contabilidad de tokens por paso en un paquete Apache-2.0 sin dependencia alojada. Temporal es segundo y sería primero en una rúbrica de pura supervivencia. OpenAI Agents SDK es undécimo y seguirá siendo la primera opción adecuada para muchos equipos, porque llegar rápido a un agente funcional es un objetivo legítimo y la durabilidad puede añadirse por debajo más adelante.
Así que la respuesta práctica suelen ser dos productos: un framework con el que tu equipo disfrute escribiendo y un runtime que haga aburrida una caída. Elige primero el segundo si la ejecución vale dinero. Si prefieres no montar ninguno de los dos, porque los agentes que necesitas son agentes de atención al cliente y ventas y no infraestructura, esa es otra decisión, y hemos escrito sobre ella.
¿Ejecutas agentes con volumen real de tickets y no con benchmarks? AgentMesh™ de Aissist.io es la capa multiagente que hay detrás de una tasa de resolución media del 83% con tráfico real de help desk, construida para que un reinicio cueste un reintento y no una nueva factura. Mira cómo funciona la arquitectura →
Preguntas frecuentes
¿Cuál es el mejor framework de orquestación de agentes de IA en 2026?
Google ADK obtiene la puntuación más alta en nuestra rúbrica, 28 de 30, porque incluye ejecución duradera, reanudación y contabilidad de tokens por paso bajo Apache-2.0 sin necesidad de plataforma alojada. Le sigue Temporal con 27, que es la mejor opción cuando sobrevivir a los fallos importa más que la ergonomía del framework.
¿Qué diferencia hay entre un framework de agentes de IA y la orquestación de agentes?
Un framework de agentes es la biblioteca en la que escribes los agentes: el bucle, las herramientas, los traspasos y la memoria. La orquestación es lo que los ejecuta: ejecución duradera, reintentos, repetición y temporizadores. Varios productos hacen ambas cosas, pero son capas separables, y la mayoría de los sistemas en producción combinan una de cada.
¿Qué frameworks de agentes de IA admiten ejecución duradera?
Google ADK, Microsoft Agent Framework, LangGraph, CrewAI, Mastra y LlamaIndex Workflows persisten el estado de ejecución de los flujos de trabajo en sus paquetes de código abierto. Temporal, Restate e Inngest ofrecen ejecución duradera como runtimes por debajo de cualquier framework. OpenAI Agents SDK persiste el historial de conversación, no el estado de ejecución.
¿Vuelve a ejecutar LangGraph las llamadas al LLM cuando se reproduce un flujo de trabajo?
Sí. La documentación de checkpointers de LangGraph afirma que las llamadas al LLM y las interrupciones «se vuelven a lanzar siempre durante la reproducción», así que recuperar una ejecución fallida vuelve a costar tokens. Temporal, Restate y la vía Durable Task de Microsoft Agent Framework documentan el comportamiento contrario.
¿Sigue manteniéndose Microsoft AutoGen en 2026?
AutoGen está en modo de mantenimiento: solo correcciones de errores, parches de seguridad y documentación, gestionado por la comunidad y sin fecha publicada de fin de soporte. Su última versión, 0.7.5, salió el 30 de septiembre de 2025. Microsoft remite los proyectos nuevos a Agent Framework y publica una guía de migración desde AutoGen.
¿Qué framework de agentes es mejor para TypeScript?
Mastra es el framework de agentes para TypeScript más sólido, con suspend() y resume(), que guardan el estado en snapshots en tu proveedor de almacenamiento y sobreviven a los reinicios. Inngest es mejor opción si quieres un runtime duradero con coste de tokens y latencia p95 nativos por paso en lugar de un framework de agentes.
¿Cuánto cuesta la orquestación de agentes de IA?
La capa de orquestación en sí es casi gratuita con un volumen moderado: 2,000 ejecuciones al mes caben dentro del plan gratuito de Inngest, Restate y Mastra. Los costes proceden de los tokens del modelo, de unidades de facturación que se multiplican con el número de pasos y de plataformas de observabilidad con precio por traza o por span.
¿Necesito un plano de control de agentes además de un framework?
Solo cuando ejecutes agentes de más de un framework o de más de un equipo. Un plano de control inventaría y gobierna los agentes en distintos runtimes; Forrester comprobó que el 79% de 47 proveedores encuestados lo considera una categoría diferenciada. Por debajo de esa escala, la observabilidad de tu propio framework es suficiente.
Registro de cambios
- Septiembre de 2026: primera publicación. Once frameworks puntuados según los seis criterios de producción; la cronología del modo de mantenimiento de AutoGen corregida a octubre de 2025 a partir de la fuente primaria; todas las licencias leídas de los archivos
LICENSEde los repositorios; todos los precios leídos de las páginas de precios vigentes de los proveedores el 21 de septiembre de 2026.