La tendencia de la IA de voz en 2026: controlabilidad frente a latencia
Nota editorial. Aissist.io no ha lanzado oficialmente ningún producto de IA de voz. Sin embargo, este ámbito nos interesa mucho. Todo lo que sigue procede de dos fuentes: la experiencia previa de nuestro equipo construyendo sistemas conversacionales en tiempo real y nuestra propia exploración práctica reciente de la generación actual de modelos de voz. Lo publicamos como un estudio de trabajo y no como una presentación comercial, y lo actualizaremos a medida que avance la tecnología.
En resumen: la tendencia que define la IA de voz en 2026 no es el lanzamiento de un nuevo modelo, sino que toda decisión de arquitectura relevante sigue reduciéndose a un único compromiso: controlabilidad frente a latencia. Un pipeline por componentes ASR→LLM→TTS expone una salida en cada junta (un lugar donde filtrar, redactar datos, aplicar políticas y registrar) y te obliga a pelear por los milisegundos. Un modelo speech-to-speech de extremo a extremo te da respuestas en menos de un segundo y te quita casi todos los puntos donde podrías haber insertado control. Ajustar (fine-tuning) un modelo de extremo a extremo es hoy la forma más viable de conseguir ambas cosas, a costa de computación e iteraciones de ingeniería. Las muletillas y los sonidos de tecleo compran tolerancia, no una conversación auténtica. Creemos que el modelo de extremo a extremo acabará ganando, pero solo cuando pueda aceptar contexto en mitad de la conversación y emitir algo más que voz.
Pregunta hacia dónde va la IA de voz y obtendrás una lista de lanzamientos de modelos. La respuesta más útil es estructural: toda decisión relevante sobre la arquitectura de la IA de voz sigue reduciéndose a un único compromiso, controlabilidad frente a latencia. Puedes tener un sistema que puedes inspeccionar, filtrar, gobernar y personalizar en cada paso, y será lento. O puedes tener un sistema que responde en menos de un segundo y parece humano, y te quedarán muy pocos sitios donde insertar control. A agosto de 2026, ninguna arquitectura en producción escapa a esto. Elegir una arquitectura de IA de voz es, en realidad, elegir en qué lado de ese compromiso puede permitirse perder tu caso de uso.
Por qué la latencia de la IA de voz es una restricción dura y no un extra
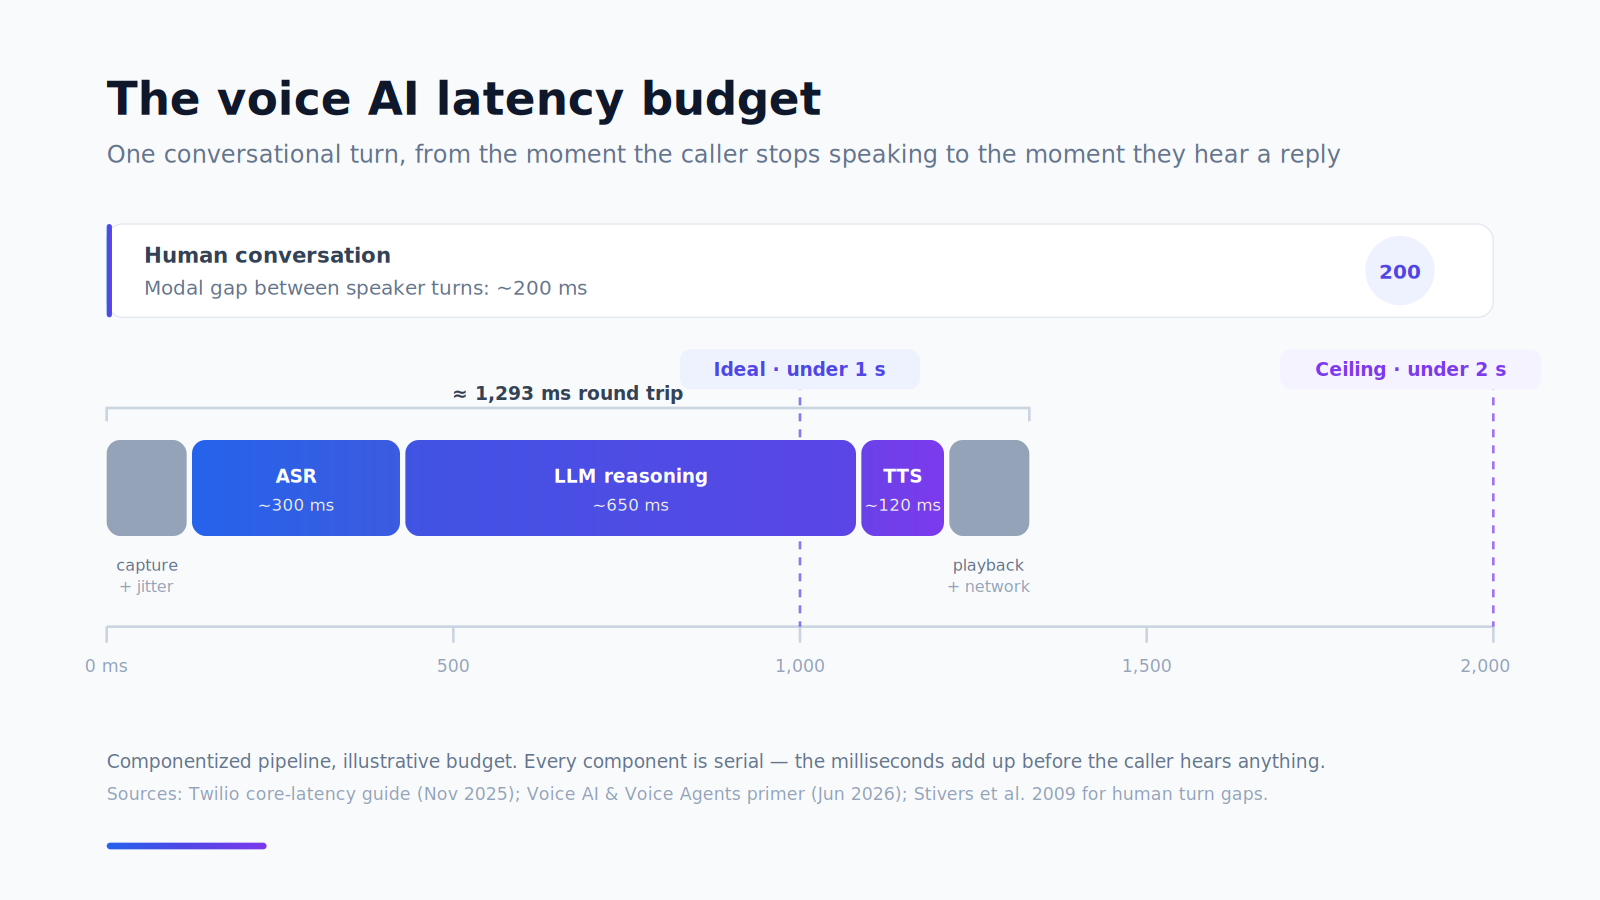
Respuesta corta: las personas esperan una respuesta en unos 200 ms. Ningún agente de voz se acerca, así que la regla práctica es mantenerse por debajo de dos segundos y bajar de uno si se puede.
La automatización de texto es indulgente. Un chat de soporte que tarda cuatro segundos en responder parece reflexivo. La voz no tiene ese margen, porque las personas tienen una expectativa innata de lo rápido que debe llegar un turno de respuesta. El análisis de la conversación sitúa el intervalo modal entre turnos de habla en aproximadamente 200 milisegundos (Levinson y Torreira), con intervalos medianos en diez idiomas de entre 0 y 300 ms (Stivers et al., 2009), según resume el Journal of Cognition.
Ningún agente de voz alcanza los 200 ms. Los objetivos prácticos en los que se ha asentado el sector son un orden de magnitud más laxos: mantenerse por debajo de dos segundos y bajar de un segundo si se puede. La guía de latencia de Twilio fija un objetivo de intervalo entre turnos de boca a oído de 1,115 ms, con un límite superior de 1,400 ms (Twilio, noviembre de 2025), y la guía introductoria Voice AI and Voice Agents, muy difundida, señala 1,500 ms de voz a voz como la cifra a la que aspirar (actualizada en junio de 2026).
Si se cruza la línea de los dos segundos, la experiencia se degrada de una forma que los usuarios describen como incómoda más que como lenta. Hablan por encima del agente. Se repiten. Preguntan si hay alguien ahí.
Los trucos que rellenan el hueco y por qué solo funcionan a medias
Como el presupuesto es tan ajustado, el sector ha desarrollado una serie de técnicas para enmascarar la latencia. La guía de prompting en tiempo real de OpenAI recomienda breves preámbulos hablados («Voy a comprobar ese pedido ahora») precisamente para ejecutar el audio y una llamada a herramienta en paralelo, «enmascarando la latencia» (OpenAI). LiveKit incluye clips de audio de fondo exactamente con este fin, como KEYBOARD_TYPING y OFFICE_AMBIENCE, que se reproducen mientras el agente piensa (documentación de LiveKit). Las muletillas, las señales de escucha activa y el tecleo simulado son ya equipamiento estándar.
Ayudan de forma medible, pero de manera limitada. Un estudio con 54 participantes presentado en CUI '25 concluyó que las muletillas naturales (un gesto de estar pensando más una frase como «Mmm, a ver…») mejoraban significativamente el tiempo de respuesta percibido con retrasos de 4.0 s y 6.5 s, mientras que los indicadores artificiales, como los iconos de carga y los tonos de procesamiento, «no afectaron significativamente a la experiencia de usuario» en absoluto. Y, lo que es clave, las mejoras de las muletillas naturales en todas las dimensiones más amplias que midió el estudio (interacción, buena impresión, incomodidad, competencia, disposición a volver a interactuar) «no fueron significativas» (Maslych et al., CUI '25). Un estudio anterior sobre muletillas conversacionales en agentes virtuales informó directamente de «actitudes encontradas» (Pfeifer y Bickmore, IVA 2009).
Eso coincide con nuestra propia lectura. Enmascarar compra unos cientos de milisegundos de tolerancia. No produce una experiencia conversacional auténtica. La arquitectura, sí.
IA de voz por componentes: control a costa de latencia
Respuesta corta: encadenar ASR, un LLM y TTS te cuesta latencia en serie y te da un punto de intervención en cada junta.
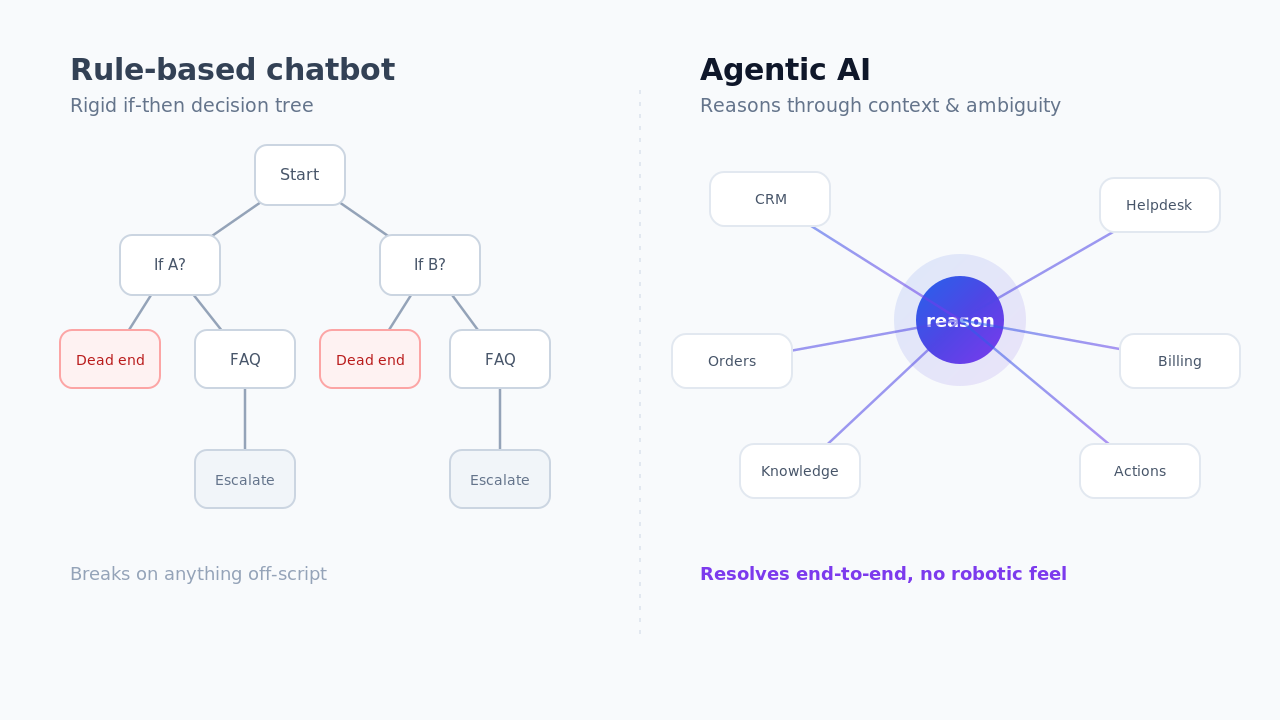
La arquitectura por componentes (o en cascada) encadena al menos tres piezas: ASR para el reconocimiento de voz, una capa de NLP/LLM para el razonamiento y TTS para la síntesis de voz. Según nuestra valoración, sigue siendo la forma en que se construyen la mayoría de los agentes de voz en producción.
Su problema es aritmético. Cada componente añade latencia en serie dentro de un presupuesto que ya era ajustado. Los objetivos por componente de Twilio son STT 350 ms, tiempo hasta el primer token del LLM 375 ms y tiempo hasta el primer byte del TTS 100 ms. La guía Voice AI and Voice Agents desglosa un ciclo completo en 1,293 ms: transcripción y detección de fin de habla 300 ms, tiempo hasta el primer byte del LLM 650 ms, TTS 120 ms y el resto perdido en codificación, búfer de jitter y saltos de red.
Cumplir ese presupuesto exige ingeniería de verdad. Hay dos palancas que importan por encima del resto:
Detectar antes el fin del turno. La detección de actividad de voz ingenua espera al silencio, y esa espera sale cara: LiveKit señala que «un tiempo de espera de silencio fijado en 800 ms añade casi un segundo entero a cada respuesta antes de que el pipeline siquiera empiece» (LiveKit, febrero de 2026). La detección de turno basada en modelos sustituye el temporizador por una predicción: el modelo transformer de fin de enunciado de LiveKit se ejecuta en unos 50 ms, y LiveKit informa de que combinarlo con VAD reduce las interrupciones involuntarias un 85% frente a usar solo VAD (LiveKit, diciembre de 2024); por su parte, Smart Turn v3 de Pipecat es un modelo de 8 MB que hace inferencia en CPU en 12 ms en 23 idiomas (Daily, septiembre de 2025). Ambos codifican la misma idea: que algo esté gramaticalmente completo no significa que esté conversacionalmente completo.
Trabajar en paralelo. Enviar transcripciones parciales al LLM en streaming, sintetizar la primera frase antes de que se genere la última y redactar respuestas de forma especulativa mientras el usuario sigue hablando. La investigación sobre decodificación especulativa durante la entrada informa de una reducción media de la latencia de aproximadamente 2× en benchmarks conversacionales (PredGen, arXiv 2506.15556).
Lo que compras con ese esfuerzo es control. Un pipeline por componentes expone una salida en cada junta, y cada junta es un lugar donde intervenir: redactar los datos personales antes de que lleguen al modelo, aplicar políticas al texto antes de que se pronuncie, filtrar y comprimir el contexto para que el modelo posterior vea menos y responda más rápido, y registrar una transcripción de cada turno. Esa transcripción es la materia prima de la observabilidad, la puntuación de calidad y los artefactos de gobernanza y auditoría que pedirá un equipo de cumplimiento normativo. La personalización es sencilla porque hay dónde ponerla, por la misma razón por la que nuestra plataforma multiagente del lado del texto está construida como etapas inspeccionables y no como una única llamada opaca, y por el mismo principio que hay detrás de la IA evaluable.
Speech-to-speech de extremo a extremo: velocidad a costa de control
Respuesta corta: un solo modelo, con audio de entrada y audio de salida, te sitúa por debajo de un segundo y te deja un pequeño prompt como único punto de control.
Los modelos de extremo a extremo reciben audio y emiten audio, saltándose por completo el paso por texto. La ventaja de latencia es real y grande. Moshi, de Kyutai, informa de una latencia teórica de 160 ms y de 200 ms en la práctica (arXiv 2410.00037). Qwen3-Omni informa de una latencia teórica de extremo a extremo hasta el primer paquete de 234 ms en arranque en frío y solo con audio, y de 547 ms con vídeo (arXiv 2509.17765). Con una red buena y estable, un agente speech-to-speech puede quedar holgadamente por debajo de un segundo, lo bastante cerca del ritmo humano como para que la interacción deje de sentirse como una transacción.
El coste es la controlabilidad, y aparece en cuatro sitios.
El prompting es el único punto de control real, y es pequeño. Puedes cargar contexto al inicio de la sesión, pero un prompt de sistema grande aumenta la latencia, que es precisamente la razón por la que elegiste esta arquitectura. La ventana de contexto en tiempo real de OpenAI pasó de 32K a 128K tokens en mayo de 2026 (OpenAI), lo que ayuda, pero el presupuesto práctico por sesión sigue muy por debajo de lo que un pipeline en cascada le pasa a un LLM de texto en cada turno.
El seguimiento de instrucciones es menos fiable que en modo texto. La guía Voice AI and Voice Agents lo dice sin rodeos: «Los modelos speech-to-speech no siguen las instrucciones ni llaman a herramientas con la misma fiabilidad que los LLM en modo texto». La propia guía de prompting de OpenAI advierte de que gpt-realtime-2 «sigue las instrucciones de forma más literal que los modelos en tiempo real anteriores. Los prompts que funcionaban bien en modelos antiguos pueden necesitar ajustes». Nuestros experimentos coinciden con ambas afirmaciones: aquí el control basado en prompts es viable pero inestable, y falla de formas difíciles de reproducir.
La superficie de salida es estrecha. Estos modelos emiten voz y algo de texto, no los canales estructurados paralelos que necesita un sistema de operaciones, como una detección fiable del idioma, la identificación de quien llama, puntuaciones de sentimiento o decisiones de enrutamiento. Las fichas de los modelos en tiempo real de OpenAI indican que admiten llamadas a funciones, pero no admiten salidas estructuradas (ficha del modelo gpt-realtime-2). Recuperarlas implica acoplar un pipeline paralelo, lo que vuelve a introducir la latencia que intentabas evitar.
El coste es mayor. A agosto de 2026, el audio en tiempo real de gpt-realtime-2 se factura a $32 por millón de tokens de entrada y $64 por millón de tokens de salida (ficha del modelo); la misma guía estima que un agente con API en tiempo real es «entre 3 y 5 veces más caro» que su equivalente con un LLM de texto.
Ajustar un modelo de extremo a extremo: la vía más viable hacia una buena CX con control
Respuesta corta: traslada el comportamiento a los pesos en lugar de pelearte con el modelo a base de prompts, y págalo en computación e iteraciones de ingeniería.
La tercera opción, y según nuestra valoración la más prometedora a corto plazo, es ajustar un modelo de extremo a extremo para un caso de uso concreto. En lugar de pelearte en tiempo de ejecución con un modelo generalista a base de prompts, trasladas el comportamiento a los pesos: tu tono, tus reglas de escalación, tu vocabulario del sector, tus patrones de rechazo. Mantienes la latencia por debajo de un segundo y recuperas buena parte del control al que habías renunciado.
Hay dos salvedades importantes antes de que nadie haga planes en torno a esto.
La primera es la disponibilidad. A agosto de 2026, las principales API en tiempo real cerradas no ofrecen fine-tuning: las fichas de los modelos gpt-realtime y gpt-realtime-2 indican que no lo admiten. Hoy, la vía práctica pasa por los modelos de pesos abiertos. Ultravox (con licencia MIT) admite entrenamiento, pero solo el adaptador de audio es entrenable; el LLM subyacente y el codificador de audio permanecen congelados. Su propia documentación da una referencia de coste útil: la v0.4 necesitó 2–3 horas en 8×H100 para 14K pasos de entrenamiento (fixie-ai/ultravox). Qwen3-Omni se distribuye con licencia Apache 2.0 y el equipo lo ha ajustado por su cuenta, aunque el repositorio no documenta un flujo general de fine-tuning (QwenLM/Qwen3-Omni).
La segunda es el coste operativo, tanto de computación como de ingeniería. El fine-tuning no es un cambio de configuración; necesita recopilación de datos, entornos de evaluación y un equipo capaz de mantener el ciclo, y cada iteración lleva tiempo. Para un caso de uso acotado y de gran volumen, las cuentas salen. Para una larga cola de flujos de poco volumen, normalmente no, y por eso creemos que lo habitual serán los despliegues híbridos (pipelines en cascada para las rutas reguladas o poco frecuentes y un modelo de extremo a extremo ajustado para la conversación de mucho tráfico) más que una elección limpia entre las tres opciones.
La demanda no es hipotética: el 46% de los directivos encuestados citó el ajuste de modelos como clave para una mayor adopción de la IA de voz (Deepgram / Opus Research, State of Voice AI 2025). La misma encuesta concluyó que el 80% ya usa sistemas tradicionales de agentes de voz, mientras que solo el 21% está muy satisfecho con ellos.
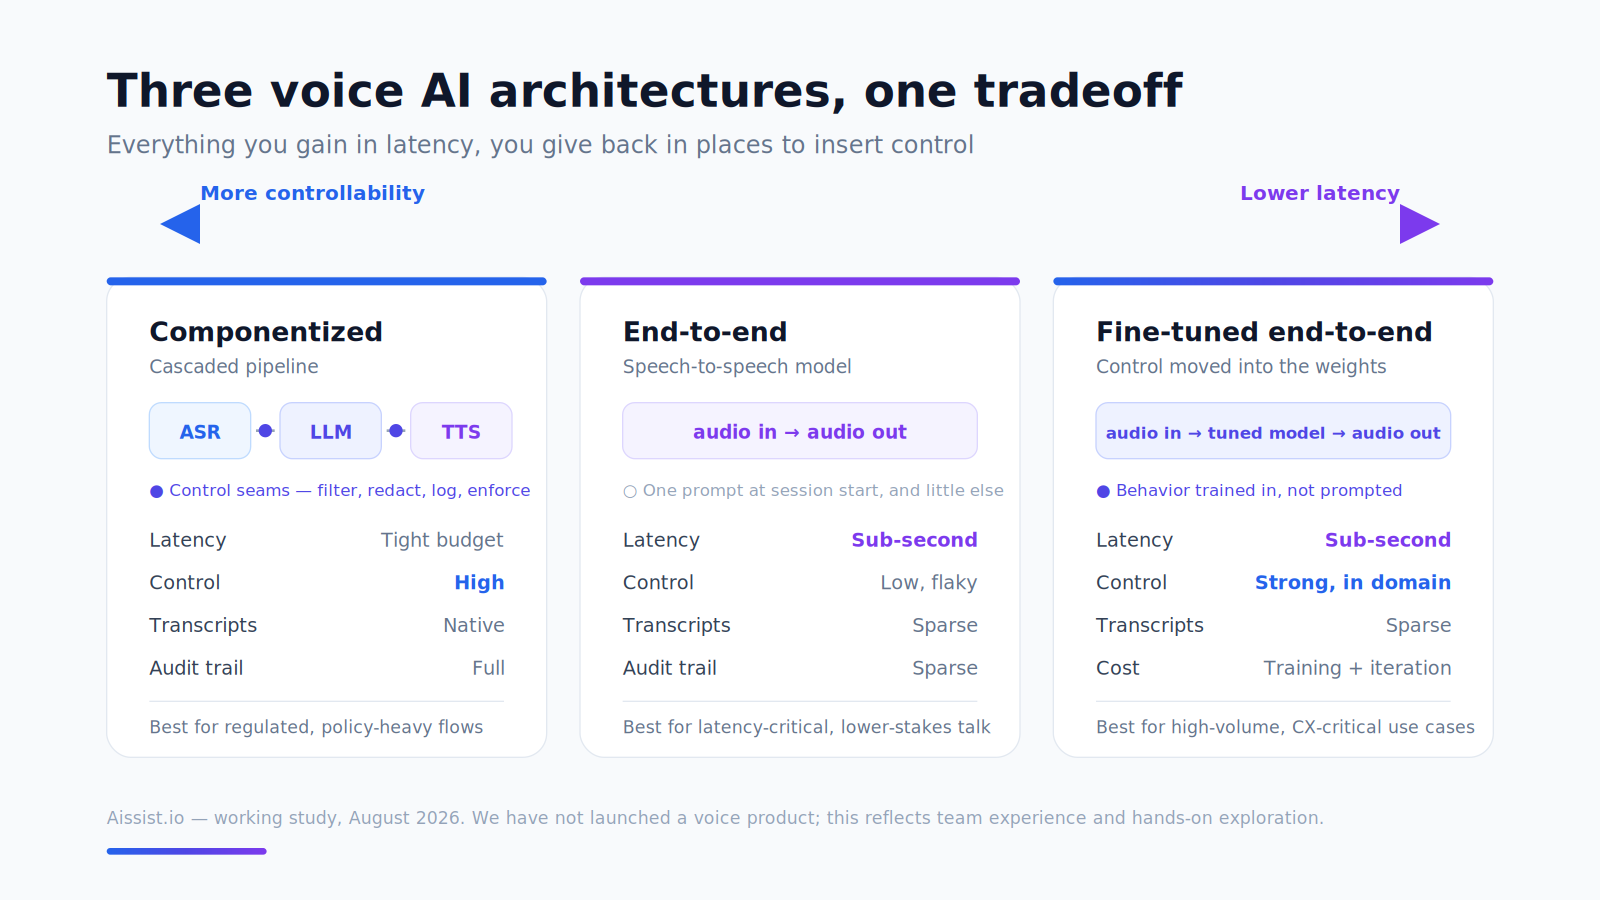
En cascada vs speech-to-speech: comparativa de las tres arquitecturas de IA de voz
Respuesta corta: en cascada para flujos regulados y con muchas políticas, de extremo a extremo para conversaciones donde la latencia es crítica, y de extremo a extremo ajustado para CX de gran volumen en la que puedas permitirte entrenar.
| Por componentes (ASR→LLM→TTS) | Speech-to-speech de extremo a extremo | De extremo a extremo ajustado | |
|---|---|---|---|
| Latencia típica | Presupuesto ajustado; un ciclo de ~1.3 s es bueno | Menos de un segundo posible con una buena red | Menos de un segundo, se mantiene |
| Puntos de control | Muchos: una salida en cada junta | Prompt al inicio de la sesión, y poco más | Pesos más un prompt pequeño |
| Personalización | Sencilla | Limitada y poco fiable | Sólida, dentro del dominio ajustado |
| Salidas que no son voz | Nativas (transcripciones, identificación del idioma, datos de quien llama) | Voz más texto limitado; sin salidas estructuradas | Siguen limitadas |
| Observabilidad y auditoría | Rastro de texto completo por turno | Escasa | Escasa |
| Perfil de costes | Por componente, en general más bajo | ~3–5× un agente con LLM de texto | Inferencia más entrenamiento e iteración |
| Mejor encaje | Flujos regulados, complejos y con muchas políticas | Conversación de bajo riesgo donde la latencia es crítica | Casos de uso de gran volumen, acotados y críticos para la CX |
La tendencia de la IA de voz para 2027 y más allá
Respuesta corta: gana el modelo de extremo a extremo, pero solo la versión capaz de recibir contexto en mitad de la conversación y emitir algo más que voz.
Varios equipos están ampliando estos límites de forma continua, y la distancia entre las dos arquitecturas se está cerrando por ambos extremos: los pipelines en cascada siguen recortando milisegundos con una mejor detección de turno y más paralelismo, mientras que los modelos de extremo a extremo siguen ganando en seguimiento de instrucciones y uso de herramientas.
Seguimos creyendo que el camino es el de extremo a extremo. Pero la versión que gane no será simplemente la más rápida. Será la que añada dos capacidades de las que carece la generación actual: la capacidad de inyectar contexto en mitad de la conversación, y no solo al inicio de la sesión, y la capacidad de personalizar la salida más allá de la voz (campos estructurados, señales de enrutamiento, nivel de confianza, identificación del idioma). Esos dos cambios cerrarían la mayor parte de la brecha de controlabilidad sin renunciar a la ventaja de latencia, y la dirección ya apunta hacia ahí: la ventana de contexto en tiempo real de OpenAI pasó de 32K a 128K en un solo ciclo de lanzamiento y, en nuestras propias pruebas, el seguimiento de instrucciones de los modelos en tiempo real ha mejorado notablemente en el último año.
Gartner prevé que la IA agéntica resuelva de forma autónoma el 80% de las incidencias habituales de atención al cliente en 2029 (Gartner, marzo de 2025). La voz es la mitad más difícil de esa previsión, y la cuestión de la arquitectura es el motivo.
Resumen
La arquitectura de la IA de voz es un compromiso entre controlabilidad y latencia, impuesto por un presupuesto de respuesta de aproximadamente dos segundos e idealmente inferior a uno. Los pipelines por componentes te dan control en cada junta y te obligan a trabajar por los milisegundos. Los modelos de extremo a extremo te dan los milisegundos y te quitan casi todos los puntos donde podrías haber insertado control. Ajustar un modelo de extremo a extremo es hoy la forma más viable de conseguir ambas cosas, a costa de computación e iteraciones de ingeniería. Enmascarar la latencia (muletillas, sonidos de tecleo, preámbulos hablados) compra unos cientos de milisegundos de tolerancia y nada más.
En Aissist.io no hemos lanzado voz. Seguimos este ámbito de cerca, hacemos nuestros propios experimentos y actualizaremos este estudio a medida que cambie el panorama.
¿Quieres comparar impresiones sobre voz o ya usas IA agéntica en texto? Descubre cómo AgentMesh™ resuelve el servicio y las ventas de principio a fin sobre el stack que ya utilizas. Reserva una consulta →
Preguntas frecuentes
¿Cuál es una buena latencia para un agente de IA de voz?
Mantente por debajo de dos segundos de extremo a extremo y aspira a bajar de un segundo cuando puedas. Twilio publica un objetivo de boca a oído de 1,115 ms con un límite superior de 1,400 ms, y una guía del sector muy utilizada señala 1,500 ms de voz a voz como meta. Como referencia, en una conversación natural las personas se turnan con un intervalo modal de unos 200 ms, y ningún agente de voz en producción se acerca todavía a eso.
¿Qué diferencia hay entre la arquitectura de IA de voz en cascada y la speech-to-speech?
Una arquitectura en cascada (por componentes) encadena componentes separados de ASR, LLM y TTS que se pasan texto entre sí. Una arquitectura speech-to-speech usa un único modelo que recibe audio y emite audio. La de cascada es más lenta, pero expone texto en cada etapa, que es donde residen el control, el filtrado y el registro. La speech-to-speech es más rápida, pero apenas ofrece puntos de intervención.
¿Qué arquitectura de IA de voz usan realmente la mayoría de los agentes en producción?
Según nuestra valoración, los pipelines por componentes ASR→LLM→TTS siguen representando la mayoría de los despliegues en producción, porque la mayoría de los casos de uso empresariales necesitan el control, las transcripciones y el registro de auditoría que proporciona la capa de texto. Los modelos de extremo a extremo están ganando terreno en conversaciones de menor riesgo donde la latencia es crítica, y los despliegues híbridos que envían distintos flujos a distintas arquitecturas son cada vez más habituales.
¿Se puede ajustar un modelo speech-to-speech?
No en las principales API en tiempo real cerradas a agosto de 2026: las fichas de los modelos gpt-realtime y gpt-realtime-2 de OpenAI indican que no admiten fine-tuning. El fine-tuning está disponible en modelos de pesos abiertos como Ultravox (MIT) y Qwen3-Omni (Apache 2.0), aunque Ultravox solo entrena el adaptador de audio, mientras que el LLM y el codificador permanecen congelados. Cuenta con un esfuerzo de ingeniería considerable en cada iteración.
¿Qué es la detección de turno en la IA de voz y en qué se diferencia de la VAD?
La detección de actividad de voz se limita a medir si alguien está hablando y espera al silencio: un temporizador, y además caro, ya que un umbral de silencio de 800 ms añade casi un segundo antes de que el pipeline siquiera empiece. La detección de turno usa un modelo para predecir si el hablante ha terminado realmente su idea. El modelo transformer de LiveKit se ejecuta en unos 50 ms, y combinarlo con VAD reduce las interrupciones involuntarias un 85% frente a usar solo VAD.
¿Las muletillas y los sonidos de tecleo hacen realmente que la IA de voz parezca más rápida?
Algo, y solo en el tiempo de respuesta percibido. Un estudio con 54 participantes concluyó que las muletillas naturales mejoraban significativamente la rapidez percibida con retrasos de 4.0 s y 6.5 s, mientras que los indicadores artificiales, como los iconos de carga y los tonos de procesamiento, no mostraban ninguna mejora significativa. El mismo estudio no halló ninguna mejora significativa en ninguna otra dimensión de la experiencia. Enmascarar compra tolerancia; no crea una sensación conversacional auténtica.
¿Por qué no se puede poner simplemente un prompt de sistema largo en un modelo de voz de extremo a extremo?
Porque el tamaño del prompt se paga directamente en latencia, que es la razón por la que elegiste un modelo de extremo a extremo. Las ventanas de contexto se han ampliado (los modelos en tiempo real de OpenAI pasaron de 32K a 128K tokens en mayo de 2026), pero el presupuesto práctico por sesión sigue siendo pequeño, y el seguimiento de instrucciones en modo speech-to-speech es menos fiable que en modo texto, así que un prompt más largo no compra proporcionalmente más control.
¿Cuánto más caro es un agente de voz de extremo a extremo?
A agosto de 2026, el precio del audio en tiempo real de gpt-realtime-2 es de $32 por millón de tokens de entrada y $64 por millón de tokens de salida. Una estimación del sector muy citada sitúa un agente con API en tiempo real en aproximadamente entre tres y cinco veces el coste de un agente comparable con un LLM de texto. Los despliegues ajustados con pesos abiertos cambian ese sobrecoste por token por computación de entrenamiento y un coste de ingeniería continuo.
¿Pueden los modelos de voz de extremo a extremo detectar el idioma o identificar a quien llama?
No de forma nativa como salida estructurada. Estos modelos emiten voz y algo de texto; las fichas de los modelos en tiempo real de OpenAI admiten llamadas a funciones, pero no salidas estructuradas. Obtener una identificación fiable del idioma, de quien llama, del sentimiento o señales de enrutamiento suele implicar ejecutar un pipeline paralelo junto al modelo, lo que vuelve a añadir parte de la complejidad y la latencia que la arquitectura pretendía evitar.