
Impacto en el negocio
En resumen
Qué pasó: la noche del 30 de octubre de 2026, una caída en el lado del operador cortó los datos móviles a los abonados de un proveedor global de telecomunicaciones, y el tráfico de soporte se multiplicó por unas 20x en una hora. Los agentes de IA de Aissist.io absorbieron el pico, y el tiempo medio de respuesta solo pasó de 14.7 a 16.7 segundos. Los clientes valoraron más el servicio de la IA justo cuando era más difícil darlo: pese a la caída, el CSAT de las conversaciones de la IA esa noche se mantuvo en 4.8 / 5.0. En unos 25 minutos, sin que nadie se lo pidiera, los agentes lo atribuyeron a un cliente, un síntoma y una causa: una caída de conectividad en el lado del operador. Tres capas independientes lo confirmaron. Los agentes incluso encontraron en las conversaciones una solución que funcionaba: cambiar un ajuste de red (el APN). Pero los agentes que hablaban con los clientes siguieron con su rutina estándar de resolución de problemas, porque ese hallazgo todavía no estaba conectado a nuestro motor de autoevolución.
Qué significa: esta noche fue un anticipo de cómo son las operaciones con IA. No solo respuestas automatizadas, sino un sistema que detecta cuándo cambia el entorno, entiende por qué y se adapta mientras el incidente sigue en curso. Detectar y entender ocurrió en minutos. Adaptarse es lo que estamos conectando ahora, para que la próxima vez que se encuentren una causa y una solución, se conviertan en la estrategia de los agentes en cuestión de minutos.
- Cliente: un proveedor global de servicios de telecomunicaciones (anonimizado)
- Sector: telecomunicaciones
- Casos de uso: atención al cliente con IA en picos de carga, detección de incidentes, análisis de causa raíz, información en tiempo real
- Impacto: 20x de tráfico absorbido, causa raíz encontrada en ~25 minutos, tres confirmaciones independientes
La noche del 30 de octubre de 2026, una caída en el lado del operador cortó los datos móviles a los abonados de uno de nuestros clientes de telecomunicaciones. Los teléfonos mostraban cobertura completa. No cargaba nada. En una hora, el tráfico de soporte era unas 20x el normal.
Metodología y fuentes
- Datos: telemetría de la plataforma Aissist.io, respuestas de Ask Engine y registros de alertas automáticas, 29–30 de octubre de 2026.
- Las horas son del Pacífico (hora del servidor). Los multiplicadores comparan el 30 de octubre con las mismas horas del 29 de octubre.
- Aviso: este es el blog de Aissist, y la empresa afectada es cliente de Aissist. La hemos mantenido en el anonimato.
¿Qué pasó cuando cayó el operador?
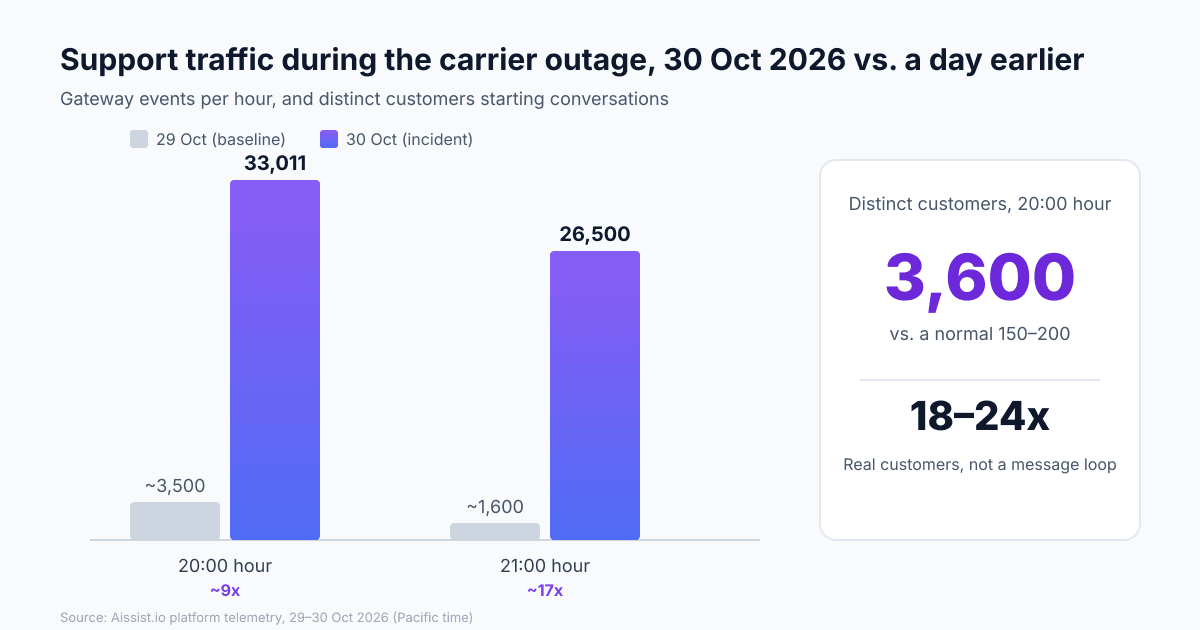
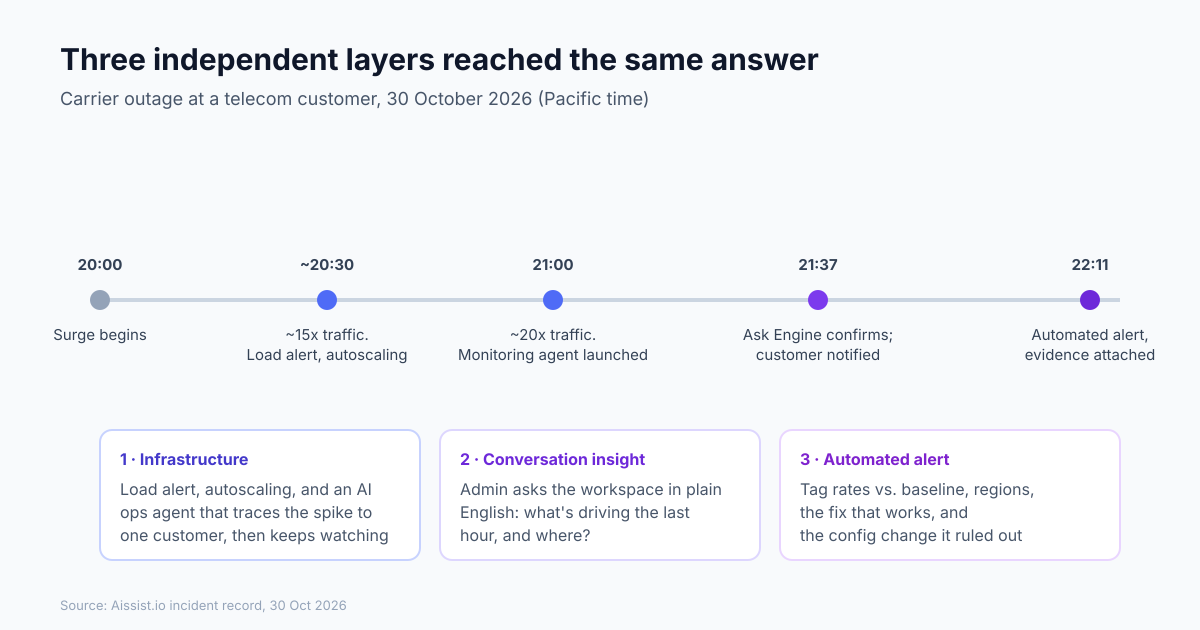
A partir de las 20:00, el volumen de conversaciones se multiplicó por unas 15x hacia las 20:30 y por unas 20x hacia las 21:00. Los eventos del gateway llegaron a 33,011 en la franja de las 20:00, frente a unos 3,500 a la misma hora del día anterior, y a 26,500 en la franja de las 21:00, frente a unos 1,600.
La cifra que más importaba eran las personas, no los eventos. Unos 3,600 clientes distintos iniciaron conversaciones en la franja de las 20:00, frente a los 150–200 habituales. Eso descartaba al sospechoso habitual de cualquier pico, un bucle de mensajes o una integración que funcionara mal. Eran abonados reales de varios países de Asia, y todos describían lo mismo: cobertura, pero sin datos.
La caída de un operador de telecomunicaciones no genera un goteo educado de tickets. Genera a todo el mundo a la vez. Un equipo dimensionado para 150 conversaciones por hora no absorbe 3,600. No es un fallo de plantilla. Es aritmética.
La plataforma aguantó. El autoescalado multiplicó varias veces el clúster de servicios de la zona afectada en menos de una hora, de 4 a 19 tareas de sesión y gateway y de 3 a 13 tareas del grafo de razonamiento, y el tiempo medio de respuesta solo pasó de 14.7 a 16.7 segundos.
Los clientes lo notaron. Quien no puede conectarse rara vez está de humor para perdonar, y aun así el CSAT de las conversaciones de la IA esa noche se mantuvo en 4.8 / 5.0. Los clientes valoran más que nunca una respuesta rápida y paciente en un momento difícil, y esa noche la recibieron en segundos, por muchos otros que estuvieran preguntando a la vez. Aguantar el ritmo fue la parte fácil.
¿Con qué rapidez encontró el sistema la causa?
Unos 25 minutos después del inicio de la caída, nuestros agentes de IA habían atribuido el pico a un cliente, un síntoma y una causa, sin que nadie se lo pidiera. La primera señal fue la carga de los servidores, a los 20 minutos aproximadamente. Un agente de IA de operaciones analizó entonces el sistema y concluyó que casi todo el tráfico procedía del workspace de un único cliente, que eran miles de personas distintas y que la causa era una caída de conectividad en el lado del operador, no algo de nuestro código.
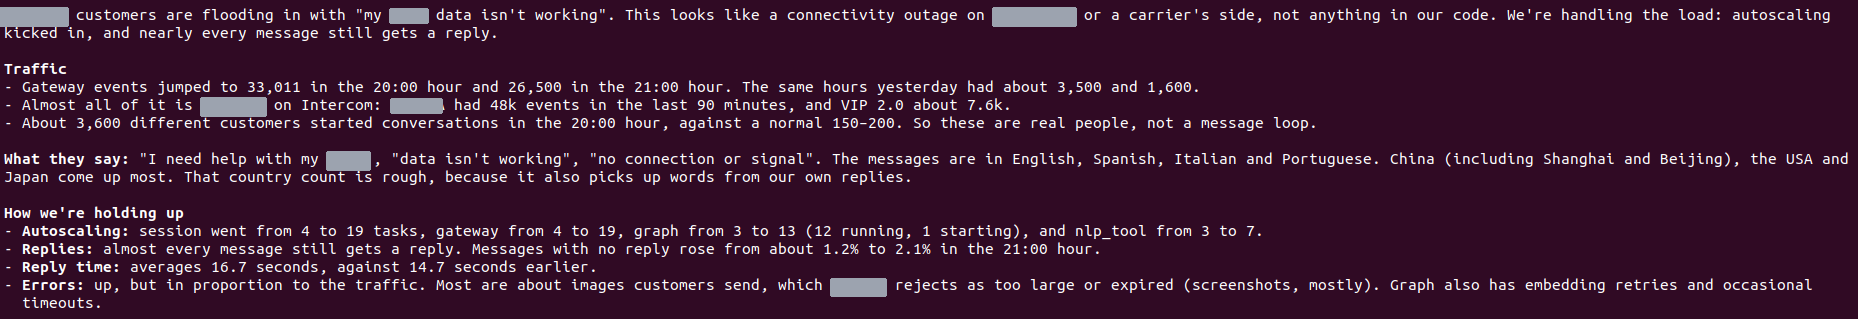
A las 21:00 se lanzó un segundo agente para vigilar la situación de forma continua: el volumen, las escalaciones y la forma de las conversaciones a medida que avanzaba la noche. Los incidentes cambian. Alguien tiene que seguir vigilando, y no tiene por qué ser una persona.
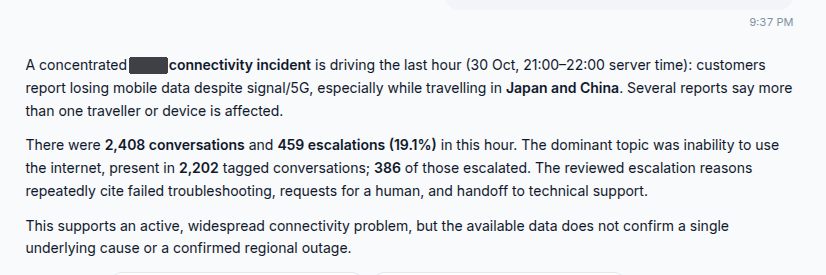
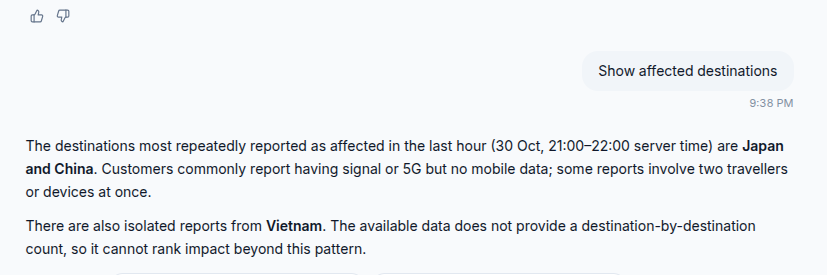
Después, otras dos capas confirmaron el diagnóstico de forma independiente. A las 21:37, un administrador de Aissist hizo una pregunta en lenguaje natural al workspace del cliente a través de Ask Engine: ¿qué está provocando lo de la última hora? La respuesta salió de las propias conversaciones: 2,408 conversaciones, 2,202 de ellas sobre la pérdida de acceso a internet, concentradas en un puñado de destinos. También dijo lo que no podía confirmar, como una caída regional oficial. Una herramienta de análisis que se inventa certezas durante un incidente es peor que no tener ninguna.
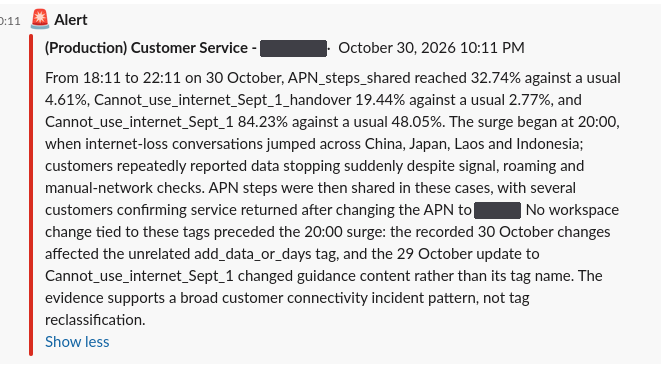
A las 22:11, una alerta automática que mide frente a la referencia a largo plazo del cliente completó el tres de tres:
| Señal (18:11–22:11) | Habitual | 30 de octubre |
|---|---|---|
| Conversaciones sobre la falta de acceso a internet | 48.05% | 84.23% |
| De ellas, traspasadas a una persona | 2.77% | 19.44% |
| Conversaciones en las que se compartieron los pasos de configuración de red (APN) | 4.61% | 32.74% |
También comprobó si el pico era autoinfligido, por ejemplo por una etiqueta renombrada, y lo descartó.
La IA encontró una solución. ¿Por qué no pudo usarla?
Nuestros agentes de IA encontraron una posible solución en las conversaciones, pero los agentes que hablaban con los clientes siguieron aplicando igualmente su rutina estándar de resolución de problemas. Varios clientes confirmaron que recuperaron los datos tras cambiar un ajuste de red, el APN. La alerta sacó a la luz exactamente eso.
Pero fíjate en el orden en que ocurrían las cosas en cada conversación. Los clientes contaban que primero habían pasado por comprobaciones de cobertura, ajustes de itinerancia y selección manual de red. Solo después se compartían los pasos del APN. Los agentes hacían lo que estaban diseñados para hacer en un día normal: recorrer el árbol de resolución de problemas paso a paso. Esa noche en concreto, la mayoría de esos pasos no podían ayudar, y la tasa de traspaso subió de alrededor del 3% al 19% a medida que los clientes, frustrados, pedían hablar con una persona.
El hallazgo existía. La estrategia no cambió. Esa brecha es la lección más importante de la noche.
Ocurrió porque el diagnóstico todavía no estaba conectado a nuestro motor de autoevolución, parte de Evolve™, que ya hemos construido precisamente para esta situación. Con esa conexión, habría cambiado el enfoque de los agentes en cuanto se conocieron la causa y la solución: avisar a los clientes desde el principio de que hay un problema del operador, empezar por el cambio de APN, saltarse los pasos que no pueden ayudar y volver a la rutina estándar cuando se resuelva la caída. Los clientes habrían llegado a la respuesta correcta en muchos menos pasos, y muchos menos habrían necesitado a una persona.
¿Qué estamos cambiando para el próximo incidente?
Estamos trabajando en cuatro cosas, y la primera es la que más importa.
| Lo que estamos construyendo | Lo que cambia |
|---|---|
| Motor de autoevolución conectado a la gestión de incidentes | En cuanto se encuentran una causa y una solución, la IA cambia su estrategia en cuestión de minutos |
| Notificación automática más rápida | El cliente recibe la alerta casi al mismo tiempo que la señal de carga de los servidores, no dos horas después |
| Arranque más rápido del agente de vigilancia | La vigilancia continua empieza en el momento de la detección, no a los 30 minutos |
| Memoria compartida entre agentes | Lo que aprende un agente lo saben todos, así que el próximo incidente parte de la experiencia |
El 30 de octubre, el agente de infraestructura, Ask Engine y la alerta llegaron cada uno por su cuenta a la misma conclusión, y los agentes que hablaban con los clientes nunca se enteraron. Con la memoria compartida y la autoevolución conectadas, la conclusión se convierte en la estrategia. Las personas lo llaman experiencia. Nuestros agentes están a punto de tenerla también.
Los agentes de IA deben adaptarse, no solo responder
Este incidente muestra para qué sirve la próxima generación de IA de soporte. Responder a 3,600 personas por hora es el mínimo. El verdadero trabajo es leer cada conversación como una señal, relacionarla con lo que está pasando en los sistemas, encontrar la causa y la solución, y cambiar el comportamiento de la IA mientras el incidente sigue en curso. Así lo construimos en Aissist, como una capa operativa de IA: AgentMesh™ responde, Pulse™ explica y Evolve convierte lo que aprende en el siguiente paso. El 30 de octubre hicimos los dos primeros en minutos. El tercero es lo que estamos conectando ahora.
Preguntas frecuentes
¿Qué pueden hacer los agentes de IA durante un pico de tráfico de soporte?
Además de responder a cada cliente, los agentes de IA pueden rastrear la causa de un pico, vigilarlo de forma continua, encontrar en las conversaciones una solución que funcione y, cuando están conectados a un motor de autoevolución, cambiar su estrategia para empezar por esa solución.
¿Cómo puede la IA detectar la caída de un operador a partir de las conversaciones de soporte?
Comparando las tasas de temas y de escalación con una referencia normal. Durante este incidente, las conversaciones sobre la falta de acceso a internet pasaron del 48% al 84% del volumen, y los traspasos sobre ese tema subieron de alrededor del 3% al 19%.
¿Qué es un agente de IA autoevolutivo?
Un agente de IA autoevolutivo cambia su propia estrategia cuando cambian las condiciones, por ejemplo empezando por una solución conocida durante una caída en lugar de recorrer sus pasos estándar de resolución de problemas, y vuelve a la normalidad cuando se resuelve el problema.
¿El pico de tráfico ralentizó las respuestas de la IA?
Solo un poco. El tiempo medio de respuesta subió de 14.7 a 16.7 segundos en el pico, mientras el autoescalado multiplicaba varias veces el clúster de servicios.
¿Bajó la satisfacción de los clientes durante la caída?
No. El CSAT de las conversaciones de la IA esa noche se mantuvo en 4.8 / 5.0, aunque los clientes que escribían se habían quedado sin datos móviles.
¿Qué es Ask Engine de Aissist?
Ask Engine permite a un equipo hacer preguntas sobre sus conversaciones de soporte en lenguaje natural, como «¿qué está provocando lo de la última hora?», y obtener una respuesta a partir de los datos de conversación en tiempo real, incluido lo que esos datos no pueden confirmar.
M.W.
CofundadorM.W. es emprendedor en serie y cofundador de Aissist.io, con más de 12 años de experiencia práctica en machine learning e IA avanzada. Ha creado y dirigido el desarrollo de tres generaciones de sistemas de IA, desde la primera automatización con ML hasta las plataformas actuales de IA agéntica que sostienen operaciones a escala empresarial.