Por qué las alucinaciones de la IA en la atención al cliente son un problema de gobernanza
Las alucinaciones de la IA en la atención al cliente son la principal queja sobre los chatbots de IA, según el análisis de G2 de julio de 2026 de más de 2,950 reseñas verificadas. Unos modelos mejores no cierran esa brecha. La gobernanza, sí.
En resumen: la fiabilidad procede del sistema que rodea al modelo: el mejor modelo por sí solo sigue equivocándose en el 1.8% de los resúmenes fundamentados del benchmark de Vectara, mientras que el marco de gobernanza de cuatro capas de Aissist.io mantiene los errores de hechos y de política por debajo del 1%.
Metodología y fuentes
- Investigación de G2: más de 2,950 reseñas verificadas de AI Chatbots (del 1 de enero al 17 de julio de 2026) más una encuesta a proveedores, publicada el 31 de julio de 2026.
- Encuestas del sector: World Quality Report 2025 (más de 2,000 directivos, noviembre de 2025); Gong/Censuswide (2,056 responsables, del 6 al 9 de enero de 2026); Gartner (sondeo a 3,412 asistentes a un webinar, enero de 2025).
- Benchmark de modelos: Vectara Hallucination Leaderboard, resumen fundamentado de documentos, actualizado el 11 de mayo de 2026.
- Datos de Aissist: la tasa de error inferior al 1% es declarada por el proveedor: cualquier error de hechos o de política en una respuesta o acción de la IA, medido mediante una auditoría automática de las transcripciones con un LLM más un muestreo de control de calidad humano. Consulta cómo se clasifican los errores por gravedad para ver qué cuenta como error.
- Todas las cifras se verificaron en septiembre de 2026. Aviso: este es el blog de Aissist, y el marco de gobernanza que se describe a continuación es nuestro.
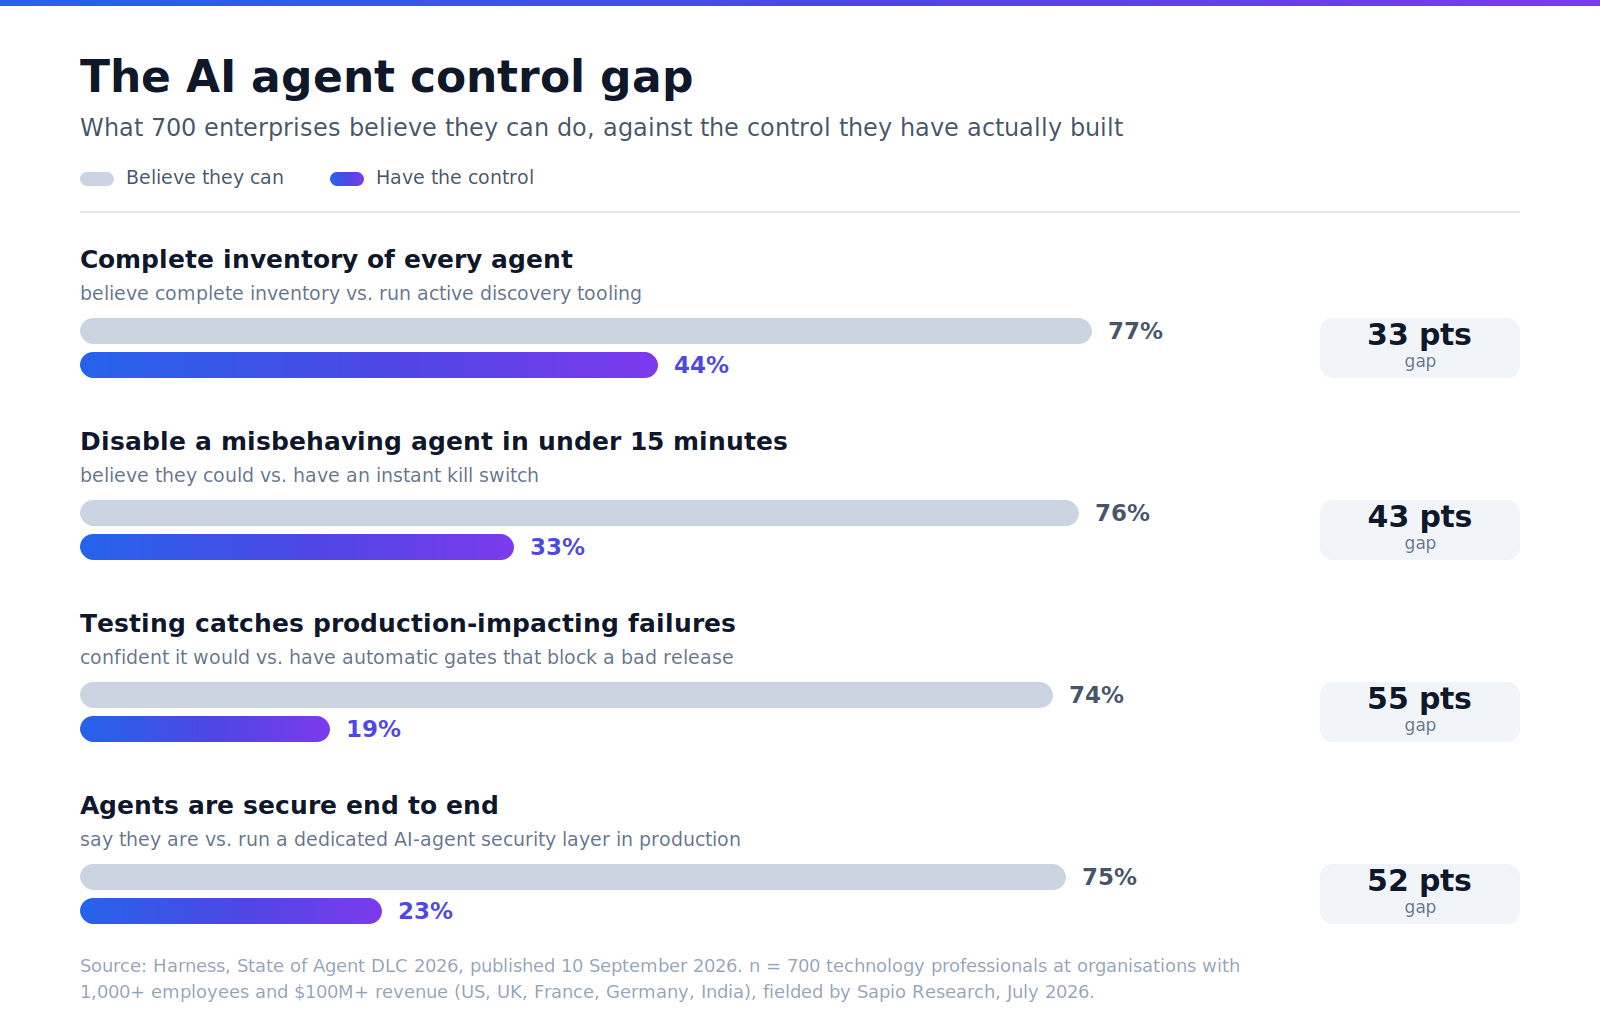
Este artículo explica por qué se producen las alucinaciones de la IA en producción y la capa de gobernanza que las detecta. Para los controles que les faltan a la mayoría de las empresas, consulta la brecha de gobernanza de los agentes de IA. Para soluciones cotidianas a nivel de prompt, consulta 7 consejos para evitar las alucinaciones.
¿Cuál es el mayor problema al desplegar chatbots de IA?
La precisión es el mayor problema al desplegar chatbots de IA. El análisis de G2 concluyó que los reseñadores verificados mencionan la precisión y las alucinaciones el 13.7% de las veces al describir lo que no les gusta, lo que la convierte en la queja número uno.
No es una preocupación minoritaria. El World Quality Report 2025 concluyó que la preocupación por las alucinaciones y la fiabilidad bloquea la IA a escala empresarial en el 60% de las organizaciones. La encuesta de Gong de abril de 2026 concluyó que el 58% de las empresas tiene proyectos de IA estancados. Y Gartner predice que más del 40% de los proyectos de IA agéntica se cancelarán antes de finales de 2027, por el aumento de los costes, un valor de negocio poco claro o unos controles de riesgo insuficientes.
Lo que hace peligrosas las alucinaciones no es que se produzcan. Es que suenan bien.
«Alucina con total seguridad. Me ha generado fórmulas DAX y joins de SQL que parecían perfectamente correctos pero eran lógicamente erróneos». — Sandeep J, reseñador verificado de AI Chatbots, G2
En la atención al cliente, una respuesta errónea dada con seguridad es una promesa. En Moffatt v. Air Canada (febrero de 2024), el chatbot de la aerolínea se inventó una política de reembolso para tarifas por duelo. Air Canada argumentó que el chatbot era responsable de sus propias acciones. El Civil Resolution Tribunal de la Columbia Británica no se dejó convencer y condenó a la aerolínea a pagar $812.02.
«Debería ser obvio para Air Canada que es responsable de toda la información de su sitio web». — Christopher Rivers, miembro del tribunal, BC Civil Resolution Tribunal, Moffatt v. Air Canada, según McCarthy Tétrault
La multa fue pequeña. El precedente, no: las respuestas de tu IA son las respuestas de tu empresa.
¿Por qué un modelo mejor no resolverá las alucinaciones de la IA en la atención al cliente?
Un modelo mejor reduce la tasa de error por respuesta, pero la atención al cliente multiplica las respuestas. En el Hallucination Leaderboard de Vectara, incluso el mejor modelo introduce información falsa en el 1.8% de los resúmenes fundamentados, y modelos insignia muy utilizados como Gemini 2.5 Pro, GPT-4o y Claude Sonnet 4.5 obtienen entre el 7.0% y el 12.0%.
Ese benchmark es el caso fácil: resumir un documento que te han dado. Una conversación de soporte es más difícil. El agente lee el ticket, consulta el pedido, comprueba la política, decide una acción, llama a una API y redacta la respuesta. Según la página de IA fiable de Aissist, una sola ejecución se descompone en entre 12 y 20 tareas, cada una con su propia probabilidad de salir mal.
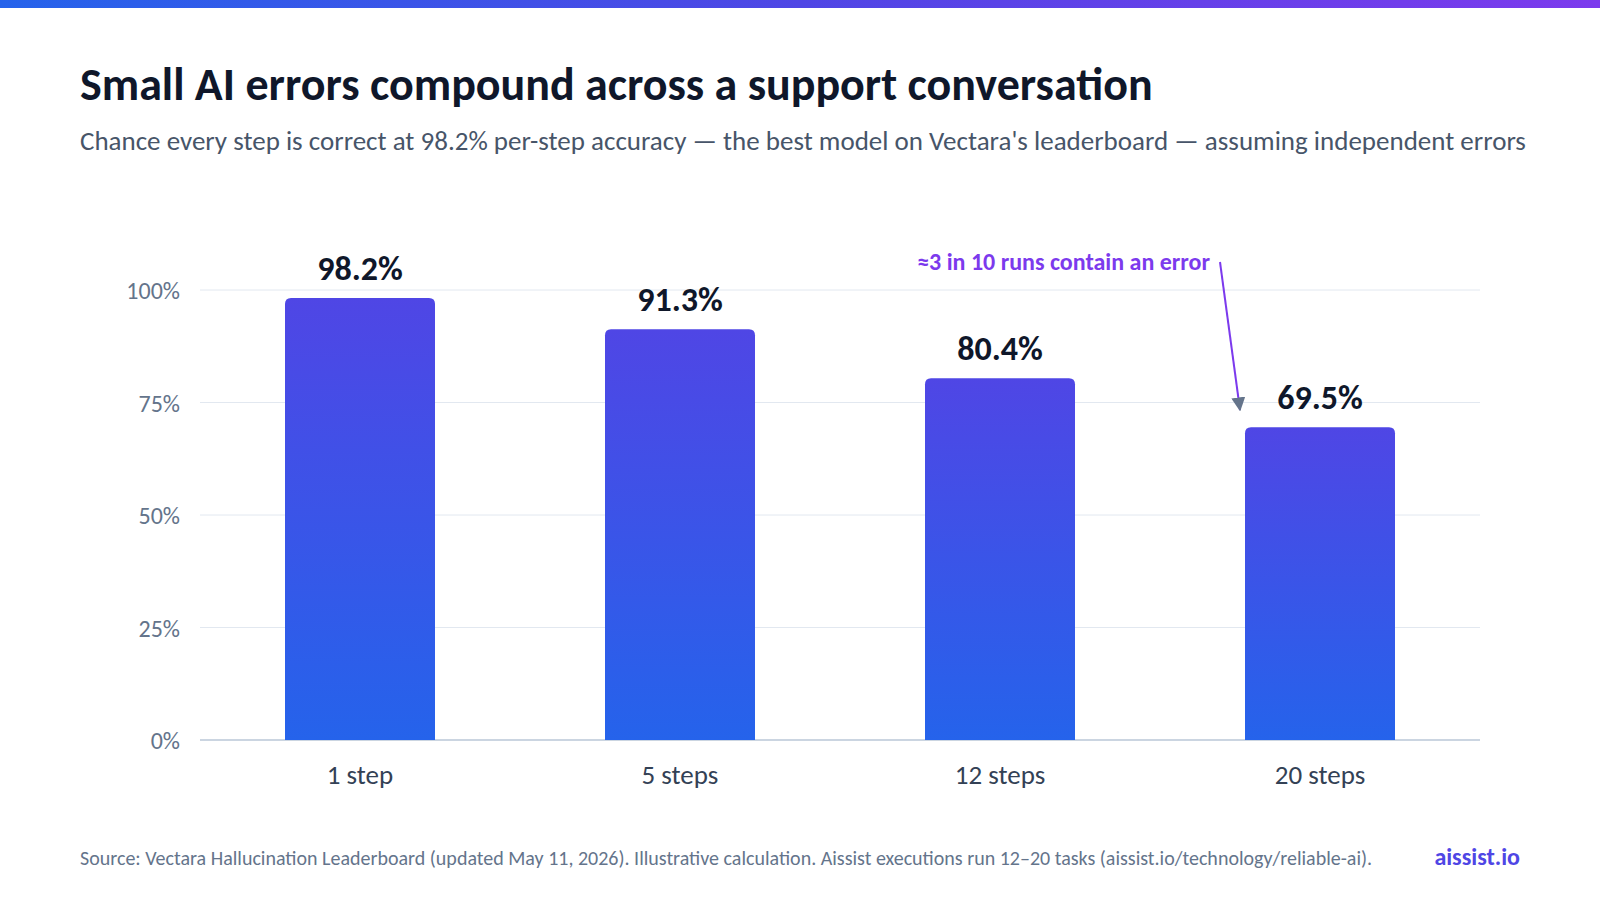
Las tasas de error pequeñas se acumulan. Si cada paso fuera tan preciso como el mejor modelo del benchmark de Vectara (98.2%) y los errores fueran independientes, la probabilidad de una ejecución limpia caería rápidamente:
| Pasos en una ejecución | Probabilidad de que todos los pasos sean correctos |
|---|---|
| 1 | 98.2% |
| 5 | 91.3% |
| 12 | 80.4% |
| 20 | 69.5% |
Cálculo ilustrativo a partir de la tasa más baja publicada por Vectara; la precisión real por paso varía.
Un modelo del 98% suena excelente hasta que te das cuenta de que una conversación de soporte no es una sola pregunta. Con 20 pasos, aproximadamente tres de cada diez ejecuciones contienen al menos un error. Cambiar al modelo del próximo trimestre recorta esa cifra. No cambia la forma de la curva.
«El relato infravalora hasta qué punto la calidad de un agente depende de la fontanería y no de la inteligencia». — Becca Xu, AI Agent Product Manager, Assembled, en la investigación de G2
G2 encontró el mismo patrón desde el otro lado. Los proveedores que construyen sobre los mismos modelos fundacionales de los que se quejan sus reseñadores declaran tasas de fallo de apenas el 1%. La diferencia no es el modelo. Es lo que detecta los errores del modelo antes de que un cliente los lea.
¿Qué es un marco de gobernanza de la IA para la atención al cliente?
Un marco de gobernanza de la IA para la atención al cliente es un conjunto de controles que rodea al modelo y decide si cada salida es lo bastante fiable para enviarse, necesita otro intento o pasa a una persona. Convierte «lo ha dicho el modelo» en «lo ha verificado el sistema».
El marco de IA fiable de Aissist.io utiliza cuatro capas. Ninguna capa basta por sí sola; intercambian coste por certeza, así que cada una se aplica donde el riesgo lo justifica.
| Capa | Qué hace | Qué detecta | Coste | Uso más adecuado |
|---|---|---|---|---|
| Ingeniería de prompts | Da a cada agente una postura de fiabilidad clara y unos guardarraíles compartidos antes de empezar a trabajar | Comportamientos fuera de política, por diseño | Bajo | Todos los agentes, siempre |
| Booster | Ejecuta la misma tarea un número impar de veces, compara los resultados y sigue adelante con el de mayor acuerdo | Errores puntuales y aleatorios | Alto | Pasos críticos o de alto riesgo, como los reembolsos |
| Autoinspección | Se pregunta, antes de publicar, si la respuesta es fiable dado el contexto y la información disponibles | Respuestas sin respaldo o sin fundamentación | Medio | Controles previos a la salida en las respuestas de cara al cliente |
| Sistema apilado | Un gobernador independiente (una capa de policía de la IA) supervisa el comportamiento y las salidas de cada agente frente a la política | Infracciones de la política en flujos de trabajo multiagente | Alto | Control de la política y escalación en todo el sistema |
Piénsalo como la diferencia entre un nuevo empleado con talento y un equipo bien dirigido. El empleado es el modelo. El equipo añade una lista de comprobación (ingeniería de prompts), una segunda opinión en las decisiones arriesgadas (booster), una autorrevisión antes de pulsar enviar (autoinspección) y un supervisor que conoce el manual de políticas (sistema apilado).
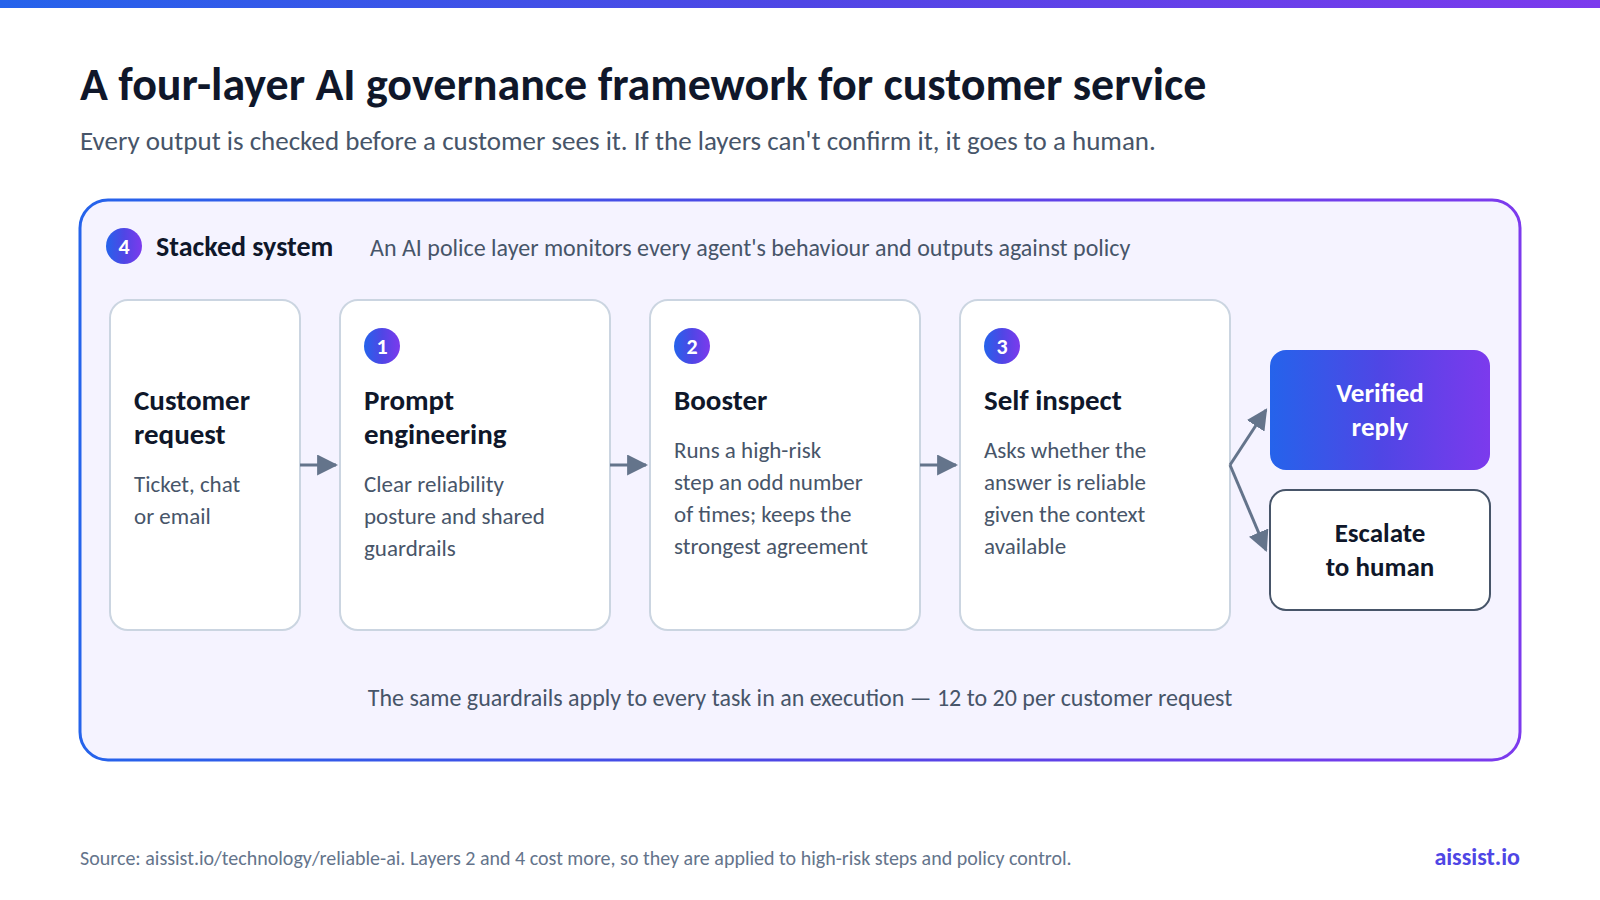
El último paso es el más importante. Cuando las capas no consiguen ponerse de acuerdo en que una respuesta es fiable, la salida correcta es un traspaso, no una suposición.
«La autonomía sin una lógica de respaldo fiable no es una funcionalidad; es un riesgo». — Abby Schervish, Maven AGI, en la investigación de G2
La gobernanza también abarca lo que rodea a la respuesta. El marco de seguridad de Aissist añade el enmascaramiento automático de datos personales y registros de auditoría que recogen los accesos y los cambios, de modo que cada decisión puede rastrearse a posteriori.
¿Hasta dónde puede bajar la tasa de error de la IA con gobernanza?
Con las cuatro capas implantadas, los agentes de Aissist.io mantienen los errores de hechos y de política por debajo del 1% de las respuestas y acciones de la IA, una cifra declarada por el proveedor y medida mediante una auditoría automática de las transcripciones con un LLM más un muestreo de control de calidad humano. Eso la sitúa en la parte baja de lo que recogió la encuesta a proveedores de G2.
Una tasa de error solo tiene sentido junto a lo que no cuenta. Una tasa de error baja no dice nada sobre cuántas conversaciones terminó el agente: un agente que lo escala todo tiene una tasa de error excelente y no resuelve nada. La gobernanza no hace que un agente responda a todo. Hace que el agente se detenga cuando no debería responder.
Ese es el intercambio que un sistema gobernado hace a propósito: menos respuestas dadas con seguridad, muchísimas menos erróneas. Para un responsable de soporte, un sincero «déjame consultarlo con un compañero» tiene arreglo. Una política de reembolsos inventada es una resolución de un tribunal.
«Un cliente puede perdonar a una IA que dice "no estoy seguro, déjame pasarte con una persona". No perdona a una que se inventa una política de reembolsos. Construimos la gobernanza para que nuestros agentes sepan distinguirlo». — M.W., cofundador de Aissist.io
Aplicamos a nuestras propias cifras el mismo criterio, lo que significa decir claramente que nuestra tasa de error inferior al 1% la mide el propio proveedor y no está auditada de forma independiente. Trátala como deberías tratar la de cualquier proveedor: como una afirmación que debes poner a prueba con tus propios tickets.
¿Cómo evalúas la gobernanza de un proveedor de IA?
Pregunta a los proveedores cómo definen, miden y detectan los errores, no solo lo bueno que es su modelo. Todos los proveedores tienen una tasa de alucinaciones. Algunos la publican, menos la definen y menos aún te explican cómo se midió.
| Pregunta que hacer | Una buena respuesta | Una señal de alarma |
|---|---|---|
| ¿Qué cuenta como error? | Errores de hechos y de política, por respuesta o acción | Solo «alucinaciones», sin definir |
| ¿Cómo se mide? | Auditoría automática de las transcripciones más un muestreo de control de calidad humano, con tamaño de muestra y periodo | Un benchmark del proveedor o un conjunto de demostración |
| ¿Qué pasa cuando la IA no está segura? | Escalación estructurada a una persona con el contexto adjunto | La IA siempre responde |
| ¿Qué pasos tienen controles adicionales? | Acciones de alto riesgo identificadas (reembolsos, cancelaciones, cambios de cuenta) con votación o inspección | Un único prompt de guardarraíl para todo |
| ¿Se puede auditar una decisión más tarde? | Registros de auditoría completos de respuestas, acciones y controles de política | Solo las transcripciones del chat |
Después, aplica unas reglas sencillas:
- Si tu IA realiza acciones (reembolsos, cambios en pedidos), exige controles a nivel de paso, como la votación o la inspección, en esas acciones, porque una llamada errónea a una API cuesta más que una frase errónea.
- Si estás en un sector regulado o con mucha responsabilidad legal, exige una capa de supervisión de la política y registros de auditoría, porque tendrás que demostrar qué hizo la IA y por qué.
- Si un proveedor cita una tasa de error sin definición ni denominador, haz un piloto con tus propios tickets antes de firmar, porque esa cifra no se construyó para poder comprobarse.
La fiabilidad es una propiedad del sistema, no del modelo
Las alucinaciones son la queja número uno en los datos de G2 porque la mayoría de los compradores se encuentran con la IA como un modelo en bruto: haces una pregunta y te fías de la respuesta. Los proveedores que declaran tasas de fallo bajas ejecutan los mismos modelos dentro de sistemas que comprueban, votan, inspeccionan y escalan.
La atención al cliente eleva lo que está en juego. Las respuestas tienen varios pasos, los clientes actúan en función de ellas y los tribunales las tratan como declaraciones de la empresa. La solución no es esperar a un modelo que nunca alucine. Es un marco de gobernanza que detecte los errores antes de que los vean los clientes y que traspase el caso cuando se acabe la certeza.
Pon a prueba la tasa de error con tus propios tickets. AgentMesh™ de Aissist.io ejecuta las cuatro capas de gobernanza en el helpdesk que ya utilizas. Solicita una demo gratuita →
Preguntas frecuentes
¿Qué es una alucinación de la IA en la atención al cliente?
Una alucinación de la IA en la atención al cliente es una respuesta dada con seguridad pero falsa por parte de un agente de IA, como una política inventada, un estado de pedido erróneo o una regla de reembolso inventada. Es peligrosa porque los clientes actúan en función de ella y se puede responsabilizar a las empresas.
¿Por qué alucinan los chatbots de IA?
Los chatbots de IA alucinan porque los modelos de lenguaje generan la respuesta más plausible, no una verificada. La falta de conocimiento o un conocimiento contradictorio, las preguntas ambiguas y las tareas largas de varios pasos aumentan la probabilidad de que se cuele un error.
¿Puede la generación aumentada por recuperación (RAG) eliminar las alucinaciones?
No. La RAG basa las respuestas en tus documentos, lo que ayuda, pero no elimina las alucinaciones. El leaderboard de Vectara mide justo ese escenario fundamentado, e incluso el mejor modelo sigue añadiendo información falsa al 1.8% de los resúmenes, así que siguen haciendo falta controles de la salida.
¿Cuál es una tasa de error aceptable de la IA en el soporte al cliente?
No hay un estándar del sector, así que compara tasas solo cuando compartan una definición (de hechos, de política o ambas), una unidad (por respuesta o por conversación) y un método. Si no, la cifra más baja puede deberse simplemente a una definición más restrictiva.
¿Es una empresa responsable de lo que dice su chatbot de IA?
A menudo, sí. En Moffatt v. Air Canada (2024), un tribunal canadiense declaró a la aerolínea responsable de la información incorrecta sobre reembolsos que dio su chatbot. La responsabilidad varía según la jurisdicción, así que consúltalo con un asesor jurídico; esto no es asesoramiento legal.
¿Cómo se mide la tasa de error de un agente de IA?
Audita las transcripciones automáticamente con un evaluador LLM en busca de errores de hechos y de política, y confírmalo después con un muestreo de control de calidad humano. Informa de los errores por respuesta o acción, con el tamaño de la muestra y el periodo, para que la tasa se pueda comprobar.
¿La gobernanza de la IA hace que las respuestas sean más lentas o más caras?
Algunas capas, sí. Los controles del booster y del sistema apilado añaden coste de cómputo, así que se aplican a los pasos de alto riesgo y no a cada frase. La ingeniería de prompts y la autoinspección son más ligeras y se ejecutan en todas partes.
Fuentes
- G2, AI Chatbot Capabilities & Limitations: What 2000+ G2 Users Say: más de 2,950 reseñas verificadas, del 1 de enero al 17 de julio de 2026, más una encuesta a proveedores; publicado el 31 de julio de 2026. Consultado el 15 de septiembre de 2026.
- OpenText, Capgemini y Sogeti, World Quality Report 2025: más de 2,000 altos directivos, publicado el 13 de noviembre de 2025. Consultado el 15 de septiembre de 2026.
- Gong, Unlocking the "Trust Barrier" for Enterprise AI: 2,056 responsables de empresa, encuesta realizada por Censuswide del 6 al 9 de enero de 2026. Consultado el 15 de septiembre de 2026.
- Gartner, Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027, 25 de junio de 2025. Consultado el 15 de septiembre de 2026.
- Vectara, Hallucination Leaderboard, actualizado el 11 de mayo de 2026. Consultado el 15 de septiembre de 2026.
- McCarthy Tétrault, Moffatt v. Air Canada: A Misrepresentation by an AI Chatbot; CX Today, Court Orders Air Canada to Pay Out for Chatbot's Bad Advice. Consultado el 15 de septiembre de 2026.
- Aissist.io, IA fiable, AI Agent Reliability Benchmark 2026, Seguridad y cumplimiento. Consultado el 15 de septiembre de 2026.
Historial de cambios
- 15 de septiembre de 2026: publicado. Todas las cifras se verificaron con las fuentes primarias en esta fecha.