Los 7 mejores LLM gateways y routers de modelos en 2026, evaluados según lo que ocurre a mitad de conversación
Recopilado por Lifan Xu. Publicado el 24 de septiembre de 2026 · Última actualización: 24 de septiembre de 2026.
Un LLM gateway coloca una única API entre tus agentes y todos los proveedores de modelos, y en 2026 los siete que merecen estar en tu lista corta gestionan el failover. La diferencia está en lo que hacen con una conversación con un cliente que va por la mitad cuando el modelo de origen deja de responder.
En resumen: todos los gateways de esta lista hacen failover de una petición; ninguno lo hace de una conversación. La propia documentación de OpenAI confirma que el estado de las respuestas almacenadas y las cachés de prompts se quedan en un único proveedor, así que tu aplicación debe ser la dueña de la transcripción, elijas el gateway que elijas.
Metodología y fuentes
- Siete gateways evaluados según cuatro criterios operativos: comportamiento ante fallos, estado a mitad de conversación, atribución de costes por petición y latencia añadida. El autoalojamiento y la licencia se indican, pero no se puntúan.
- Las cifras proceden de la documentación de cada proveedor y de sus README de GitHub. Todas las cifras de latencia las publica el propio proveedor; no hemos hecho nuestro propio benchmark de estos gateways.
- El comportamiento del estado y de la caché procede de las guías de OpenAI sobre estado de la conversación y caché de prompts.
- Todas las cifras se verificaron en septiembre de 2026. Aviso: este es el blog de Aissist. Aissist vende agentes de IA para atención al cliente, no un LLM gateway, así que ningún producto de esta lista es nuestro.
¿Qué diferencia hay entre un LLM gateway, un router de modelos, un proxy y un plano de control?
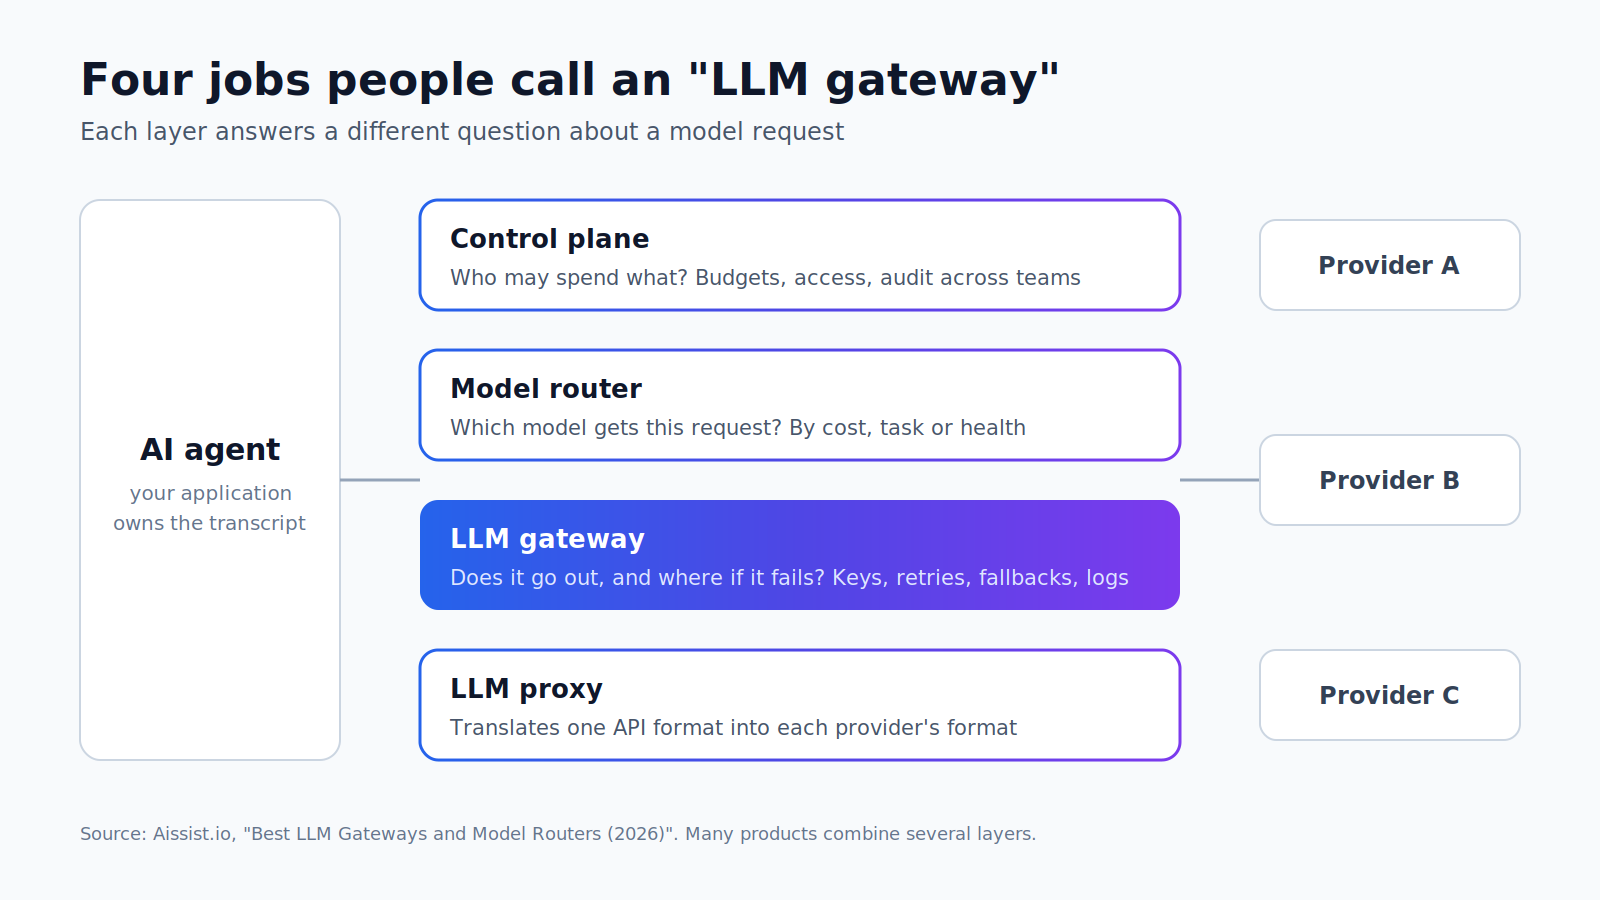
Un LLM gateway es el único endpoint al que llama tu aplicación; un router, un proxy y un plano de control son tres funciones que se sitúan dentro o alrededor de él. La primera página de Google usa las cuatro palabras para referirse a lo mismo. No son lo mismo.
| Término | Qué decide | Ejemplo |
|---|---|---|
| Proxy de LLM | Nada. Traduce un formato de API a los formatos de muchos proveedores | El SDK de Python de LiteLLM |
| Router de modelos | Qué modelo recibe esta petición: por coste, tarea o estado de salud | El Auto Router de OpenRouter |
| LLM gateway | Si la petición sale y adónde va si falla: claves, reintentos, fallbacks, límites de frecuencia, registros | Portkey, Cloudflare AI Gateway |
| Plano de control | La política de todo lo anterior entre equipos: presupuestos, acceso, auditoría | Kong Konnect, Prisma AIRS |
La prueba práctica: un proxy te ahorra escribir adaptadores, un router te ahorra dinero, un gateway te salva la disponibilidad y un plano de control te salva la revisión de seguridad. Queda una colisión más por aclarar. En nuestro propio sitio, los gateways de Aissist son las conexiones con tu helpdesk y tu CRM, no con los proveedores de modelos. La misma palabra, en el extremo opuesto del agente. El sector llamó «gateway» a todo a la vez y ahora lo está pagando en los resultados de búsqueda.
¿Cuáles son los mejores LLM gateways en 2026?
LiteLLM es la mejor opción por defecto para autoalojar, y Vercel AI Gateway u OpenRouter son las formas más rápidas de empezar con un servicio gestionado. Portkey lidera en gobernanza, Bifrost en sobrecarga bruta, Kong para los equipos que ya lo usan y Cloudflare en caché en el edge. La tabla evalúa cada uno en las cuatro cosas que fallan en producción.
| Gateway | Comportamiento ante fallos | Estado a mitad de conversación | Atribución de costes por petición | Latencia añadida, publicada por el proveedor (sep. 2026) | Autoalojamiento | Licencia |
|---|---|---|---|---|---|---|
| LiteLLM | Fallbacks ordenados tras los reintentos; periodos de enfriamiento; fallbacks separados para ventana de contexto y política de contenido | Sin estado por petición | Gasto por clave, equipo y usuario | 8 ms p95 (4 instancias, 1,170 RPS) | Sí | MIT |
| Portkey (Palo Alto Networks) | Lista ordenada; cualquier respuesta distinta de 2xx por defecto, o los códigos de estado que elijas | Sin estado por petición | Coste por petición | "<1ms" | Sí | MIT (gateway) |
| OpenRouter | Array models; por longitud de contexto, moderación, límite de frecuencia, caída del servicio | Sin estado por petición | Se factura según el modelo que realmente respondió | No publicada | No | Propietaria |
| Vercel AI Gateway | Orden de proveedores más fallbacks de modelo; con BYOK puede recurrir a las credenciales del sistema | Sin estado por petición | Coste y cada intento de enrutamiento registrados por petición | "sub-20ms" | No | Propietaria |
| Cloudflare AI Gateway | Ante errores o tiempos de espera predefinidos; la cabecera cf-aig-step muestra qué paso respondió | Sin estado por petición | Analítica de costes agregada | No publicada | No | Propietaria |
| Kong AI Gateway | Hace failover cuando un proveedor va lento o no está disponible | Sin estado por petición | «Coste real de cada petición», incluidos la caché y el nivel de servicio | No publicada | Sí | Núcleo Apache 2.0; funciones de IA avanzadas comerciales |
| Bifrost (Maxim) | Fallbacks automáticos entre proveedores y claves | Sin estado por petición | Presupuestos por clave virtual, equipo y cliente | 11 µs (5,000 RPS, t3.xlarge) | Sí | Apache 2.0 |
- LiteLLM: el mejor para autoalojar y controlar el gasto de varios equipos. Los benchmarks de LiteLLM muestran una sobrecarga de 8 ms p95 con cuatro instancias, pero de 29 ms p95 con dos. En contra: esa sobrecarga depende de cuántas instancias ejecutes.
- Portkey: el mejor para empresas con mucho peso en gobernanza. Palo Alto Networks completó su adquisición el 29 de mayo de 2026. En contra: la hoja de ruta depende ahora de una empresa de seguridad, para bien o para mal.
- OpenRouter: el mejor para probar muchos modelos rápido. En contra: el uso con clave propia por encima de $25,000 al mes conlleva una comisión del 5%, según sus preguntas frecuentes.
- Vercel AI Gateway: el mejor para equipos sin presupuesto de operaciones. Añade «cero margen sobre los precios por token de los proveedores, también con BYOK», según indica la documentación de Vercel. En contra: los presupuestos solo cubren el gasto con credenciales del sistema, así que el gasto con BYOK se controla por separado.
- Cloudflare AI Gateway: el mejor para la caché en el edge de prompts repetidos. En contra: no hay cifra de sobrecarga publicada ni opción de autoalojamiento.
- Kong AI Gateway: el mejor si Kong ya gestiona tus API. En contra: las funciones de IA avanzadas están en el plan comercial.
- Bifrost: el mejor para tráfico autoalojado en el que la latencia es crítica. En contra: los 11 µs son un benchmark del proveedor en una instancia elegida por el proveedor.
Fíjate en la columna del estado. Dice lo mismo siete veces, y esa es la conclusión.
«Enrutar cargas de trabajo de IA no deterministas a través de un gateway centralizado puede introducir latencia, complejidad de integración y un posible riesgo de concentración arquitectónica». — Stephanie Walter, Practice Leader, AI Stack, HyperFRAME Research
¿Qué le pasa a una conversación en curso cuando falla el modelo de origen?
El gateway reenvía el turno fallido al modelo de respaldo, y la conversación solo sobrevive si ese turno lleva el historial completo. Los gateways no tienen estado por diseño. Reintentan una petición; no recuerdan la conversación a la que pertenece.
Eso no era un problema cuando cada llamada era una carga de Chat Completions autocontenida. Sí lo es ahora que los proveedores guardan el estado por ti. Con la Responses API de OpenAI, un turno puede apuntar a previous_response_id en lugar de reenviar el historial, y los objetos de respuesta «se guardan durante 30 días por defecto», según la guía de estado de la conversación de OpenAI. Un fallback a Anthropic o Gemini no puede resolver ese ID. La solicitud de reembolso del cliente se convierte en el primer mensaje de un desconocido.
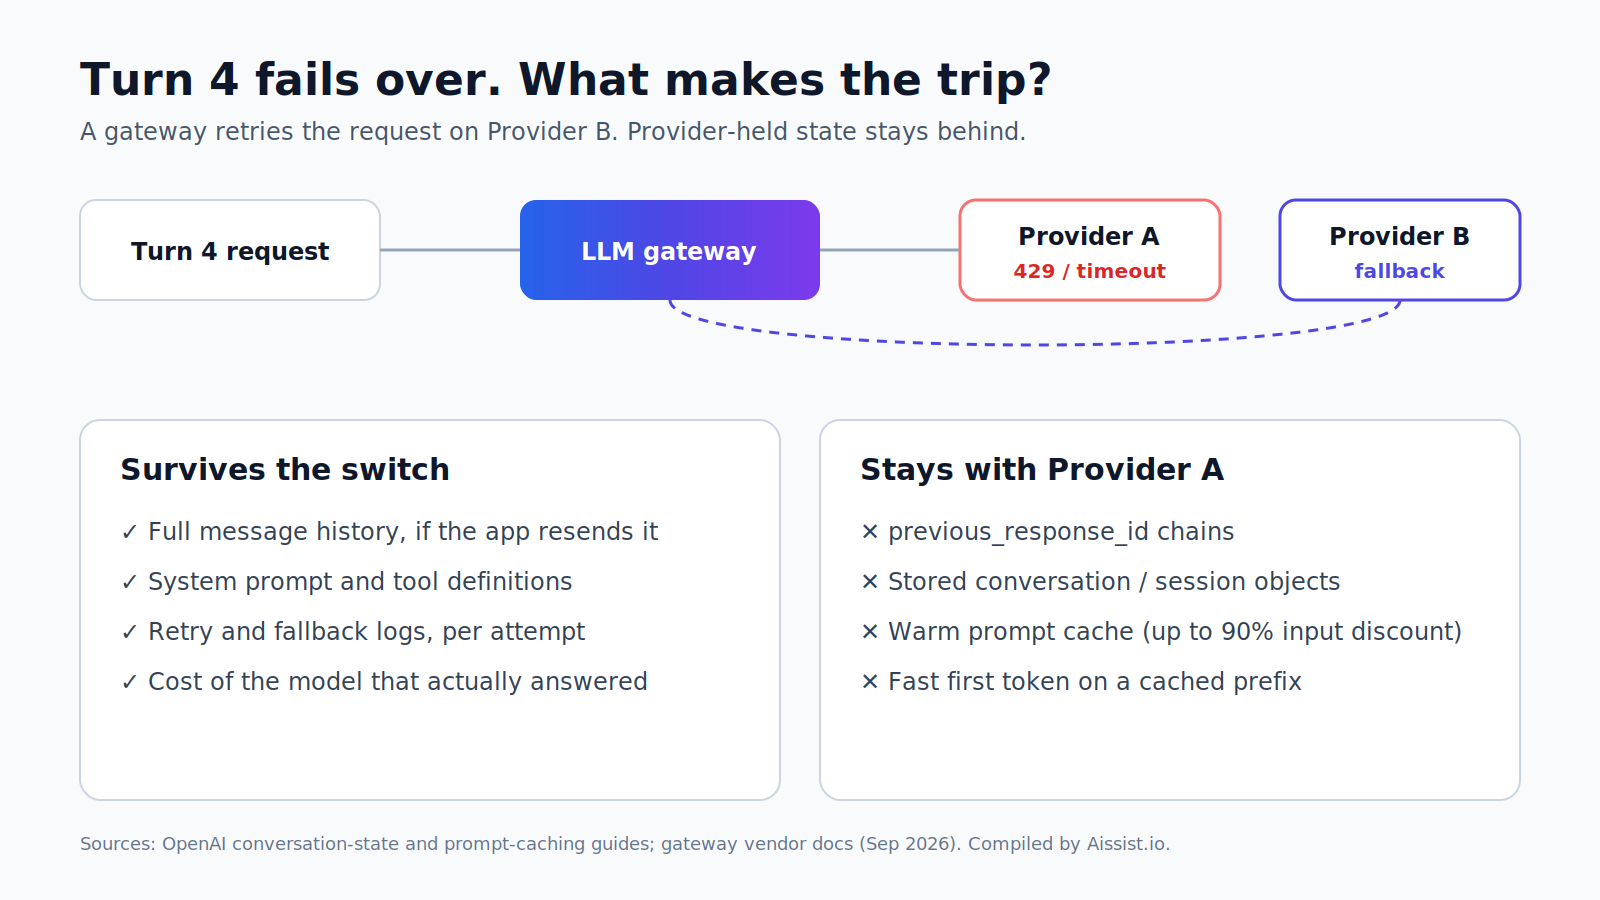
Las cachés se rompen del mismo modo. OpenAI aplica descuentos a la entrada en caché de «hasta el 90%», pero «las cachés no se comparten entre organizaciones», señala su guía de caché de prompts. Un proveedor distinto implica una caché fría. Así que el primer turno tras el failover es el más lento y el más caro de toda la conversación.
En el despliegue de AgentMesh™ de la propia Aissist, que funciona sobre la Responses API de OpenAI con caché de prompts por conversación, este es el coste que nunca aparece en la página de precios de un gateway. Un turno de respaldo empieza en frío: precio de entrada completo, primer token más lento, justo en el ticket que ya tenía problemas. Nuestra regla es que la aplicación almacena la transcripción y el gateway solo ve turnos completos.
«Si Prisma AIRS es la capa de seguridad en tiempo de ejecución para la IA, un gateway que intercepta y gobierna el tráfico de la API de LLM es una adyacencia natural». — Fernando Montenegro, VP and Practice Lead, Cybersecurity & Resilience, The Futurum Group
Nota fechada: la transición de AutoGen (a 24 de septiembre de 2026) El README de AutoGen indica ahora que AutoGen «está en modo de mantenimiento» y «no recibirá nuevas funciones ni mejoras», y remite a los nuevos usuarios a Microsoft Agent Framework. Si tus agentes funcionan con AutoGen, se avecina una migración; nuestra comparativa de frameworks de orquestación de agentes repasa las opciones. Mantén el acceso a los modelos detrás de un gateway y será un cambio de framework, no un cambio de framework más un recableado de proveedores.
¿Cómo deberías elegir un LLM gateway?
Elige en función de quién se hace cargo del fallo, no de cuántos modelos ofrece un gateway. Todos los gateways de esta lista llegan a los principales proveedores. Lo que cambia es dónde se ejecutan, quién paga sus errores y qué te cuentan después.
- Si debes mantener los datos en tu propia nube, elige LiteLLM o Bifrost, porque ambos tienen licencias permisivas y se autoalojan.
- Si necesitas presupuestos y auditoría entre muchos equipos, elige Portkey o Kong, porque ambos tratan el gateway como un plano de control.
- Si no tienes a nadie que gestione infraestructura, elige Vercel AI Gateway u OpenRouter, porque ambos son gestionados y facturan por token.
- Si el tiempo de primera respuesta es tu SLA, mide el p95 con tu propio tráfico, porque todas las cifras de la tabla las publica el proveedor.
- Si usas
previous_response_ido las sesiones de la nueva Agents API de OpenAI, guarda una transcripción en tu propio almacenamiento, porque ningún gateway puede trasladar a otro proveedor el estado que guarda un proveedor.
Esta última regla se ha vuelto más urgente este mes. OpenAI lanzó su Agents API en beta pública el 10 de septiembre, con «sesiones duraderas para continuar el trabajo entre turnos», según su registro de cambios. Duraderas para OpenAI. No portables a nadie más. Consulta nuestra guía de desarrollar o comprar para ver dónde encaja la línea del gateway en un stack de IA más amplio, y eficiencia de tokens para saber por qué los tokens en caché importan en la factura.
«La IA evoluciona tan rápido que las organizaciones a menudo se sienten obligadas a elegir entre dos estrategias abocadas al fracaso». — Lee Klarich, Chief Product & Technology Officer, Palo Alto Networks
Haz failover de la petición, sé dueño de la conversación
El mejor LLM gateway para tu stack es el que encaja con dónde ejecutas y quién gobierna el gasto, y la tabla lo resuelve en un minuto. Ninguno mantiene intacta una conversación con un cliente entre proveedores, porque ninguno está pensado para ello. Esa tarea corresponde a la capa superior, a la aplicación o a la plataforma multiagente que es dueña de la transcripción, de la estrategia de caché y de la ruta de escalación. Elige el gateway por disponibilidad y coste. Diseña tú el estado. Para ver cómo encaja esta capa en el stack más amplio, lee el auge del middleware de IA.
Preguntas frecuentes
¿Qué es un LLM gateway?
Un LLM gateway es un único endpoint de API que se sitúa entre tu aplicación y los proveedores de modelos. Gestiona claves, reintentos, fallbacks, límites de frecuencia y registros, para que la caída de un proveedor no tumbe tu producto con él.
¿Qué diferencia hay entre un LLM gateway y un router de modelos?
Un router de modelos decide qué modelo debe atender una petición, normalmente por coste, tarea o estado de salud. Un gateway decide si la petición sale y qué pasa cuando falla. Muchos productos hacen ambas cosas, y por eso los términos se confunden.
¿Un LLM gateway añade latencia?
Sí, aunque las cifras de los proveedores son pequeñas: Bifrost publica 11 µs a 5,000 RPS y LiteLLM 8 ms p95 con cuatro instancias. El mayor golpe de latencia tras un failover suele venir de una caché de prompts fría en el proveedor de respaldo.
¿LiteLLM es gratis?
El gateway principal de LiteLLM es de código abierto bajo licencia MIT y gratuito para autoalojar. Sigues pagando a los proveedores de modelos, además de la infraestructura en la que lo ejecutes.
¿Puedo usar un LLM gateway con la Responses API de OpenAI?
Sí. Vercel AI Gateway, por ejemplo, incluye la Responses API entre sus formatos compatibles. Pero un fallback a otro proveedor no puede reutilizar previous_response_id, así que envía el historial completo en cualquier turno que pueda acabar en failover.
¿Necesito un AI gateway si solo uso un proveedor de modelos?
A menudo sí, para los reintentos entre regiones, los límites de gasto y los registros. El argumento se refuerza en cuanto aparece un segundo proveedor o un segundo equipo.