Las 10 mejores herramientas de software de control de calidad para call centers en 2026, y cuáles pueden puntuar al agente de IA
Recopilado por Alex Gomez. Publicado el 28 de septiembre de 2026 · Última actualización: 28 de septiembre de 2026.
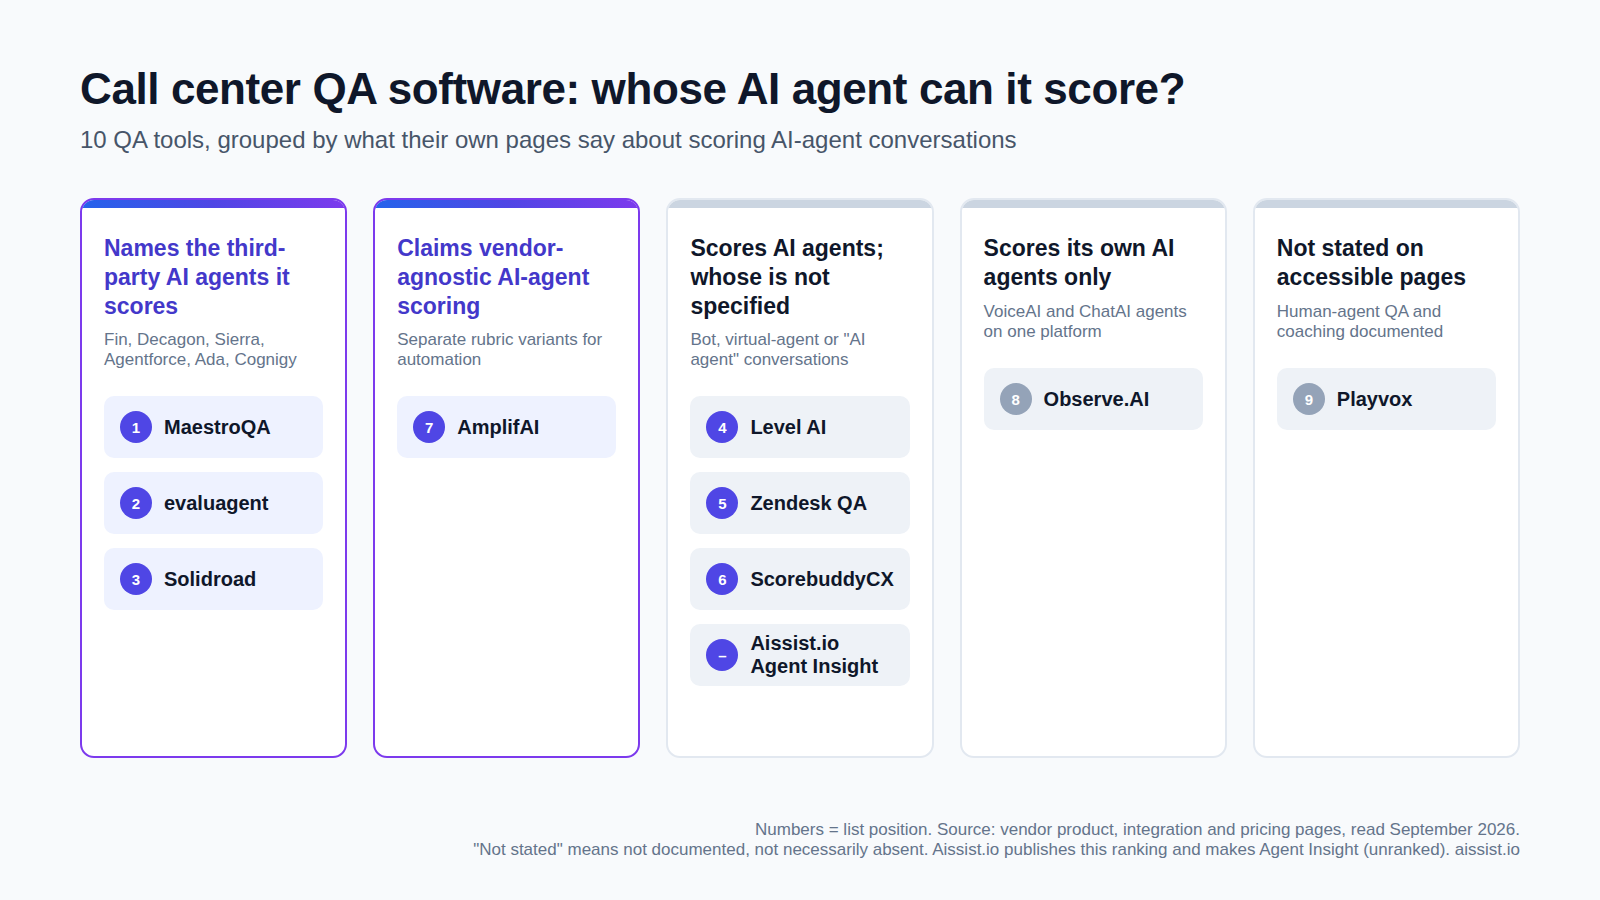
El software de control de calidad (QA) para call centers se creó para evaluar a personas según una rúbrica, y en 2026 se está aplicando a conversaciones en las que no ha participado ninguna persona. Nueve de las diez plataformas de QA analizadas aquí afirman ya que pueden puntuar la conversación de un agente de IA; solo tres nombran los agentes de IA de terceros que pueden puntuar.
En resumen: puntuar agentes de IA es ya lo mínimo exigible en el software de QA (nueve de diez proveedores lo afirman en sus propias páginas), así que elige según de quién es el agente que puede puntuar, qué fallos específicos de la IA detecta y qué volumen cubre de verdad.
La lista corta
- MaestroQA: la mejor para equipos que usan un agente de IA de terceros (Agentforce, Ada, Decagon, Sierra) junto a un equipo humano.
- evaluagent: la mejor para compradores que quieren un precio publicado y precios por conversación separados para los agentes de IA.
- Solidroad: la mejor para equipos de soporte que priorizan la IA y quieren el QA conectado directamente con la formación de los agentes.
- Level AI: la mejor para grandes contact centers con mucha voz que quieren QA, analítica y agentes virtuales en una sola suite.
- Zendesk QA: la mejor para equipos que ya usan Zendesk Suite y quieren el QA dentro del help desk que utilizan.
- ScorebuddyCX: la mejor para programas de QA maduros que quieren un módulo específico de QA para bots junto a los scorecards humanos.
- AmplifAI: la mejor para BPO y operaciones con varias sedes que vinculan el QA con el coaching y la gestión del rendimiento.
- Observe.AI: la mejor para contact centers que despliegan los propios agentes de IA de voz y chat de Observe.AI.
- Playvox: la mejor para programas de QA de agentes humanos que viven dentro del ecosistema de NiCE.
- Aissist.io Agent Insight: sin clasificar porque es nuestro; pensado para equipos que quieren puntuar a agentes de IA y humanos con un mismo estándar definido por ellos.
Cómo hemos comparado estas herramientas de QA para call centers
Hemos comparado cada herramienta según seis criterios, extraídos de las propias páginas del proveedor en septiembre de 2026: si puede puntuar conversaciones de agentes de IA, cómo hace el muestreo, hasta qué punto se puede personalizar la rúbrica, si admite calibración, si publica un precio y con qué help desks y plataformas de contact center se conecta. Solo se ha incluido una herramienta si vende el control de calidad como producto principal, no como una pestaña de informes dentro de otra cosa.
El primer criterio es el que más pesa, porque es el que cambia más rápido. El orden refleja lo completa que es hoy la documentación de cada proveedor sobre la puntuación de agentes de IA y, después, lo transparentes que son sus precios e integraciones. No es una clasificación de calidad del QA de agentes humanos, donde la mayoría de estas herramientas son maduras y tienen buenas reseñas.
Declaramos el sesgo de entrada: este es el blog de Aissist.io, y Aissist vende agentes de IA y un producto de evaluación de agentes llamado Agent Insight. Por eso Agent Insight está al final de la lista, sin clasificar, con los mismos apartados y una lista de desventajas real.
Metodología y fuentes
- Capacidades, precios e integraciones: las páginas de producto, precios, integraciones y centro de ayuda de cada proveedor, consultadas el 28 de septiembre de 2026. Cuando una página estaba bloqueada o no decía nada, la tabla indica "No indicado" en lugar de suponer.
- Valoraciones: páginas de reseñas de producto de G2, consultadas en septiembre de 2026; Capterra cuando no existe ficha en G2.
- Citas: clientes con nombre en casos de éxito y notas de prensa de los proveedores, literales.
- Cifras de mercado: Gartner, McKinsey, LangChain y Akamai, enlazadas donde se citan.
- Aviso: este es el blog de Aissist.io; Aissist vende agentes de IA y evaluación de agentes de IA.
¿Qué software de QA para call centers puede puntuar a un agente de IA?
Nueve de las diez herramientas de QA para call centers analizadas aquí afirman, en sus propias páginas, que pueden puntuar conversaciones gestionadas por IA; solo las páginas accesibles de Playvox no lo dicen. La diferencia está en el alcance: tres proveedores nombran los agentes de IA de terceros que pueden puntuar, AmplifAI describe su puntuación como independiente del proveedor y el resto o bien puntúan sus propios agentes o no dicen de quién.
Esa división importa porque la pregunta que los compradores están a punto de hacer no es "¿hacéis QA de bots?". Es "¿podéis evaluar el despliegue de Fin, Decagon o Agentforce que ya he comprado?". Un proveedor de QA que también vende agentes de IA se está corrigiendo sus propios deberes cuando solo puntúa sus propios bots.
El momento no es casual. El 24 de septiembre de 2026, Dataiku lanzó Agent Management, un producto que "encuentra todos los agentes de IA que tiene en marcha una empresa, sea cual sea la plataforma con la que se crearon, mide su rendimiento técnico y de negocio y señala los agentes que suponen mayor riesgo". Dos días antes, el informe de seguridad de Akamai afirmaba que proteger el negocio se ha convertido en "un reto de gobernanza del comportamiento de entidades no humanas". El control del comportamiento de un agente de cara al cliente es un problema de QA con etiqueta de seguridad.
"Pregúntale a un banco cuántos servidores tiene y te dará la cifra exacta. Pregúntale cuántos agentes de IA tiene en marcha y te encogerá los hombros o te dará una estimación." — Florian Douetteau, Co-founder and CEO, Dataiku
El volumen llegará de todos modos. Gartner prevé que de aquí a 2029 la IA agéntica resolverá de forma autónoma el 80% de las incidencias habituales de atención al cliente sin intervención humana. Si se cumple, la mayoría de las conversaciones de las que es responsable un equipo de QA no tendrán a una persona al otro lado. La primera página de esta búsqueda sigue evaluando sobre todo a los proveedores según lo bien que puntúan a personas, y las dos comparativas que sí preguntan por los agentes de IA concluyen, cada una, que solo su propio producto cumple.
La tabla que nadie publica
| Herramienta | ¿Puntúa conversaciones de agentes de IA? | Muestreo | Personalización de la rúbrica | Calibración | Precio mínimo (sep. 2026) | Cobertura de help desks y CCaaS |
|---|---|---|---|---|---|---|
| MaestroQA | Sí: nombra Agentforce, Ada, Decagon, Sierra, Forethought | Manual + automático, 100% | Personalizada, secciones ponderadas, suspenso automático | Sesiones en directo + puntuaciones de alineación de evaluadores | No publicado | Zendesk, Salesforce, Intercom, Freshdesk, Gorgias, Kustomer, Front, HubSpot; Five9, Talkdesk, Amazon Connect |
| evaluagent | Sí: nombra Cognigy, Sierra, Decagon | Manual + automático, 100% | Personalizada, ponderada, suspenso automático | Sesiones + reclamaciones | $35 por usuario/mes (agentes humanos); agentes de IA por conversación, bajo presupuesto | Zendesk, Intercom, Salesforce, Freshdesk; Genesys, Five9, Talkdesk, Amazon Connect |
| Solidroad | Sí: nombra Fin, Decagon, Sierra | Automático, 100% | Personalizada, ponderada, disparadores de aprobado/suspenso | La calibración reentrena la puntuación | No publicado | Zendesk, Intercom (documentadas); Gorgias, Gladly, Help Scout, ServiceNow (según el proveedor) |
| Level AI | Sí: conversaciones de bots y agentes virtuales | Automático, 100%; preguntas humanas híbridas | Scorecards personalizados e híbridos | Las correcciones de puntuación reentrenan el modelo | No publicado | Zendesk, Salesforce, Intercom, Freshworks, Kustomer, Gorgias, Front; Five9, Genesys, Talkdesk |
| Zendesk QA | Sí: "incluidos los agentes de IA" | Asignaciones manuales + automático, 100% | Personalizada, categorías ponderadas | Sesiones + reclamaciones | Sin precio independiente; paquete Workforce Engagement $50/agente/mes, anual | Nativo de Zendesk; Gorgias, Front, API |
| ScorebuddyCX | Sí: "QA for Bots" específico | Manual + automático, con tope según el plan | Totalmente configurable | Módulo de calibración | No publicado; puntuación con IA desde el plan Accelerate | Zendesk, Intercom, Salesforce, Freshdesk, Kustomer, HubSpot; Genesys, NiCE CXone, Five9, Talkdesk |
| AmplifAI | Sí: chatbots, bots de voz, agentes de IA | Automático, 100% | Personalizada, ponderada, variantes de rúbrica para IA | Calibración evaluador frente a motor + reclamaciones | No publicado | Zendesk, Salesforce, Oracle; Five9, Talkdesk, Amazon Connect, NICE, Genesys |
| Observe.AI | Sí: sus propios agentes VoiceAI y ChatAI | Automático, 100% + manual para reclamaciones | Scorecards existentes, constructor de reglas | Sesiones + reclamaciones | No publicado | Más de 250 según el proveedor; Amazon Connect, Talkdesk, Avaya, 8x8, Aircall confirmadas |
| Playvox | No indicado en las páginas accesibles | Manual/aleatorio con distribución automática | Scorecards personalizados | Calibración + reclamaciones | No publicado | Zendesk, Salesforce, Kustomer |
| Aissist.io Agent Insight | Sí: agentes de IA y humanos con una misma rúbrica | Automático, 100% | Estándares definidos por el cliente | Reclamaciones basadas en evidencias; sesiones no descritas | No publicado en la página de producto | Zendesk, Intercom, Freshdesk, Kustomer, Front, Gorgias, Salesforce, HubSpot |
"No indicado" significa que las páginas accesibles del proveedor no lo decían, no que la función no exista. Pide una demo con tus propias transcripciones antes de dar nada por hecho en un sentido u otro.
1. MaestroQA — la mejor para puntuar a un agente de IA de terceros junto a tu equipo humano
MaestroQA es una plataforma de QA y analítica de conversaciones que puntúa llamadas, chats, emails y conversaciones de bots, con integraciones para agentes de IA de Salesforce Agentforce, Ada, Decagon, Sierra y Forethought. Ningún otro proveedor de esta lista nombra tantos agentes de IA de terceros en su página de integraciones.
- Puntuación de agentes de IA: la página de QA de chatbots de MaestroQA ofrece "Auto QA en el 100% de las interacciones de los chatbots", y su integración con Agentforce promete "seguir y evaluar la eficacia de tus agentes de IA de Salesforce Agentforce".
- Muestreo: AutoQA "analiza el 100% de tus tickets", junto a la evaluación manual de tu equipo de QA.
- Rúbrica y calibración: el constructor de scorecards admite secciones ponderadas personalizadas y secciones de suspenso automático; las sesiones de calibración incluyen puntuaciones de alineación GraderQA.
- Precio: no publicado; la página de precios dice que el precio se "basa en tu caso de uso y el tamaño de tu equipo".
- G2: 4.8/5 con 325 reseñas.
En un caso de éxito publicado, Upwork afirma que antes revisaba a mano el 1% de las conversaciones de sus chatbots y que redujo el tiempo de QA de 16 horas a la semana a segundos.
"Hemos aprendido que el QA es esencial en cualquier operación de soporte al cliente: los chatbots deben tratarse como agentes, y su desarrollo debe incluir un proceso de QA estructurado." — Alix Pérez, AI Operations Admin, Upwork
Ventajas
- Nombra cinco plataformas de agentes de IA de terceros con las que se integra, la lista más amplia de esta comparativa.
- Secciones ponderadas, secciones de bonificación y secciones de suspenso automático en un mismo constructor de scorecards.
- La calibración tiene un resultado medible (puntuaciones de alineación de evaluadores), no es solo una reunión.
Desventajas
- Sin precio publicado, así que las conversaciones de presupuesto empiezan con una llamada de ventas.
- El método de muestreo para la revisión manual no está documentado en las páginas públicas que pudimos leer.
- La amplitud de conectores de help desks y agentes de IA implica más configuración al principio.
Nuestra opinión: MaestroQA es la elección más segura si tu agente de IA es de un proveedor distinto al de tu herramienta de QA. Descártala si necesitas ver un precio en una web antes de aceptar una demo.
2. evaluagent — la mejor por precio publicado y precios por conversación para agentes de IA
evaluagent es una plataforma de QA para contact centers que puntúa el 100% de las conversaciones de agentes humanos y de IA y publica sus precios por usuario, con los agentes de IA facturados por conversación en lugar de por usuario. Es uno de los dos únicos proveedores de esta lista con un precio en una página pública.
- Puntuación de agentes de IA: la página de agentes de IA dice que evaluagent "evalúa cada conversación de tus agentes de IA según tu estándar y en comparación con tus mejores agentes humanos", y nombra Cognigy, Sierra y Decagon. La página de precios incluye la "detección de invenciones" para "señalar las respuestas del bot que alucinan o inventan información".
- Muestreo: "el 100% de las conversaciones puntuadas automáticamente", con revisión manual disponible.
- Rúbrica y calibración: criterios ponderados, lógica de suspenso automático y scorecards por cola; sesiones de calibración estructuradas y un flujo de reclamaciones bidireccional.
- Precio: desde $35 USD por usuario al mes (AutoQM & Improvement) y $65 con inteligencia conversacional, según la página de precios (consultada en septiembre de 2026). Los agentes de IA se facturan "por conversación en lugar de por usuario", bajo presupuesto. No se indican el periodo de facturación ni el mínimo de usuarios.
- G2: 4.5/5 con 448 reseñas.
En un caso de éxito publicado, Capital on Tap afirma que su cobertura de QA pasó del 1–3% al 90–95%.
Ventajas
- Precio por usuario publicado, algo tan poco habitual en esta categoría que cuenta como una función.
- Los precios por conversación para agentes de IA se ajustan a cómo se comporta realmente el volumen de la IA.
- La detección de invenciones aparece como una comprobación propia, no enterrada dentro de la "precisión".
Desventajas
- Precios "desde": no se indican el periodo de facturación ni ningún mínimo de usuarios.
- Los precios para agentes de IA son solo bajo presupuesto, así que la línea más barata de la página no cubre los bots.
- Gorgias y Kustomer no aparecen en su página de integraciones.
Nuestra opinión: evaluagent es la herramienta de esta lista más fácil de presupuestar para agentes humanos y la más clara sobre las alucinaciones de los bots. Busca en otra parte si usas Gorgias o Kustomer y necesitas un conector nativo.
3. Solidroad — la mejor para equipos que priorizan la IA y quieren QA y formación en un mismo ciclo
Solidroad es una plataforma de QA y formación con IA que puntúa el 100% de las conversaciones de soporte y se conecta directamente a agentes de IA de terceros como Fin, Decagon y Sierra para evaluarlos. Empezó como un producto de formación basado en simulaciones y añadió el QA, y se nota en lo estrechamente que se conectan ambos.
- Puntuación de agentes de IA: su página de integraciones dice: "Conecta agentes de IA como Decagon, Sierra y Fin para evaluar automáticamente su rendimiento".
- Muestreo: los AI Scorecards prometen que "el 100% de las conversaciones se evalúan con una lógica coherente y fiable".
- Rúbrica y calibración: criterios personalizados, ponderación y disparadores automáticos de aprobado/suspenso; cada calibración "afina el modelo de puntuación". No se describe un flujo de reclamaciones para los agentes.
- Precio: no publicado; Solidroad ofrece precios enterprise personalizados.
- G2: 4.5/5 con 3 reseñas, demasiado pocas para apoyarse en ellas.
En un caso de éxito publicado, Crypto.com afirma puntuar más de 800,000 conversaciones al mes, con un tiempo medio de gestión un 18% menor. El caso de éxito de ActiveCampaign de Solidroad dice que la puntuación automatizada sustituyó más de 2,000 horas de trabajo manual de QA.
Ventajas
- Nombra los agentes de IA de terceros que evalúa y no vende un agente competidor.
- Los hallazgos del QA alimentan las simulaciones de formación, así que una puntuación baja se convierte en práctica, no en un memorándum.
- Probado a gran volumen en un despliegue con nombre (Crypto.com).
Desventajas
- Tres reseñas en G2 todavía no son una reputación.
- No se describe un flujo de reclamaciones para los agentes que no están de acuerdo con una puntuación.
- Solo Zendesk e Intercom tienen guías de integración documentadas; para el resto de help desks solo hay afirmaciones del proveedor.
Nuestra opinión: Solidroad encaja en equipos en los que la mayor parte del volumen ya pasa por Fin, Decagon o Sierra. Un gran contact center de voz sobre Genesys o Five9 encontrará opciones mejor documentadas más arriba y más abajo.
4. Level AI — la mejor para grandes contact centers con mucha voz que quieren una sola suite
Level AI es una suite de IA para contact centers cuyo producto de QA puntúa el 100% de las llamadas, chats, emails y conversaciones de bots, junto a sus propios agentes virtuales y su analítica. Somete a personas e IA a un mismo scorecard, y su lista de integraciones está entre las más amplias de esta comparativa.
- Puntuación de agentes de IA: la página del producto de QA promete "puntuar el 100 por cien de las llamadas, chats, emails y conversaciones de bots con estándares que tu equipo puede defender". La página del agente virtual habla de "someter a personas e IA a un mismo estándar de calidad".
- Muestreo: automático, 100%, con scorecards híbridos que mezclan preguntas puntuadas por la IA y evaluadas por personas.
- Rúbrica y calibración: mantén tu scorecard o usa rúbricas del sector; los evaluadores pueden corregir las puntuaciones de la IA, y las correcciones recalibran las puntuaciones futuras.
- Precio: no publicado; no hay página de precios.
- G2: 4.6/5 con 220 reseñas.
La propia página de Level AI sitúa la cobertura del QA manual en "a menudo entre el 1% y el 3%", y la investigación sobre atención al cliente de McKinsey la sitúa en "menos del 5 por ciento".
"¡Hemos pasado de puntuar manualmente el 1-2% de nuestras llamadas a usar Level AI para puntuar el 100% de nuestras llamadas!" — Angela Zander, Director of Operations, Quinstreet
Ventajas
- Se integra con help desks (Zendesk, Salesforce, Intercom, Gorgias, Kustomer) y con telefonía (Five9, Genesys, Talkdesk, NICE).
- Los scorecards híbridos permiten que las personas conserven las decisiones de criterio que no debería tomar la IA.
- La analítica, el QA y los agentes virtuales comparten una misma capa de datos.
Desventajas
- Sin precio público.
- No se nombra un soporte explícito para agentes de IA de terceros; la afirmación sobre la puntuación de bots es genérica.
- La calibración se basa en correcciones; no se describen sesiones de calibración formales.
Nuestra opinión: Level AI encaja en una operación grande y con mucha voz que quiere un solo proveedor para la mayor parte de su stack de CX. Si tu agente de IA es de otro proveedor, confirma que puede importar esas transcripciones antes de firmar.
5. Zendesk QA — la mejor para equipos que ya usan Zendesk Suite
Zendesk QA, antes Klaus, es el complemento de control de calidad de Zendesk que revisa cada interacción de soporte, incluidas las que gestionan los agentes de IA de Zendesk, con AutoQA, revisión manual, calibración y reclamaciones integradas. Para una empresa que trabaja con Zendesk, es el camino más corto hacia el QA.
- Puntuación de agentes de IA: la página de producto invita a "empezar a analizar cada interacción, incluidos los agentes de IA, con AutoQA", y la guía de administración de Zendesk dice que "te ayuda a evaluar el rendimiento de tus agentes de IA".
- Muestreo: AutoQA cubre el 100%; los responsables también pueden asignar revisiones manuales y fijar objetivos de revisión; Spotlight señala las interacciones de alto riesgo.
- Rúbrica y calibración: scorecards personalizados con categorías, escalas de valoración y ponderaciones; sesiones de calibración y un flujo de reclamaciones.
- Precio: no hay precio independiente del QA en la página de precios de Zendesk (consultada en septiembre de 2026). El paquete Workforce Engagement, que incluye QA y coaching, cuesta $50 USD por agente al mes, con facturación anual, además de un plan Support o Suite (Suite Team cuesta $55 por agente al mes, con facturación anual). Los complementos se compran para todos los agentes de la cuenta.
- Valoración: no hay ficha en G2 con reseñas bajo el nombre Zendesk QA; la ficha antigua de Klaus en Capterra muestra 4.9/5 con 24 reseñas.
"Necesitamos ofrecer una gran atención al cliente el 100% del tiempo. Zendesk QA nos ha ayudado a mantener el foco en la coherencia de la calidad y a identificar las áreas concretas en las que tenemos que mejorar." — Sophie Elgar, Quality and Training Manager, Liberty
Ventajas
- Nativo de Zendesk: sin conector, sin exportación de datos, con la misma plantilla de agentes.
- La calibración y las reclamaciones están documentadas por completo en el centro de ayuda de Zendesk.
- Cubre los propios agentes de IA de Zendesk sin configuración adicional.
Desventajas
- Los complementos se aplican a todos los agentes de la cuenta, así que una pequeña necesidad de QA obliga a comprar licencias para todo el equipo.
- La puntuación de agentes de IA que no son de Zendesk no está documentada.
- Fuera de Zendesk, solo están documentadas Gorgias, Front y una integración personalizada por API.
Nuestra opinión: Zendesk QA es la opción por defecto para los equipos cuyo mundo es Zendesk. Los equipos con Salesforce, Intercom o una plataforma de voz CCaaS deberían empezar por otra opción de esta lista.
6. ScorebuddyCX — la mejor para programas de QA maduros que quieren un módulo específico de QA para bots
ScorebuddyCX es una plataforma de QA, analítica de conversaciones y coaching con un producto específico, "QA for Bots", que evalúa las conversaciones de los bots en precisión, seguridad y alineación con la marca. Su módulo para bots señala las políticas inventadas y las respuestas erróneas como tipos de fallo con nombre propio.
- Puntuación de agentes de IA: la página de QA for Bots dice: "Evalúa cada conversación de los bots en precisión, seguridad y alineación con la marca", y promete señalar las respuestas en las que un chatbot "inventa información, cita políticas inexistentes o da respuestas incorrectas".
- Muestreo: puntuación automática con IA generativa "de hasta el 100%", pero la página de precios incluye 500 puntuaciones con IA al mes en Accelerate y 1,000 en Elite, y ninguna en Foundation.
- Rúbrica y calibración: scorecards totalmente configurables; un módulo de calibración desde el plan de entrada.
- Precio: no publicado; los tres planes dicen "Request a price".
- G2: 4.5/5 con 835 reseñas.
"El compromiso de Scorebuddy de aprovechar la IA para transformar radicalmente cómo se puede hacer el QA a escala hizo que la solución fuera la que mejor encajaba con Intercom." — Declan Ivory, VP Customer Support, Intercom
Ventajas
- Un producto específico de QA para bots con comprobaciones explícitas de alucinaciones y políticas falsas.
- Amplia cobertura de CCaaS (Genesys, NiCE CXone, Five9, Talkdesk, Amazon Connect) además de Zendesk e Intercom.
- La calibración está incluida en todos los planes.
Desventajas
- Las puntuaciones con IA incluidas tienen un tope por plan; con 1,000 al mes, el "100%" cubre un agente de IA pequeño, no uno con mucho trabajo.
- Sin precio publicado.
- Salesforce y la API abierta están reservados al plan superior.
Nuestra opinión: ScorebuddyCX encaja muy bien en un equipo de QA consolidado que añade bots a un programa existente. Compara la cantidad de puntuaciones con IA incluidas con el volumen mensual de tu bot antes de creerte la palabra "100%".
7. AmplifAI — la mejor para BPO y operaciones con varias sedes que vinculan QA y coaching
AmplifAI es una plataforma de gestión del rendimiento y la CX cuyo Auto QA puntúa el 100% de las interacciones de voz, chat, email y agentes de IA, con variantes de rúbrica separadas para las conversaciones automatizadas. Está pensada para operaciones que gestionan muchas sedes, equipos o socios de outsourcing.
- Puntuación de agentes de IA: la página de Auto QA dice que AmplifAI "evalúa las conversaciones automatizadas de chatbots, bots de voz y agentes de IA, y puntúa la resolución, el cumplimiento y la experiencia del cliente", con "variantes de rúbrica creadas para la automatización, visibles junto a los resultados de los equipos humanos".
- Muestreo: automático, 100%.
- Rúbrica y calibración: scorecards ponderados con varios formularios; la calibración compara las puntuaciones de los evaluadores con las del motor; el historial de reclamaciones y apelaciones aparece junto a cada evaluación.
- Precio: no publicado.
- G2: 4.7/5 con 20 reseñas.
En un caso de éxito publicado, The Home Depot afirma haber aumentado un 20% la satisfacción del cliente tras desplegar la plataforma de rendimiento de AmplifAI.
Ventajas
- Variantes de rúbrica separadas para los agentes de IA, en lugar de forzar un scorecard humano sobre un bot.
- La calibración mide a los evaluadores frente al motor de puntuación, lo que detecta desviaciones en ambos.
- Diseñada para la coherencia en BPO y operaciones con varias sedes.
Desventajas
- Veinte reseñas en G2 es una muestra escasa.
- La cobertura de help desks se inclina hacia la gran empresa (Salesforce, Zendesk, Oracle); Intercom, Freshdesk y Gorgias no aparecen.
- Sin precio público.
Nuestra opinión: AmplifAI encaja en grandes operaciones externalizadas o con varias sedes en las que el QA y el coaching tienen que estar alineados entre socios. Un equipo de 20 agentes con Intercom no es su cliente.
8. Observe.AI — la mejor para equipos que usan los propios agentes de IA de Observe.AI
Observe.AI es una plataforma de IA para contact centers que vende agentes de IA de voz y chat y puntúa el 100% de las interacciones de esos agentes de IA y de los agentes humanos con una misma rúbrica de QA. Es la herramienta adecuada cuando el agente de IA y la herramienta de QA son, por diseño, del mismo proveedor.
- Puntuación de agentes de IA: el artículo del blog de Observe.AI sobre la confianza describe "una puntuación de calidad coherente para los VoiceAI Agents, los ChatAI Agents y los agentes humanos". No se indica la puntuación de agentes de IA de otros proveedores.
- Muestreo: Auto QA evalúa "el 100% de las interacciones con los clientes", con QA manual para reclamaciones, apelaciones y llamadas delicadas.
- Rúbrica y calibración: funciona con tus scorecards existentes; las sesiones de calibración y las reclamaciones de los agentes están documentadas.
- Precio: no publicado; todos los planes dicen "Talk to sales".
- G2: 4.6/5 con 268 reseñas.
En un caso de éxito publicado, Cox Automotive afirma realizar 90,000 evaluaciones al mes y evaluar el 100% de las interacciones.
Ventajas
- Una misma rúbrica para agentes de IA y humanos en la misma plataforma.
- QA de voz maduro con calibración, reclamaciones y revisión manual para las llamadas delicadas.
- Afirma tener más de 250 integraciones.
Desventajas
- La puntuación de agentes de IA documentada solo cubre los propios agentes de Observe.AI.
- Puntuar tus propios agentes de IA es un conflicto de intereses estructural, por buena que sea la rúbrica.
- Sin precio público.
Nuestra opinión: Observe.AI tiene sentido si vas a comprar sus agentes de IA de todos modos y quieres verlo todo en un mismo panel. Si necesitas una evaluación independiente del agente de otro, elige un proveedor que no venda uno.
9. Playvox — la mejor para el QA de agentes humanos dentro del ecosistema de NiCE
Playvox, ahora Playvox by NiCE, es una plataforma de gestión de la calidad y coaching para contact centers que distribuye las evaluaciones según reglas de muestreo y vincula las puntuaciones con el coaching, con integraciones profundas con Zendesk y Salesforce. Es una de las herramientas de QA con más reseñas en G2.
- Puntuación de agentes de IA: no se indica en las páginas de Playvox a las que pudimos acceder; varias páginas de producto bloquean la lectura automatizada, así que consúltalo con el proveedor.
- Muestreo: "Tanto si tu estrategia de evaluación se basa en un muestreo aleatorio como en un enfoque acotado y definido, Playvox distribuye automáticamente el trabajo según tus criterios", según una ficha técnica de NiCE. En 2022 se anunció una función AutoQA que cubría el 100% de las interacciones.
- Rúbrica y calibración: scorecards personalizables; la ficha técnica describe la calibración de las evaluaciones frente a la opinión de expertos y la automatización de las reclamaciones.
- Precio: no publicado; la página de precios ofrece un presupuesto personalizado.
- G2: 4.8/5 con 1,163 reseñas.
Ventajas
- La mayor base de reseñas de todas las herramientas de esta lista, con una valoración alta a la altura.
- Las reglas de muestreo y la distribución automática del trabajo encajan en programas de QA manual consolidados.
- Buena integración con Zendesk y Salesforce.
Desventajas
- La puntuación de agentes de IA no está documentada en las páginas que pudimos leer.
- La disponibilidad actual de AutoQA no está confirmada en una página accesible del proveedor.
- Sin precio público.
Nuestra opinión: Playvox sigue siendo una opción sólida para el QA y el coaching de agentes humanos. Si tu agente de IA va a asumir un volumen real el año que viene, pide a NiCE una hoja de ruta por escrito antes de comprometerte.
10. Aissist.io Agent Insight — sin clasificar, porque es nuestro
Aissist.io Agent Insight es un producto de QA y evaluación de agentes que puntúa a agentes de IA y humanos con un mismo estándar definido por el cliente en el 100% de las conversaciones, desplegado sobre el help desk que el equipo ya utiliza. Se lanzó en septiembre de 2026 junto a los agentes de IA de Aissist.
- Puntuación de agentes de IA: la página de producto dice que "los agentes de IA y humanos se evalúan con el mismo estándar, en el mismo sistema y al mismo tiempo". No se indica la puntuación de agentes de IA de terceros.
- Muestreo: automático, el 100% de las conversaciones; cuando un caso pasa por varias manos, cada agente que interviene se puntúa por separado.
- Rúbrica y calibración: estándares definidos por el cliente: criterios de resolución, tono, comprobaciones de políticas, disciplina de escalación y dimensiones personalizadas. Las puntuaciones llevan evidencias con marca de tiempo, de modo que las reclamaciones se resuelven sobre la transcripción; no se describen sesiones de calibración formales.
- Precio: no publicado en la página de producto.
- G2: 4.8/5 con 41 reseñas para Aissist.io en general, no específicamente para Agent Insight.
Ventajas
- Puntúa los traspasos, así que un caso por el que pasan un bot y dos personas recibe tres evaluaciones separadas.
- Las puntuaciones vinculadas a evidencias hacen que las reclamaciones giren en torno a la transcripción, no a quién tiene más antigüedad.
- Se integra de forma nativa con Zendesk, Intercom, Freshdesk, Kustomer, Front, Gorgias, Salesforce y HubSpot.
Desventajas
- Es nuevo: se lanzó en septiembre de 2026 y todavía no tiene reseñas específicas de Agent Insight.
- No se nombran integraciones de voz ni de CCaaS; está pensado para el soporte basado en help desk.
- Como Observe.AI, Aissist también vende agentes de IA, así que se plantea la misma cuestión de conflicto de intereses.
Nuestra opinión: Agent Insight encaja en equipos basados en help desk que quieren evaluar a agentes de IA y humanos con un mismo estándar que escriben ellos mismos. Los contact centers centrados en la voz sobre Genesys o Five9 deberían mirar primero Level AI, Scorebuddy o evaluagent.
¿Qué debería medir un scorecard de QA para agentes de IA que no mida uno para personas?
Un scorecard para agentes de IA debería evaluar lo que hizo el agente y lo mal que podría salir: invenciones, cumplimiento de las políticas, corrección de las acciones, disciplina de escalación y severidad de los errores, porque el tono, la empatía y el tiempo de espera rara vez fallan en una máquina. Un scorecard humano evalúa el comportamiento; un scorecard de IA evalúa las consecuencias.
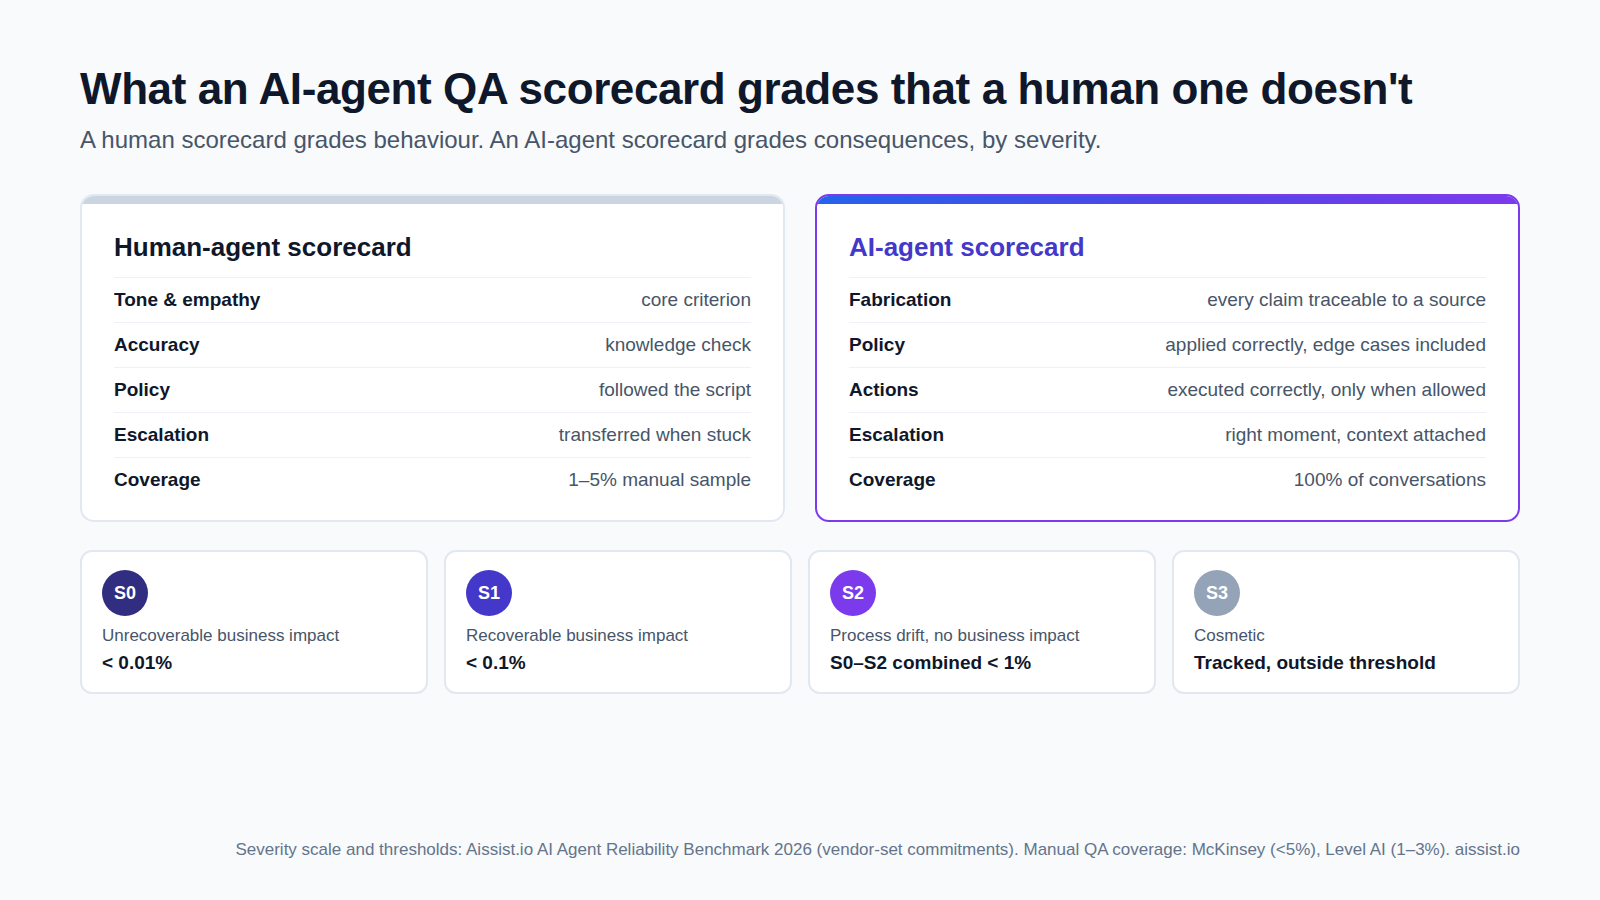
Un agente humano rara vez se inventa una política de reembolsos. Un agente de IA puede hacerlo, con total seguridad, a las 3 de la madrugada y con cada cliente que pregunte. Por eso las comprobaciones específicas de IA útiles de esta lista son las que nombran el fallo: la "detección de invenciones" de evaluagent, el aviso de Scorebuddy para el chatbot que "cita políticas inexistentes" y las variantes de rúbrica separadas para la automatización de AmplifAI.
| Criterio | Scorecard para agentes humanos | Scorecard para agentes de IA |
|---|---|---|
| Tono y empatía | Criterio central | Rara vez falla; comprueba en su lugar la voz de marca |
| Precisión | Comprobación de conocimientos | Comprobación de invenciones: cada afirmación debe poder rastrearse hasta una fuente |
| Política | Siguió el guion | Aplicó correctamente la política, incluidos los casos límite |
| Acciones | Registró el ticket | Ejecutó correctamente el reembolso, el cambio o la consulta, y solo cuando estaba permitido |
| Escalación | Transfirió cuando se atascó | Hizo el traspaso en el momento adecuado, con el contexto adjunto |
| Severidad | Aprobado o suspenso | Evaluada según el impacto en el negocio y si se puede deshacer |
| Cobertura | Muestra del 1–5% | 100%, porque los fallos de la IA se repiten a escala |
La severidad es el criterio que la mayoría de los scorecards pasan por alto. El benchmark de fiabilidad de agentes de IA de Aissist.io clasifica cada error en una escala de cuatro niveles: S0 es un impacto irrecuperable en el negocio, S1 es un impacto recuperable en el negocio, S2 es una desviación del proceso sin impacto en el negocio y S3 es estético. Aissist se compromete a menos del 1% de errores S0–S2 en conjunto, menos del 0.1% en S1 y menos del 0.01% en S0: un umbral fijado por el proveedor, no una medición independiente.
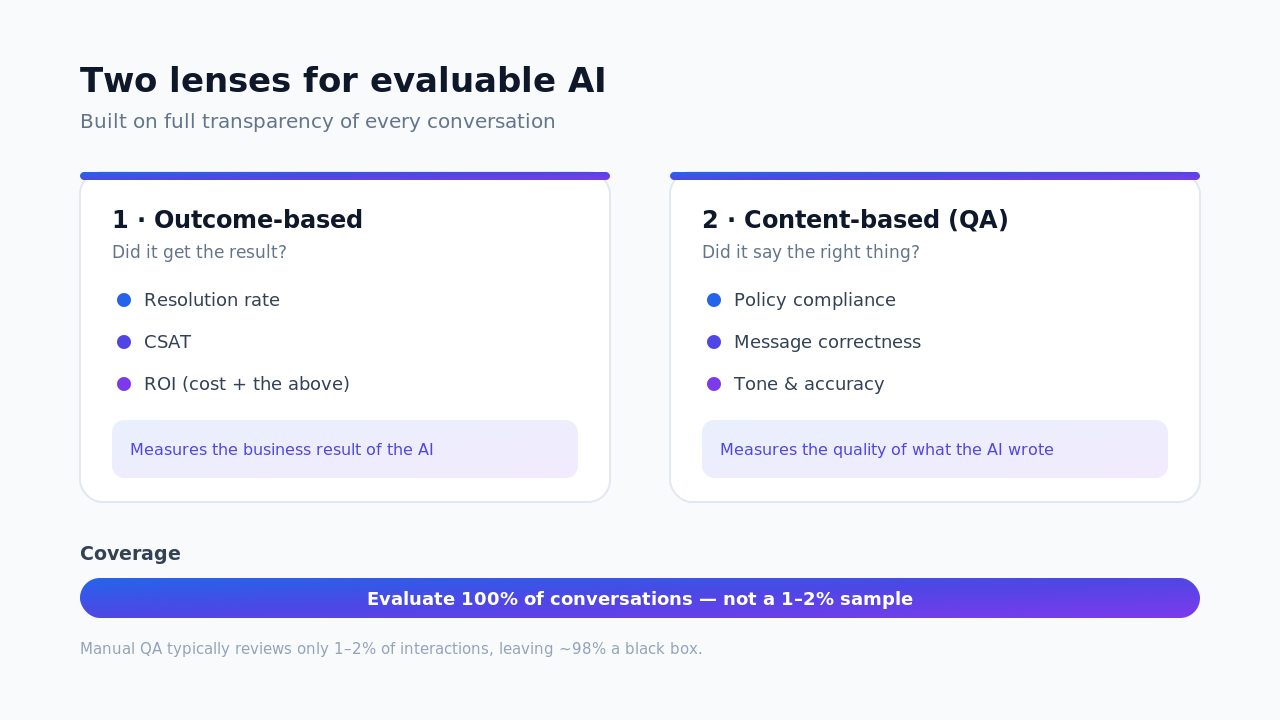
La lección de primera mano tras construir esa medición es que ninguna de las dos mitades funciona sola. Aissist ejecuta una auditoría con LLM sobre cada transcripción, además de un muestreo de QA humano "que mantiene honesto al auditor". El LLM aporta la cobertura; las personas impiden que el auditor derive hacia la evaluación de sus propias preferencias de estilo. Eso es calibración, solo que apuntando al evaluador en lugar de al evaluado.
La evaluación todavía se practica de forma desigual. En la encuesta State of Agent Engineering de LangChain a 1,340 profesionales, el 52.4% hace evaluaciones offline con conjuntos de prueba y solo el 37.3% hace evaluaciones online del tráfico real. Para saber más sobre los argumentos a favor de medir, consulta la página de Aissist sobre la IA evaluable.
"Desplegar agentes de IA de voz es relativamente fácil, pero saber si realmente están resolviendo las incidencias o desviando una llamada en directo a satisfacción de quien llama es el verdadero reto." — Anshuman Rawat, CTO, 3CLogic
¿Cuánto cuesta el software de control de calidad para call centers?
La mayor parte del software de QA para call centers no publica precios: ocho de las diez herramientas de esta lista son solo bajo presupuesto, y las dos que lo publican empiezan en $35 (evaluagent) y $50 (el paquete Workforce Engagement de Zendesk) por agente al mes. En el caso de los agentes de IA, la cifra más importante es cuántas conversaciones puntuadas con IA incluye un plan.
| Herramienta | Precio de entrada publicado (sep. 2026) | Unidad de facturación | Qué cubre |
|---|---|---|---|
| evaluagent | $35 USD | Por usuario al mes | AutoQM para agentes humanos; agentes de IA bajo presupuesto por conversación |
| Zendesk QA | $50 USD, con facturación anual | Por agente al mes, todos los agentes | Paquete Workforce Engagement con QA incluido; requiere un plan Support o Suite |
| Todas las demás | No publicado | Varía | Solo bajo presupuesto |
Los precios por usuario se crearon para las personas, y los agentes de IA los rompen. Un bot no ocupa una licencia. Por eso evaluagent factura los agentes de IA por conversación y Scorebuddy pone un tope a las puntuaciones con IA incluidas en cada plan.
Esto es lo que significa ese tope en la práctica. Supongamos que un agente de IA gestiona 20,000 conversaciones al mes. El plan Elite de ScorebuddyCX incluye 1,000 puntuaciones con IA al mes, lo que cubre el 5% de ese volumen, más cerca de una muestra manual que de una cobertura completa. Puede que haya puntuaciones adicionales disponibles; pregunta cuánto cuestan.
Tres costes ocultos que conviene comprobar en cualquier presupuesto:
- Niveles de la plataforma anfitriona. Zendesk QA necesita un plan Support o Suite, y los complementos se compran para todos los agentes de la cuenta.
- Integraciones limitadas por plan. ScorebuddyCX reserva Salesforce y su API abierta al plan Elite.
- Volumen de IA. Pide el precio de puntuar todo el volumen mensual de tu agente de IA, no el precio de las licencias.
La investigación de McKinsey da el motivo para pagar por la cobertura: una empresa de servicios financieros que usaba IA generativa en el QA logró "más del 90 por ciento de precisión" en los parámetros de calidad clave, frente a entre el 70 y el 80 por ciento de la puntuación manual.
¿Cómo se elige el software de QA para contact centers adecuado?
Elige el software de QA para contact centers según dónde viven tus conversaciones y quién las gestiona: la plataforma de help desk o de telefonía decide la lista corta, y el agente de IA que usas decide el ganador. Sigue estas reglas:
- Si usas un agente de IA de terceros (Fin, Decagon, Sierra, Agentforce), elige MaestroQA, Solidroad o evaluagent, porque nombran esos agentes en sus propias páginas.
- Si lo tienes todo en Zendesk, elige Zendesk QA, porque no necesita conector, pero calcula el precio con tu número total de agentes.
- Si necesitas un precio antes de una demo, elige evaluagent, porque es el único proveedor de QA independiente de esta lista que publica uno.
- Si tu volumen es sobre todo de voz en Genesys, Five9 o Talkdesk, incluye en tu lista corta Level AI, ScorebuddyCX y evaluagent, porque cada uno de ellos incluye esas plataformas.
- Si gestionas BPO o muchas sedes, elige AmplifAI, porque su calibración compara a los evaluadores con el motor en todos los socios.
- Si has comprado los agentes de IA de Observe.AI, usa el QA de Observe.AI, porque los puntúa de forma nativa, y plantéate una segunda evaluación independiente.
- Si tu equipo de QA es solo humano y va a seguir así, Playvox y ScorebuddyCX son opciones probadas y con muchas reseñas.
- Si quieres a los agentes de IA y humanos con un mismo estándar escrito por ti dentro de tu help desk, valora Aissist.io Agent Insight, con el sesgo indicado más arriba.
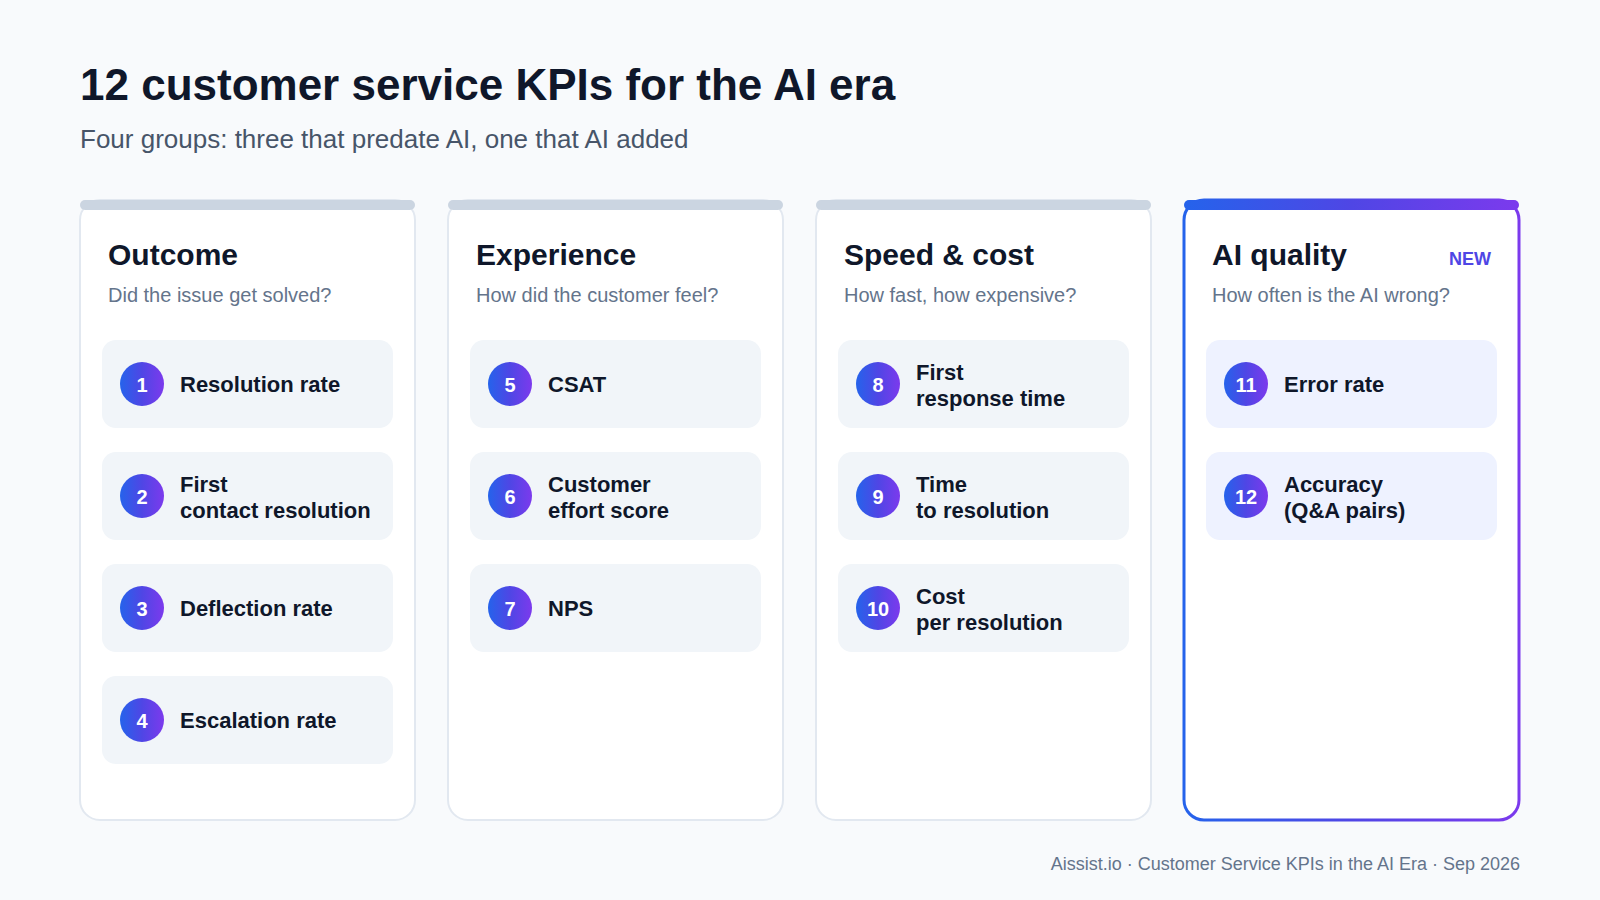
Antes de firmar, haz un piloto de pago con 500 de tus propias conversaciones gestionadas por IA y compara las puntuaciones de la herramienta con las de tu mejor evaluador humano. Si discrepan más de lo que discrepan tus evaluadores entre sí, la herramienta todavía no está calibrada. Para las métricas que conviene seguir junto a las puntuaciones de QA, consulta la guía de Aissist sobre los KPI de atención al cliente.
¿Cuál es la diferencia entre QA, inteligencia conversacional y analítica de voz?
El control de calidad evalúa conversaciones individuales según una rúbrica; la inteligencia conversacional encuentra patrones en todas las conversaciones; la analítica de voz es la tecnología de procesamiento de voz que hace que las llamadas se puedan consultar para ambas cosas. La primera página de resultados usa los tres términos como sinónimos, y los proveedores los venden juntos, pero responden a preguntas distintas.
| Término | Pregunta a la que responde | Resultado | Usuario habitual |
|---|---|---|---|
| Control de calidad (QA) | ¿Cumplió esta conversación nuestro estándar? | Una puntuación por conversación y por agente | Analista de QA, jefe de equipo |
| Inteligencia conversacional | ¿Qué está pasando en todas nuestras conversaciones? | Tendencias, temas, motivos de contacto, sentimiento | Responsable de CX, producto, ventas |
| Analítica de voz | ¿Qué se dijo en esta llamada? | Transcripciones, detección de palabras clave y acústica | Alimenta el QA y la inteligencia conversacional |
G2 define la inteligencia conversacional como "el proceso de capturar, analizar e interpretar las conversaciones con los clientes en llamadas, videollamadas, chats y emails para descubrir información sobre las ventas, el soporte y el comportamiento de los clientes". La analítica de voz es más limitada: la capa de transcripción y análisis de audio que hace que una llamada se pueda leer.
En la práctica, las fronteras se difuminan. evaluagent vende la inteligencia conversacional como un nivel de $65 por encima de su nivel de QA de $35, y ScorebuddyCX se describe como la unión del QA, la analítica de conversaciones y el coaching. Aissist separa las dos cosas: Pulse mira hacia fuera, a por qué te contactan los clientes, mientras que Agent Insight mira hacia dentro, a cómo ha rendido cada agente.
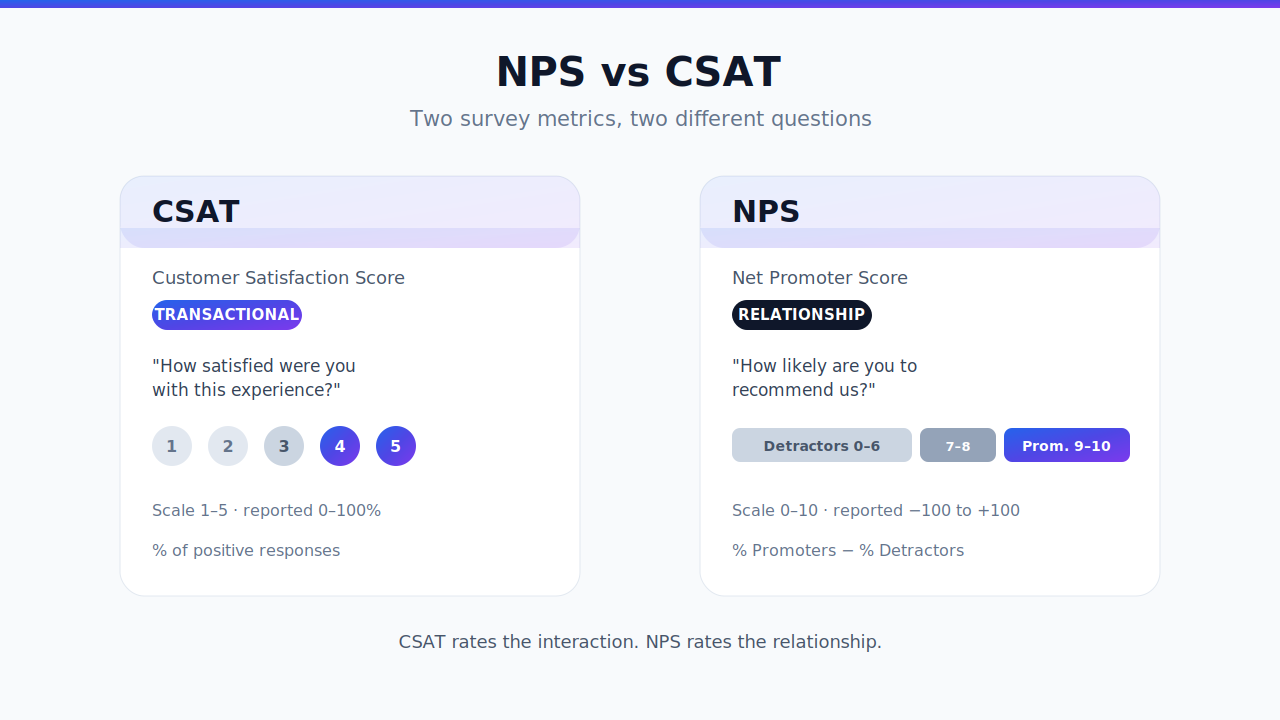
La regla práctica: compra QA para evaluar a los agentes, inteligencia conversacional para entender a los clientes, y comprueba que ambos funcionan sobre las mismas transcripciones para que las respuestas coincidan. Los datos de satisfacción deben estar en la misma vista; la guía de Aissist sobre NPS frente a CSAT explica qué mide cada encuesta.
Puntuar al agente de IA es lo mínimo; puntuarlo en lo que importa es el producto
Todos los proveedores de QA serios afirman ya que pueden puntuar a un agente de IA. Eso hace que la afirmación, por sí sola, casi no valga nada. Las diferencias que importan son de quién es el agente que puede puntuar una herramienta, si evalúa fallos específicos de la IA como las invenciones y las acciones erróneas, y si la "cobertura del 100%" sobrevive al choque con el cupo de puntuaciones con IA del plan.
Empieza por la plataforma en la que viven tus conversaciones y, después, pide a cada proveedor que puntúe un mes de transcripciones reales de tu agente de IA. La herramienta que coincida con tu mejor evaluador, detecte la política de reembolsos inventada y ponga precio a todo el volumen es la que debes comprar.
Preguntas frecuentes
¿Qué es el software de control de calidad para call centers?
El software de control de calidad para call centers puntúa las conversaciones con los clientes según una rúbrica para medir el rendimiento de los agentes, el cumplimiento y la experiencia del cliente. Las herramientas modernas puntúan automáticamente con IA el 100% de las llamadas, chats y emails en lugar de revisar una pequeña muestra manual, y muchas puntúan ya también las conversaciones de agentes de IA.
¿Puede el software de QA evaluar agentes de IA y chatbots?
Sí. Nueve de las diez herramientas analizadas aquí afirman que puntúan conversaciones gestionadas por IA. MaestroQA, evaluagent y Solidroad nombran los agentes de IA de terceros que puntúan, y AmplifAI describe su puntuación como independiente del proveedor; Observe.AI documenta la puntuación de sus propios agentes.
¿Qué porcentaje de las llamadas revisa el QA manual?
El QA manual suele revisar una pequeña fracción de las conversaciones. McKinsey lo sitúa en menos del 5 por ciento, y Level AI habla de entre el 1% y el 3%. Las herramientas de QA automatizado afirman una cobertura del 100%, sujeta a los límites del plan en las conversaciones puntuadas con IA.
¿Qué software de QA para call centers publica sus precios?
evaluagent publica precios desde $35 por usuario al mes para el QA de agentes humanos. Zendesk anuncia su paquete Workforce Engagement, que incluye QA, a $50 por agente al mes con facturación anual. Las otras ocho herramientas de esta lista son solo bajo presupuesto.
¿Es el QA automático lo bastante preciso como para sustituir a los evaluadores humanos?
El QA automático es lo bastante preciso como para sustituir el muestreo aleatorio, pero no la calibración. McKinsey informa de que el QA con IA generativa supera el 90 por ciento de precisión, frente a entre el 70 y el 80 por ciento de la puntuación manual. Mantén a evaluadores humanos para calibrar el modelo y gestionar las reclamaciones.
¿Qué debería incluir un scorecard para un agente de IA?
Un scorecard para agentes de IA debería comprobar las invenciones, la aplicación de las políticas, la corrección de las acciones, el momento de la escalación y la severidad de los errores. El tono y la empatía importan menos en una máquina. Clasificar la severidad según el impacto en el negocio, por ejemplo con una escala S0–S3, muestra qué errores cuestan dinero de verdad.
¿Cuál es la diferencia entre QA e inteligencia conversacional?
El QA evalúa conversaciones individuales según un estándar y genera puntuaciones de los agentes. La inteligencia conversacional analiza todas las conversaciones en busca de tendencias, temas y motivos de contacto. Muchos proveedores venden ambas cosas, pero responden a preguntas distintas: cómo lo hizo el agente frente a qué nos están diciendo los clientes.
¿Debería puntuar mi agente de IA el mismo proveedor que lo creó?
Puede hacerlo, pero una evaluación independiente es más segura. Un proveedor que puntúa su propio agente de IA tiene un conflicto de intereses estructural, por buena que sea su rúbrica. Muchos equipos usan las puntuaciones integradas para la monitorización diaria y una herramienta de QA independiente para la auditoría.
Registro de cambios
- 28 de septiembre de 2026: primera publicación. Diez herramientas analizadas; capacidades, precios y valoraciones consultados en las páginas de los proveedores y en G2 en septiembre de 2026.