AI washing en atención al cliente: cómo distinguir la IA agéntica real de un chatbot con otra etiqueta
Gartner cuenta aproximadamente 130 proveedores con capacidad agéntica genuina entre los miles que la reivindican. Cinco preguntas, planteadas en veinte minutos durante una llamada con el proveedor, te dicen con cuál de los dos tipos estás hablando.
En resumen: el AI washing en atención al cliente se detecta por lo que se publica, no por la demo. Gartner sitúa los proveedores genuinamente agénticos en unos 130 de miles, y las cinco pruebas siguientes dejan en evidencia al resto antes de que firmes nada.
Metodología y fuentes
- Datos de palabras clave: Semrush, base de datos de EE. UU., extraídos el 21 de septiembre de 2026: «ai washing», 1,300 búsquedas/mes con una dificultad de palabra clave de 34; «agent washing», 70/mes con KD 36 y un CPC de $6.91.
- Cifras de proveedores tomadas de la página de precios, la documentación o el centro de ayuda públicos de cada proveedor el 21 de septiembre de 2026, nunca del artículo comparativo de un competidor. Vuelve a verificar los precios antes de diciembre de 2026.
- Cifras de rendimiento tomadas de la propia página del proveedor que las publica, marcadas en todo el texto como declaradas por el proveedor. Vuelve a verificarlas antes de marzo de 2027.
- Recuentos de actuaciones sancionadoras procedentes de comunicados oficiales de la SEC y la FTC y de análisis de bufetes. Vuelve a verificarlos antes de marzo de 2027.
- Aviso: este es el blog de Aissist.io. Aissist.io vende una plataforma de IA agéntica para atención al cliente y ventas, y se puntúa con las mismas cinco pruebas que el resto de proveedores de este artículo, incluida la que suspende.
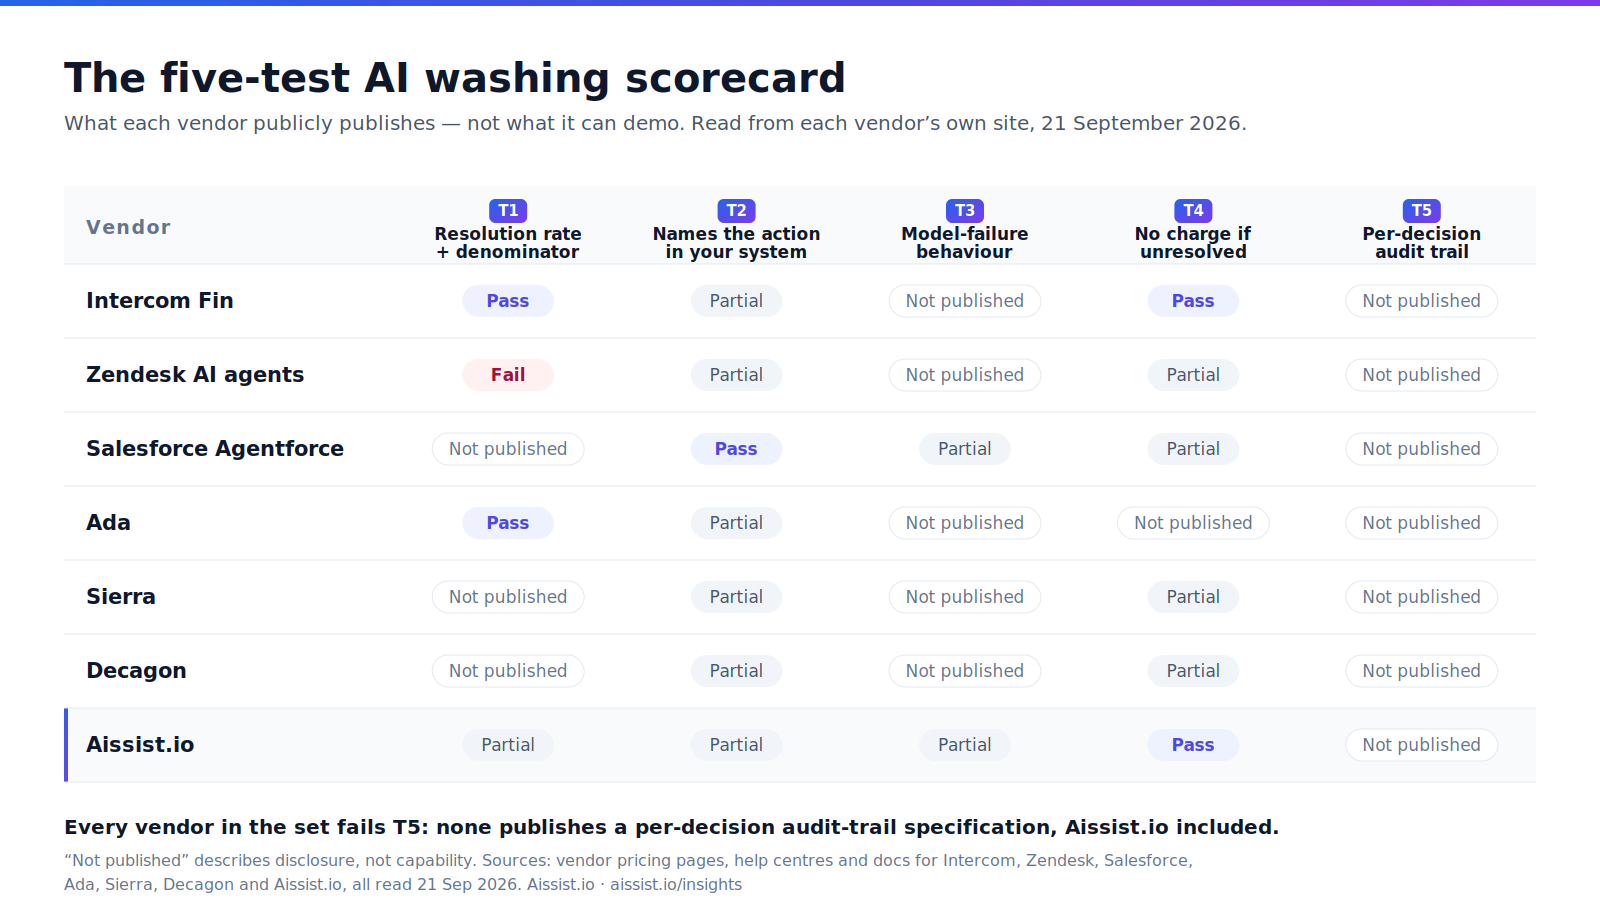
Qué son T1 a T5, en una línea cada una:
- T1: la tasa de resolución y su denominador. ¿Publica el proveedor una tasa de resolución, la población sobre la que se mide y lo que queda excluido del recuento?
- T2: la acción dentro de tu sistema. ¿Puede nombrar el registro que escribe, el campo que modifica y la API a la que llama, o solo recupera información y responde?
- T3: el comportamiento cuando el modelo se degrada. ¿Nombra sus modelos, su regla de enrutamiento, su alternativa de respaldo y la prueba de regresión que debe superar un modelo nuevo antes de tocar tu tráfico?
- T4: el precio de un fallo. ¿Cuánto te cuesta una conversación que la IA no resolvió y qué plan de plataforma tienes que contratar antes?
- T5: el registro de auditoría de una decisión. ¿Puede abrir una conversación real y mostrar la fuente recuperada, la comprobación de política ejecutada y la regla que escaló, o que no lo hizo?
Cada prueba completa —la pregunta literal que debes hacer, la respuesta que aprueba y la que suspende— está en la sección de las cinco preguntas, más abajo.
Este artículo puntúa lo que los proveedores publican, no lo que pueden enseñar en una demo. Para la métrica que hay detrás de la prueba T1, consulta tasa de desvío frente a tasa de resolución. Para la diferencia de arquitectura sobre la que descansa todo el argumento, consulta chatbots tradicionales frente a IA agéntica.
¿Qué es el AI washing en atención al cliente?
El AI washing en atención al cliente es la práctica de comercializar un sistema de soporte como IA autónoma cuando el trabajo de cara al cliente lo siguen haciendo flujos guionizados, respuestas basadas solo en recuperación, una capa fina sobre el modelo de otra empresa o trabajo humano oculto; y, con mayor frecuencia, la de presentar una métrica de éxito que cuenta conversaciones que la IA nunca llegó a resolver. El Legal Information Institute de la Cornell Law School define el término general sin rodeos: «El AI washing se produce cuando las empresas afirman utilizar tecnología de inteligencia artificial (IA) para mejorar sus servicios pero, en realidad, no lo hacen».
En atención al cliente, la afirmación suele ser más sutil que una invención descarada, y eso es precisamente lo que la hace difícil de detectar. La IA es real. Lo que se ha maquillado es la cifra que la describe.
Gartner le puso nombre propio a la versión de software de este fenómeno. El «agent washing», escribió la consultora en su previsión de junio de 2025, es el «cambio de marca de productos existentes, como asistentes de IA, automatización robótica de procesos (RPA) y chatbots, sin capacidades agénticas sustanciales». El recuento de Gartner de proveedores que cumplen de verdad —una estimación de analista, no un censo— es de unos 130, de los miles que lo reivindican.
«La mayoría de las propuestas de IA agéntica carecen de un valor o un retorno de la inversión (ROI) significativos, porque los modelos actuales no tienen la madurez ni la capacidad de actuación necesarias para alcanzar de forma autónoma objetivos de negocio complejos». — Anushree Verma, Senior Director Analyst, Gartner
Los reguladores llegaron antes que los compradores. La SEC acusó a dos asesores de inversión por afirmaciones falsas sobre IA en marzo de 2024, con acuerdos de $225,000 por parte de Delphia y $175,000 por parte de Global Predictions —$400,000 en total—, y el entonces presidente Gary Gensler declaró que «los asesores de inversión no deberían engañar al público diciendo que utilizan un modelo de IA cuando no es así». La FTC presentó «más de una docena de casos relacionados con AI washing» en el año hasta agosto de 2026, según la revisión de Operation AI Comply de Holland & Knight, publicada el 18 de agosto de 2026; y, algo importante para quien compra software y no bienes de consumo, el bufete señala que «se aplican los mismos requisitos de justificación y los mismos criterios de engaño, tanto si el público es un consumidor como si es un comprador empresarial sofisticado».
Esa última frase es la que hay que retener. La tasa de resolución que anuncia una plataforma de soporte es una afirmación publicitaria que debe poder justificarse, no una sensación.
¿Por qué es más difícil detectar el AI washing en 2026?
Porque la compra se aceleró más rápido que la evaluación. El informe State of Contact Center AI 2026 de Verint, del que informó CX Today el 3 de septiembre de 2026, concluyó que el 87% de los responsables de contact center planean aumentar el gasto en asistencia automatizada a agentes, mientras que el contact center medio ya utiliza tecnología de tres o más proveedores y el 20% usa cinco o más. Un mercado que suma proveedores a ese ritmo ha dejado de compararlos.
Luego está la cuestión de los nombres. Salesforce dedicó la semana de Dreamforce a lanzar etiquetas: AIforce, Claudeforce, Slackforce, Agentforce Coworker y Koa —un modelo de razonamiento para CRM que, según la empresa, se entrenó con 27 años de escenarios de implantación—, todas anunciadas en cuatro días, según el resumen de CXM del 18 de septiembre de 2026. Algunos son productos reales con mecanismos reales detrás. El problema es que un sprint de nombres de cuatro días enseña a todo el mercado que, vistos desde fuera, una capacidad nueva y un sufijo nuevo parecen idénticos.
Los compradores lo notan. La tensión de cualquier evaluación de IA agéntica ahora mismo está entre un consejo de administración que quiere anunciar la inversión y un responsable de operaciones que tiene que poner aquello en marcha el lunes.
«Pero oímos eso y la gente dice: "Un momento, antes de ponerlo en producción quiero asegurarme de que de verdad va a tener una interacción positiva con mi cliente, si es de cara al cliente, y de que no está quemando tokens"». — Rebecca Wettemann, CEO y analista principal, Valoir
La predicción complementaria de Gartner es que más del 40% de los proyectos de IA agéntica se cancelarán antes de finales de 2027, por «costes crecientes, un valor de negocio poco claro o controles de riesgo insuficientes». Fíjate en lo que no aparece en esa lista: que el modelo no fuera lo bastante bueno. Los proyectos mueren porque nadie acordó de antemano con qué se mediría el éxito.
Lo cual, en cierto modo, es una buena noticia. Si el AI washing fuera un problema tecnológico, un comprador no podría detectarlo desde fuera. Es un problema de transparencia, y la transparencia se puede poner a prueba en una llamada.
¿Qué cinco preguntas desenmascaran el AI washing en una llamada con un proveedor?
Lo desenmascaran cinco preguntas: qué publica el proveedor como tasa de resolución y sobre qué denominador, qué acción realiza dentro de tu sistema, qué ocurre cuando su modelo se degrada, cuánto cobra por una conversación que no resolvió y si puede mostrar el registro de auditoría de una decisión. Cada una tiene una respuesta que aprueba y otra que suspende, y las respuestas que suspenden no son evasivas: son seguras, fluidas y concretas sobre lo que no es.
Hazlas palabra por palabra. Los proveedores responden a preguntas ensayadas con respuestas ensayadas.
T1: la tasa de resolución y su denominador
Pregunta, literalmente: «¿Cuál es vuestra tasa de resolución media, sobre cuántos clientes y qué queda excluido del denominador?».
Respuesta que aprueba: una sola cifra, la población sobre la que se mide y una lista explícita de lo que no cuenta. Fin, de Intercom, publica una resolución media del 76% sobre 8,000+ clientes (declarado por el proveedor, fin.ai, página fechada el 17 de junio de 2026, verificada el 21 de septiembre de 2026), y detalla sus exclusiones: «Fin solo cuenta resoluciones genuinas y positivas. No se cuentan las conversaciones en las que los clientes expresan insatisfacción, en las que el agente no aborda el problema principal o en las que el cliente vuelve con el mismo problema».
Respuesta que suspende: una tasa de desvío, una tasa de contención, una tasa de interacción o una tasa de resolución sin población asociada.
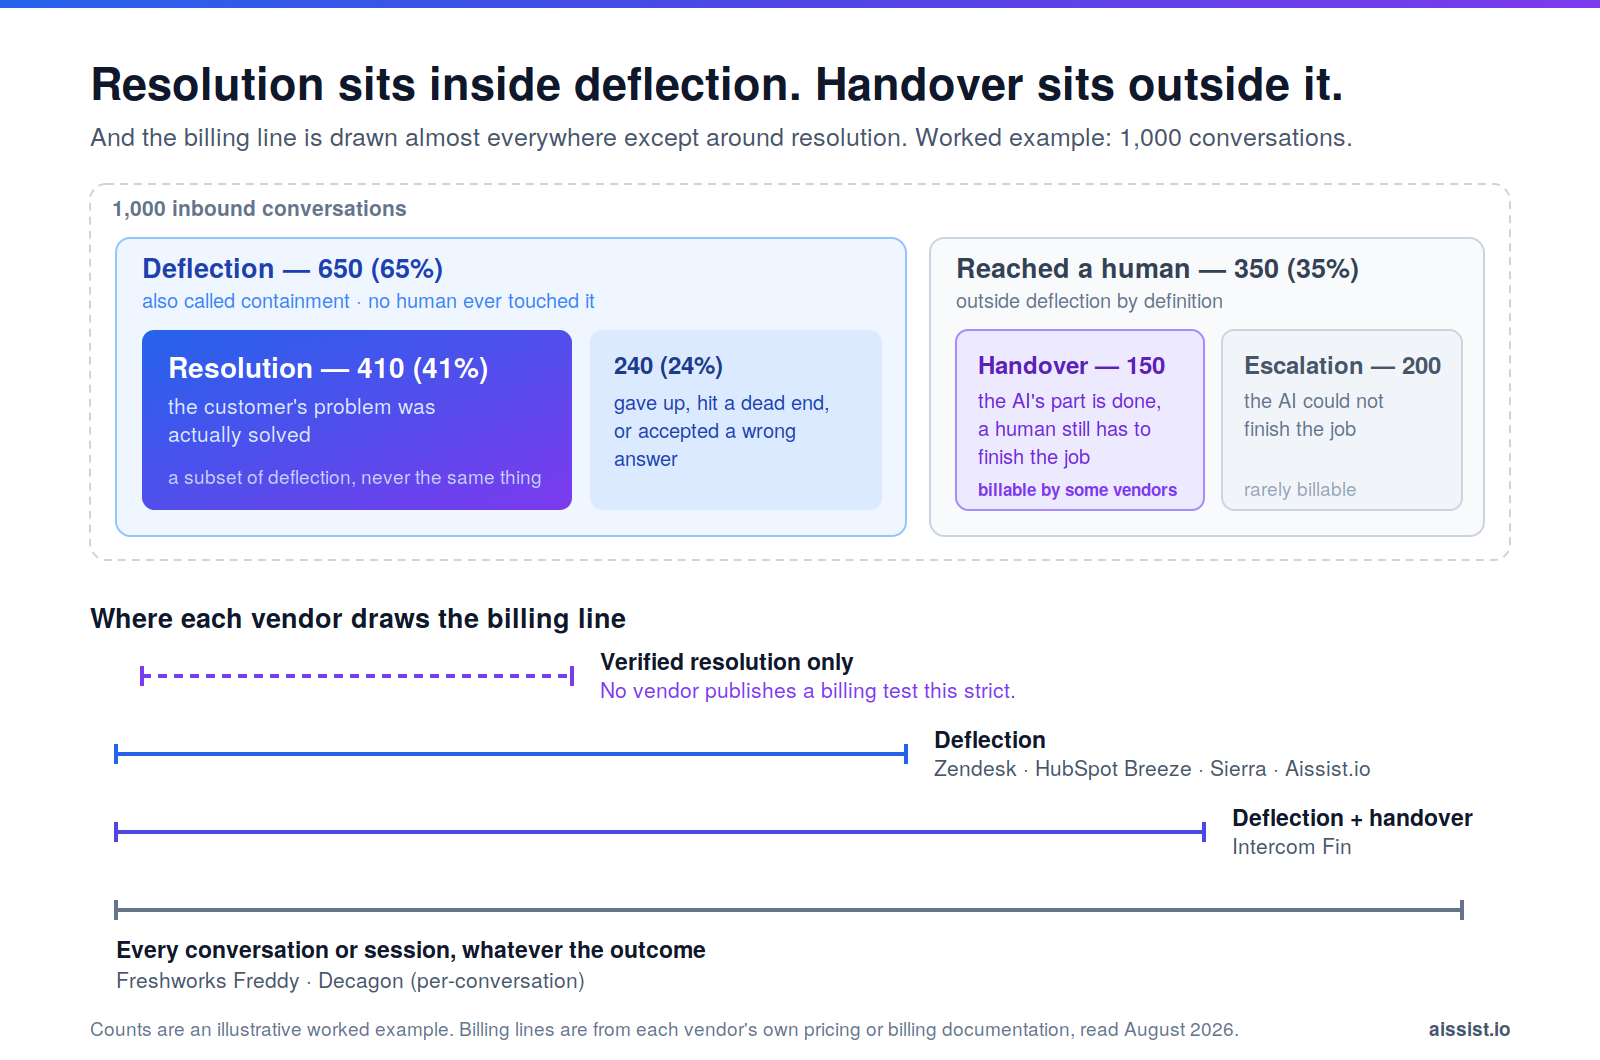
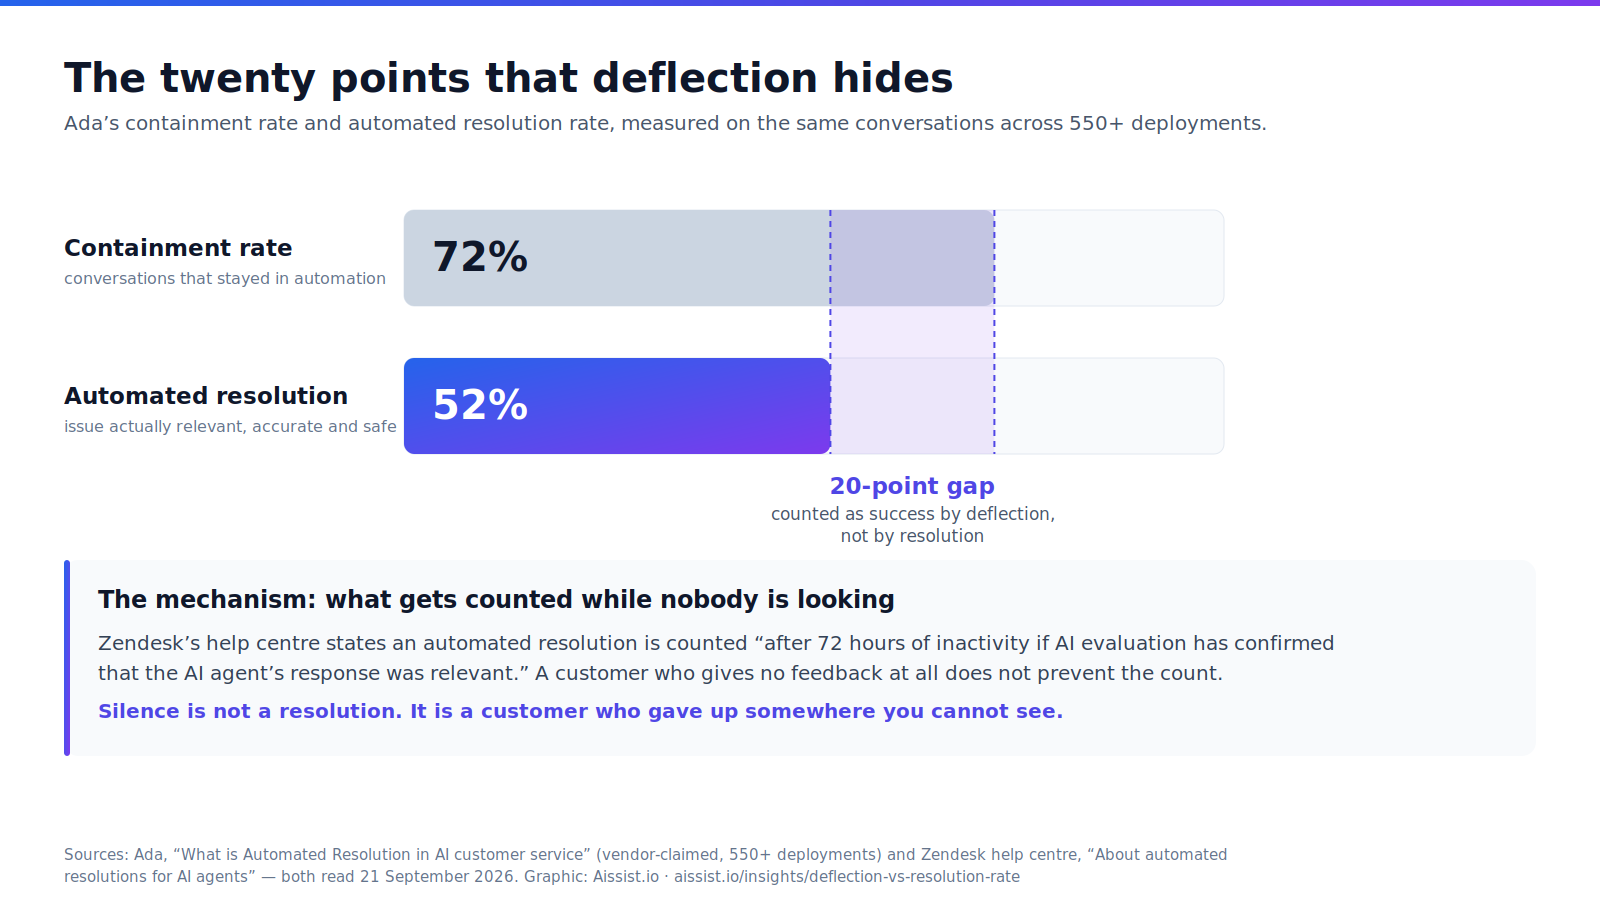
La diferencia entre esas dos métricas no es un error de redondeo. Ada informa de una contención media de alrededor del 72% y una resolución automatizada media de alrededor del 52% medidas sobre las mismas conversaciones en 550+ implantaciones (declarado por el proveedor, Ada, verificado el 21 de septiembre de 2026): una diferencia de veinte puntos que Ada, hay que reconocérselo, publica ella misma. Zendesk es todavía más literal: su centro de ayuda indica que una resolución automatizada se cuenta «tras 72 horas de inactividad si la evaluación de IA ha confirmado que la respuesta del agente de IA era pertinente», y que un cliente que no da ningún feedback no impide el recuento (centro de ayuda de Zendesk, verificado el 21 de septiembre de 2026).
El silencio no es una resolución. Es un cliente que se rindió en algún punto que no puedes ver. Nuestro propio análisis de tasa de desvío frente a tasa de resolución repasa las cuentas.
T2: la acción dentro de tu sistema
Pregunta, literalmente: «Nombra la acción que realiza vuestro agente dentro de mi sistema para este tipo de ticket: el campo que escribe, el registro que modifica, la API a la que llama».
Respuesta que aprueba: el objeto, el sistema y el disparador, nombrados sin rodeos. «Escribe el número de RMA en el registro del pedido en Shopify y establece el campo refund_status del ticket».
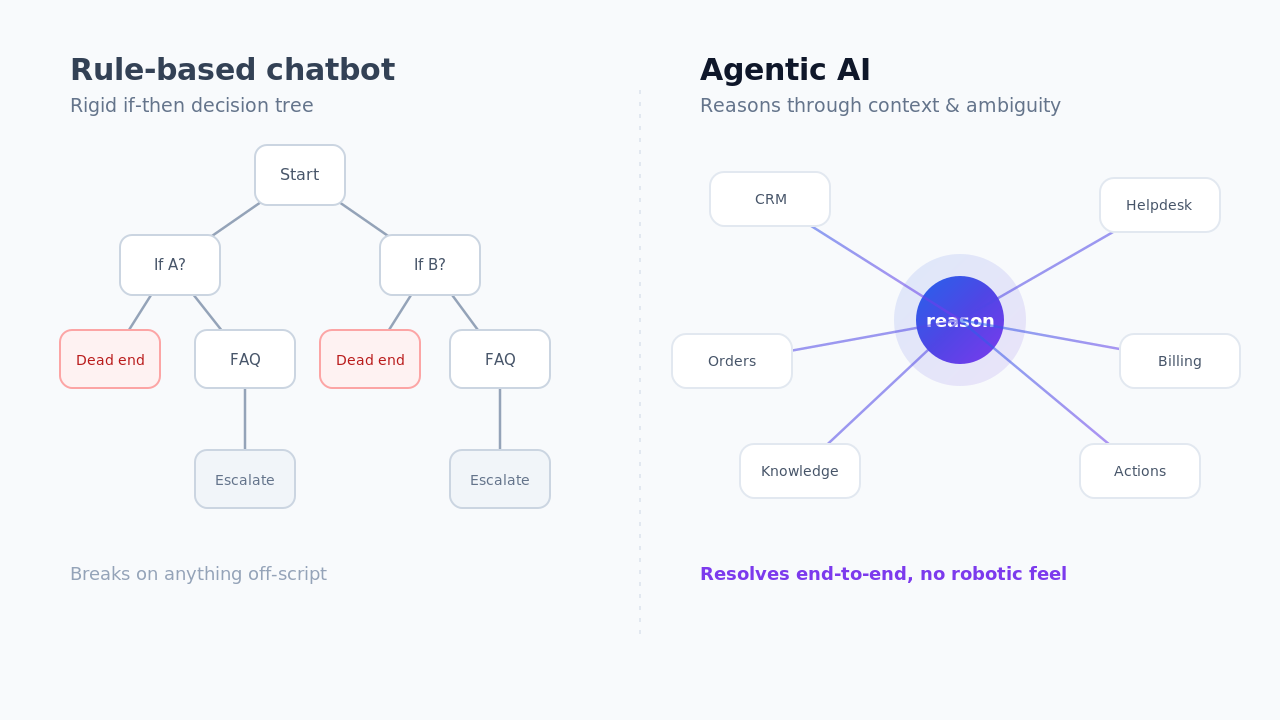
Respuesta que suspende: «Saca a la luz la respuesta correcta de tu base de conocimiento». Eso es recuperación. La recuperación es útil, pero no es una acción: es toda la diferencia entre chatbot y agente de IA en una sola frase, y el motivo por el que ya en 2025 defendimos que el chatbot estaba muerto.
Salesforce, nada menos, lo hace comprobable porque pone precio a la unidad: una acción de Agentforce consume 20 Flex Credits, que equivalen a $0.10, de paquetes de $500 por 100,000 créditos, y la documentación dice que «los Flex Credits garantizan que solo pagas por las acciones que realiza Agentforce, como actualizar registros de clientes, automatizar flujos de trabajo o resolver casos» (Salesforce Help, verificado el 21 de septiembre de 2026).
Un proveedor que factura por acción se ha visto obligado a definir qué es una. No es casualidad; es transparencia.
T3: el comportamiento cuando el modelo se degrada
Pregunta, literalmente: «¿Sobre qué modelos funciona esto y qué le pasa a mi tasa de resolución la semana en que un proveedor publica una regresión?».
Respuesta que aprueba: nombra los modelos, la regla de enrutamiento, la alternativa de respaldo y el conjunto de pruebas de regresión que se ejecuta antes de pasar un modelo nuevo al tráfico de producción.
Respuesta que suspende: «Somos agnósticos respecto al modelo», sin ninguna regla de enrutamiento detrás, o «siempre usamos el mejor modelo», sin nombrar ninguno. Ser agnóstico respecto al modelo y ser indiferente al modelo no son la misma postura.
La propia implantación de Cisco muestra cómo suena la respuesta que aprueba desde el lado del comprador, y a una escala que merece la pena citar: 145,000 casos de soporte resueltos íntegramente por IA sin intervención humana en el FY2026 (comunicado por la empresa, declarado por el CEO de Cisco en su presentación de resultados).
«Circuit funciona sobre nuestra infraestructura segura de fábrica de IA, que mejora el uso de las GPU y enruta automáticamente cada tarea al gran modelo de lenguaje adecuado, lo que nos permite gestionar el consumo de tokens». — Chuck Robbins, presidente y CEO, Cisco (publicado el 13 de agosto de 2026)
Si los mayores compradores especifican el enrutamiento a nivel de tarea, un proveedor que no sabe describir el suyo va por detrás de sus clientes.
T4: el precio de un fallo
Pregunta, literalmente: «¿Cuánto me cobráis por una conversación que vuestra IA no resolvió, y en qué plan de plataforma tengo que estar antes?».
Respuesta que aprueba: nada, o una tarifa inferior declarada, más el requisito de plan anfitrión dicho en voz alta. Fin, de Intercom, cuesta $0.99 por resultado de Fin, y los planes de Intercom —Essential a $29, Advanced a $85 y Expert a $132 por puesto/mes— incluyen Fin sin coste adicional por puesto, con una opción independiente al mismo precio de $0.99 y sin necesidad de puestos (precios de Intercom, verificado el 21 de septiembre de 2026). Zendesk incluye agentes de IA en los planes Suite —Team a $55 y Professional a $115 por agente/mes con facturación anual— y factura las resoluciones automatizadas que superan la asignación del plan (precios de Zendesk, verificado el 21 de septiembre de 2026).
Respuesta que suspende: por conversación, por mensaje, por interacción sin tope por resultado, o «solo bajo presupuesto». La alternativa de Salesforce al precio por acción es de $2 por conversación, que se cobra tanto si la conversación llega a algún sitio como si no. Sierra solo dice que los clientes «pagan por el valor que aporta Sierra con precios basados en resultados» y no publica ninguna tarifa (sierra.ai, verificado el 21 de septiembre de 2026). Decagon explica con detalle los precios basados en resolución —y reconoce la parte difícil, que «definir qué es una resolución puede ser complicado, porque no todos los casos terminan con un lazo»— sin publicar su propia cifra (glosario de Decagon, verificado el 21 de septiembre de 2026).
«Solo bajo presupuesto» es una respuesta honesta. Simplemente no es comparable, y significa que la definición de resolución llega en un contrato y no en una página web.
T5: el registro de auditoría de una decisión
Pregunta, literalmente: «Abre una conversación de la semana pasada y enséñame por qué la IA dijo lo que dijo: la fuente que recuperó, la comprobación de política que ejecutó, la regla que escaló o no escaló».
Respuesta que aprueba: alguien comparte pantalla y recorre la cadena de una conversación concreta y real, incluido un caso en el que la IA se equivocó.
Respuesta que suspende: un panel de control. La precisión agregada es un boletín de notas; un registro de auditoría es una prueba. Solo uno de los dos te dice por qué un cliente recibió la respuesta que recibió.
Esta es la prueba que más a menudo suspende toda la categoría. De los siete proveedores comparados más abajo, seis no publican en sus webs públicas ninguna especificación de registro de auditoría por decisión a fecha de 21 de septiembre de 2026. La única excepción es el editor de este artículo, lo que resulta incómodo de escribir y es un buen motivo para puntuarlo con escepticismo: la página de IA evaluable de Aissist.io se compromete a evaluar cada conversación tanto por su resultado como por su contenido, en lugar de presentar una cifra de precisión global, y Pulse lee cada conversación, de IA y humana, para registrar qué ocurrió y por qué. La misma página sitúa en torno al 90% la proporción de proveedores de IA para soporte que no ofrecen evaluación o solo métricas superficiales, lo que es una afirmación fuerte sobre un sector del que Aissist.io forma parte. Aun así, oblíganos a abrir una conversación real en la llamada. Ese es todo el sentido de T5.
¿Qué puntuación obtienen los proveedores citados en las cinco pruebas?
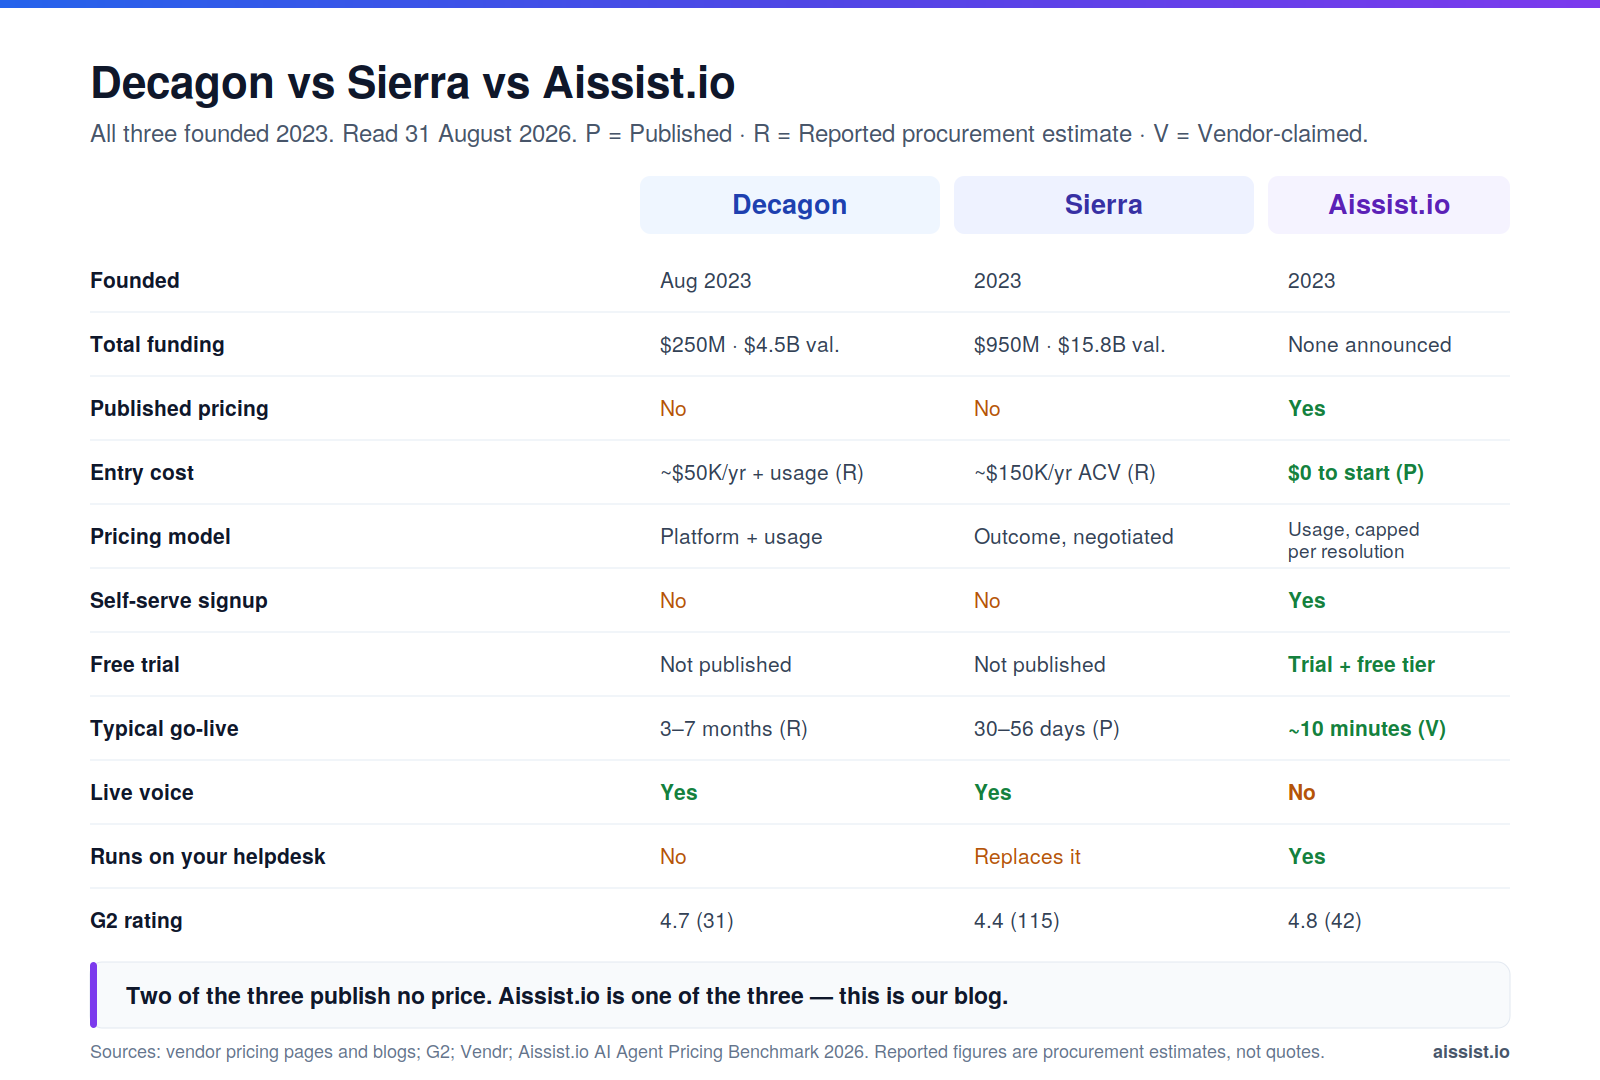
En información pública a 21 de septiembre de 2026, Fin de Intercom y Ada obtienen la mejor nota en T1, Salesforce e Intercom la mejor en T4, y seis de los siete proveedores no publican absolutamente nada frente a T5. Las columnas siguientes puntúan lo que cada proveedor publica, no lo que su producto puede hacer en una demo. Un proveedor bien puede aprobar una prueba en privado y obtener aquí un Parcial; para eso sirve preguntarlo en una llamada.
| Proveedor (verificado el 21 sep. 2026) | T1 Tasa + denominador | T2 Nombra la acción | T3 Comportamiento ante fallos del modelo | T4 Cobro si no resuelve | T5 Registro de auditoría por decisión |
|---|---|---|---|---|---|
| Intercom Fin | Aprueba: 76% sobre 8,000+ clientes, exclusiones declaradas | Parcial | No publicado | Aprueba: $0.99 solo por resultado | No publicado |
| Agentes de IA de Zendesk | Suspende: resolución contada tras 72h de inactividad | Parcial | No publicado | Parcial: basado en AR, por encima de la asignación del plan | No publicado |
| Salesforce Agentforce | No publicado | Aprueba: la acción es la unidad con precio | Parcial: modelo Koa nombrado | Parcial: $0.10/acción o $2/conversación | No publicado |
| Ada | Aprueba: 52% de AR frente a 72% de contención, 550+ implantaciones | Parcial | No publicado | No publicado | No publicado |
| Sierra | No publicado | Parcial | No publicado | Parcial: «basado en resultados», sin tarifa | No publicado |
| Decagon | No publicado | Parcial | No publicado | Parcial: basado en resolución, sin tarifa | No publicado |
| Aissist.io | Parcial: 83% sin denominador | Aprueba: 5 acciones de escritura en Zendesk nombradas | Parcial: enrutamiento + regulador publicados | Parcial: medido por interacción, con tope por resolución | Aprueba: evaluación por conversación, motivos registrados |
Precios, normalizados, ya que T4 es la prueba en la que los compradores más se equivocan:
| Proveedor | Unidad de facturación (sep. 2026) | Tarifa publicada (sep. 2026) | ¿Cobra si falla? | Plan anfitrión necesario (sep. 2026) |
|---|---|---|---|---|
| Intercom Fin | Por resultado de Fin | $0.99 USD | No | Cualquier plan de Intercom desde $29/puesto/mes, o independiente |
| Agentes de IA de Zendesk | Por resolución automatizada | No publicada en la página de precios | Solo si se cuenta la AR (incl. 72h de silencio) | Suite Team $55 o Professional $115/agente/mes, facturación anual |
| Salesforce Agentforce | Por acción o por conversación | $0.10/acción (20 Flex Credits); $2/conversación | Sí, en el modelo por conversación | No indicado en la documentación de precios |
| Ada | Por resolución automatizada | No publicada | No publicado | No publicado |
| Sierra | Basado en resultados | No publicada | No publicado | No publicado |
| Decagon | Basado en resolución | No publicada | No publicado | No publicado |
| Aissist.io | Por interacción, con tope por resolución | $0.09/interacción con tope de $0.60/resolución: lo menor de los dos | Parcial: las interacciones se miden; un caso traspasado a una persona no se cobra | Ninguno; plan gratuito hasta 1,000 tickets/mes |
Dos notas de equidad. «No publicado» significa que no pudimos encontrarlo en la propia web del proveedor el 21 de septiembre de 2026: es una afirmación sobre transparencia, no sobre capacidad. Y las tasas de resolución comparativas que Fin publica sobre sus competidores (Decagon en el 49%, Forethought en el 50%) son pruebas comparativas declaradas por Fin, que es exactamente el tipo de cifra que T1 existe para cuestionar, la publique quien la publique.
De la tabla se desprenden tres reglas de decisión. Si necesitas una cifra de resolución que puedas comparar con la tuya, preselecciona a los proveedores que publiquen una con población asociada —hoy, Intercom Fin y Ada—, porque una tasa sin denominador no se puede comparar con nada. Si tu automatización depende de escribir en un sistema ajeno al help desk, dale el máximo peso a T2 y haz que el proveedor nombre la llamada a la API, porque una página de integraciones demuestra que existe una conexión, no que el agente pueda escribir a través de ella. Y si tu presupuesto no puede asumir pagar por los fallos, descarta los precios por conversación antes de la demo y no después, porque es la única condición del contrato que ningún ajuste mejora.
Veredicto: el AI washing es un fallo de transparencia, no de tecnología
El AI washing se detecta por lo que se publica, no por lo que se demuestra: lo que separa a los aproximadamente 130 proveedores genuinamente agénticos que contó Gartner de los miles que reivindican la etiqueta no es solo la capacidad, sino si el proveedor ha publicado una cifra lo bastante concreta como para poder estar equivocada. El instinto, cuando una categoría se llena de afirmaciones idénticas, es exigir una demo mejor. Es el instinto equivocado, porque la demo es el único artefacto que todos los proveedores ya han perfeccionado.
Así que convierte las cinco pruebas en los primeros veinte minutos de la llamada, antes de compartir pantalla. Un proveedor que nombra su denominador, nombra el campo que escribe, nombra sus modelos, pone precio a su propio fallo y abre una sola decisión a inspección te ha entregado cinco afirmaciones refutables. Un proveedor que responde a las cinco con fluidez sin nombrar nada te ha entregado un sufijo. Los dos lo llamarán IA agéntica. Solo uno de ellos se puede comprobar, y comprobar sale más barato antes del contrato que después del trimestre.
Haznos las cinco pruebas. Aissist.io publica su precio por resolución, su definición de resolución y su tasa de error, y suspende T1 por el denominador, algo que estamos corrigiendo. Reserva una consulta →
Preguntas frecuentes
¿Qué es el AI washing en atención al cliente?
El AI washing en atención al cliente consiste en comercializar un sistema de soporte como IA autónoma cuando el trabajo lo siguen haciendo flujos guionizados, respuestas basadas solo en recuperación, una capa fina sobre el modelo de otra empresa o trabajo humano oculto. Lo más habitual es que adopte la forma de una métrica de éxito que cuenta conversaciones que la IA no resolvió.
¿El AI washing es lo mismo que el agent washing?
No: el agent washing es la versión de software, más acotada. Gartner usa «agent washing» para referirse al cambio de marca de asistentes, RPA y chatbots existentes sin capacidad agéntica sustancial, y calcula que solo unos 130 de los miles de proveedores que reivindican la IA agéntica la ofrecen de verdad.
¿Cómo distingo un agente de IA real de un chatbot con otra etiqueta?
Pide al proveedor que nombre la acción que realiza su agente dentro de tu propio sistema: el campo que escribe, el registro que modifica, la API a la que llama. Un chatbot recupera información y responde; un agente cambia el estado de un sistema de registro y puede decirte cuál.
¿Por qué la tasa de desvío es una señal de alarma en la propuesta de un proveedor de IA?
El desvío cuenta las conversaciones que nunca llegaron a una persona, incluidos los clientes que se rindieron. Ada publica una contención de alrededor del 72% y una resolución automatizada real de alrededor del 52% sobre las mismas conversaciones en 550+ implantaciones: una diferencia de veinte puntos que el desvío oculta por completo.
¿De verdad cuenta como resolución una ventana de 72 horas sin respuesta?
En Zendesk, sí. Su centro de ayuda indica que una resolución automatizada se cuenta tras 72 horas de inactividad una vez que la evaluación de IA confirma que la respuesta era pertinente, y que un cliente que no da ningún feedback no detiene el recuento. Pregunta a cada proveedor cuál es su ventana equivalente.
¿Es ilegal el AI washing?
Puede serlo. La SEC cerró con acuerdos de $400,000 en marzo de 2024 las acusaciones contra dos asesores de inversión por afirmaciones falsas sobre IA, y la FTC presentó más de una docena de casos de AI washing en el año hasta agosto de 2026. Holland & Knight señala que a los compradores empresariales se les aplican los mismos criterios de engaño que a los consumidores.
¿Qué debo preguntar sobre precios para no pagar por AI washing?
Pregunta cuánto te cobran por una conversación que la IA no resolvió y qué plan de plataforma tienes que contratar antes. Una tarifa de $0.99 por resolución sobre un plan de $115 por puesto no es un producto de $0.99, y una tarifa por conversación te cobra exactamente lo mismo por el éxito que por el fracaso.