Las 6 mejores herramientas de programación con IA en 2026
Las mejores herramientas de programación con IA en 2026 son Claude Code, OpenAI Codex, Cursor, GitHub Copilot, Google Antigravity y CodeRabbit. Cuál es la adecuada depende de una pregunta que la mayoría de las páginas comparativas se saltan: ¿cuál es la unidad de facturación? En estos seis productos aparecen cuatro unidades distintas (por puesto con exceso de tokens medido, por puesto con créditos que se pueden comprar, por puesto con uso bajo demanda a tarifas de API y tarifa plana por desarrollador), y por eso un puesto de $10 y uno de $40 pueden dar la misma factura, y por eso «desde $20/mes» no te dice casi nada. Esta guía compara las seis por precios verificados, profundidad agéntica y puntuaciones reales en G2, y normaliza la unidad de facturación para que las cifras sean realmente comparables.
Revisado por Rob Jiang, Chief AI Engineer. Aviso: esta guía la publica Aissist.io. Desarrollamos IA agéntica para atención al cliente y ventas; no vendemos ninguna herramienta para desarrolladores, no tenemos ninguna entrada en esta lista y no mantenemos ninguna relación de afiliación ni de referidos con ninguna de las empresas mencionadas. Los precios se consultaron en las páginas de precios de los proveedores el 21 de agosto de 2026; las valoraciones de G2, Capterra y Gartner se consultaron en agosto de 2026.
En resumen: en 2026 merece la pena pagar por seis herramientas de programación con IA. Se diferencian menos en la calidad bruta del modelo (la mayoría usan los mismos modelos de frontera) que en cómo se despliegan, cuánto cuestan cuando los agentes empiezan a funcionar y si alguien las ha certificado.
- La mejor para el trabajo agéntico profundo en grandes bases de código: Claude Code: $17/mes Pro, $20/puesto/mes en los planes de equipo
- La mejor para delegar tareas en paralelo en distintas superficies: OpenAI Codex: incluida en ChatGPT Plus por $20/mes
- La mejor para el desarrollo diario centrado en el IDE: Cursor: $20/mes Pro, $40/puesto/mes Teams
- La mejor para estandarizar una organización sin cambiar de editor: GitHub Copilot: $10/mes Pro, $19/puesto/mes Business
- La mejor para agentes de frontera sin coste por puesto: Google Antigravity: gratis para desarrolladores individuales
- La mejor para la revisión de código automatizada como filtro de merge: CodeRabbit: $24/desarrollador/mes con facturación anual
La mayor trampa de compra de esta categoría es el precio de etiqueta. Todas las herramientas de esta lista facturan el trabajo agéntico según el consumo de tokens por debajo de la suscripción, así que la cuota por puesto describe un mínimo, no una factura, y los harnesses de código abierto «gratuitos» son los menos gratuitos de todos, porque pagas directamente al proveedor del modelo.
Cómo hemos comparado estas herramientas de programación con IA
Hemos puntuado seis herramientas en cinco criterios, de 0 a 5 cada uno, y hemos exigido al menos 17 de 25 para entrar en la lista. La rúbrica:
- Profundidad agéntica: ¿puede la herramienta planificar, editar varios archivos, ejecutar comandos, lanzar tests e iterar ante los fallos sin que un humano pulse una tecla en cada paso?
- Superficie de despliegue: ¿se sitúa sobre el stack que ya utilizas o te obliga a cambiar de editor, de host o de flujos de trabajo?
- Transparencia de costes: ¿se publica la unidad de facturación, se cuantifica el uso incluido con cifras reales y puede un comprador prever una factura mensual antes de firmar?
- Calidad de la evidencia: ¿las afirmaciones de rendimiento están respaldadas por una evaluación independiente o un protocolo publicado, o solo por el marketing del proveedor?
- Postura de gobernanza: estado de SOC 2 e ISO, política de entrenamiento por defecto, retención, autoalojamiento y controles de administración.
Estas son las puntuaciones, para que puedas discrepar de ellas.
| Herramienta | Profundidad agéntica | Superficie de despliegue | Transparencia de costes | Calidad de la evidencia | Gobernanza | Total |
|---|---|---|---|---|---|---|
| Claude Code | 5 | 5 | 2 | 5 | 4 | 21/25 (84%) |
| OpenAI Codex | 5 | 5 | 3 | 4 | 4 | 21/25 (84%) |
| GitHub Copilot | 4 | 5 | 4 | 3 | 5 | 21/25 (84%) |
| CodeRabbit | 4 | 5 | 5 | 3 | 4 | 21/25 (84%) |
| Cursor | 5 | 3 | 2 | 4 | 4 | 18/25 (72%) |
| Google Antigravity | 5 | 4 | 3 | 3 | 2 | 17/25 (68%) |
Los precios se consultaron directamente en la página de precios en vivo de cada proveedor el 21 de agosto de 2026 y llevan esa fecha en cada entrada. Cada cifra de rendimiento lleva una etiqueta de procedencia: declarada por el proveedor, clasificación de terceros o evaluada de forma independiente. Cuando un proveedor publica resultados de benchmark solo como imágenes, o no publica ninguna cifra, decimos «no publicado» en lugar de tomar prestada una cifra del blog de un competidor.
Nuestro sesgo, dicho claramente: Aissist.io desarrolla IA agéntica para operaciones de atención al cliente y ventas, no herramientas para desarrolladores, así que no tenemos ningún producto que poner en primer lugar. Lo que sí tenemos es una opinión firme sobre lo que separa a un agente real de un motor de autocompletado, y esa opinión da forma al criterio 1. La limitación que conviene revelar es que esta comparativa se basa en documentación de fuentes primarias y en las páginas de precios de los proveedores consultadas en agosto de 2026, no en meses de uso práctico de las seis.
Quién se ha quedado fuera y por qué. Cline, Aider, OpenCode y RooCode son harnesses de código abierto capaces, pero son envoltorios agnósticos respecto al modelo y no productos con precios publicados, condiciones de soporte o postura de cumplimiento normativo: pertenecen a otra comparativa. Devin Desktop es una opción creíble que no hemos puntuado en esta edición: Cognition cambió el nombre de Windsurf a Devin Desktop en junio de 2026, y el cambio es lo bastante reciente como para que lo evaluemos como es debido en la actualización de enero de 2027 en lugar de puntuar un producto en plena transición. Replit y v0 se orientan a la creación de prototipos y no a la ingeniería de producción.
Las 6 herramientas de programación con IA de un vistazo
| Herramienta | Ideal para | Tecnología | Unidad de facturación | Precio de entrada para uso agéntico | Se despliega sobre el stack existente | G2 (ago. 2026) |
|---|---|---|---|---|---|---|
| Claude Code | Trabajo agéntico profundo en grandes bases de código | Agéntica | Por puesto + exceso de tokens medido | $17/mes (Pro, anual) | Sí: terminal, plugin de IDE, CI | 4.7 (112) |
| OpenAI Codex | Tareas delegadas en paralelo | Agéntica | Por puesto + créditos que se pueden comprar | $20/mes (ChatGPT Plus) | Sí: CLI, extensión de IDE, GitHub/GitLab | 4.7 (19): muestra escasa |
| Cursor | Desarrollo diario centrado en el IDE | Agéntica | Por puesto + uso bajo demanda a tarifas de API | $20/mes (Pro) | No: sustituye a tu editor | 4.6 (315) |
| GitHub Copilot | Estandarización en toda la organización | Híbrida (autocompletado + agente) | Por puesto + créditos de IA (1 crédito = $0.01) | $10/mes (Pro) | Sí: más de 12 editores y github.com | 4.4 (394) |
| Google Antigravity | Agentes de frontera sin coste por puesto | Agéntica | Cuota gratuita; enterprise por puesto | $0 para particulares | Parcial: app de escritorio o extensión de IDE | Sin ficha |
| CodeRabbit | Revisión de código automatizada | Agéntica (limitada a la revisión) | Por desarrollador, tarifa plana | $24/desarrollador/mes (Pro, anual) | Sí: bot en tu host de Git | 4.4 (113) |
La columna de la unidad de facturación es la primera que hay que leer. En seis productos aparecen cuatro unidades distintas, y por eso los precios destacados no son comparables y el ejemplo de costes práctico de más abajo importa más que cualquiera de ellos.
Para quién está pensada cada una
| Herramienta | Equipo de mejor encaje | Superficies | Dónde se ejecuta | Tiempo hasta la primera ejecución del agente | Seguridad y cumplimiento declarados |
|---|---|---|---|---|---|
| Claude Code | Del mid-market a grandes empresas; grandes bases de código heredadas | Terminal, VS Code, JetBrains, escritorio, web, iOS/Android, Slack, Chrome | GitHub Actions, GitLab CI/CD, local, Bedrock, Vertex, Foundry | Minutos | SOC 2 Type I y II, ISO 27001:2022, ISO 42001:2023, preparado para HIPAA con BAA; sin entrenamiento con condiciones comerciales; ZDR solo bajo petición |
| OpenAI Codex | De pymes a grandes empresas que ya usan ChatGPT Business/Enterprise | CLI, extensión para VS Code/Cursor/Windsurf, escritorio, web, iOS, Slack | GitHub, GitLab (beta), sandbox en la nube gestionado por OpenAI | Minutos | SOC 2 Type 2; sin entrenamiento por defecto; retención de 30 días; ZDR bajo petición; Compliance API |
| Cursor | Equipos de producto dispuestos a estandarizarse en un único editor | Editor de escritorio, CLI, agentes en la nube, iPad, Slack, Teams, Jira, Linear | GitHub, GitLab, Bitbucket, Azure DevOps, Cursor Origin | Minutos | SOC 2 Type II, GDPR, CCPA; modo de privacidad; acuerdos ZDR con los proveedores de modelos; ISO 27001 no publicado |
| GitHub Copilot | Grandes empresas con editores variados y un requisito de gobernanza | VS Code, Visual Studio, JetBrains, Neovim, Xcode, Eclipse, github.com, CLI, móvil | Repositorios alojados en GitHub; Azure DevOps para revisión (preview) | Minutos | SOC 1 y 2 Type 2, ISO/IEC 27001:2022, CSA STAR Level 2, PCI DSS AoC; indemnización de PI condicional; sin entrenamiento con datos de Business/Enterprise |
| Google Antigravity | Particulares y equipos sensibles al coste; empresas que usan Google Cloud | App de escritorio Antigravity, CLI, extensiones para VS Code/JetBrains/Zed, SDK de Python | Local, Google Cloud mediante Gemini Enterprise | Minutos | Antigravity en sí no tiene ninguna certificación SOC ni ISO según la propia matriz de cumplimiento de Google; Gemini Code Assist tiene ISO 27001/27017/27018/27701 y SOC 1/2/3 |
| CodeRabbit | Cualquier equipo en el que la revisión de PR sea el cuello de botella | Bot en el host de Git, extensión para VS Code/Cursor/Windsurf, CLI, Slack, Discord, Jira, Linear | GitHub, GitLab, Bitbucket, Azure DevOps; autoalojado a partir de 500 puestos | Menos de una hora | SOC 2 Type II, ISO 27001, GDPR; nunca entrena con el código de los clientes; el código sigue llegando a OpenAI/Anthropic en todos los modos |
1. Claude Code — la mejor para el trabajo agéntico profundo en grandes bases de código
Claude Code es la herramienta de programación agéntica de Anthropic, diseñada para leer una base de código, editar archivos, ejecutar comandos y verificar su propio trabajo; se despliega como una CLI de terminal con extensiones equivalentes para VS Code y JetBrains, una app de escritorio, una superficie web y móvil, integraciones con GitHub Actions y GitLab CI y un SDK de agentes.
Tecnología: agéntica: planifica trabajo de varios pasos, ejecuta comandos de shell, lanza subagentes y funciona sin supervisión en CI, sin ninguna superficie de autocompletado. Se despliega sobre: tu editor y tu CI actuales; no los sustituye. Superficies: terminal, VS Code, JetBrains, escritorio, web, iOS, Android, Slack, Chrome, GitHub Actions, GitLab CI/CD, SDK. Acciones: ediciones de varios archivos, ejecución en shell, ejecución de tests, creación de ramas, commits, pull requests, llamadas a herramientas MCP, tareas en segundo plano programadas.
Rendimiento: Claude Code con Claude Fable 5 encabeza la clasificación de Terminal-Bench 2.1 con un 83.8% ± 1.2% (clasificación de terceros, tbench.ai, consultada el 21 de agosto de 2026; ten en cuenta que la entrada la envió Anthropic el 7 de junio de 2026, así que léela como una ejecución del proveedor puntuada en una clasificación neutral y no como una evaluación independiente). OpenAI afirma por su parte un 88.8% en el mismo benchmark para GPT-5.6 Sol sin registrar ninguna entrada en la clasificación, así que considera que la clasificación está en disputa. Claude Opus 5 ocupa el primer puesto de 86 modelos en SWE-bench Verified con un 97.00% (evaluado de forma independiente por Vals AI, clasificación actualizada el 19 de agosto de 2026). La propia Anthropic publica los benchmarks de sus lanzamientos como gráficos y no como texto, así que no existe ninguna cifra absoluta de SWE-bench declarada por el proveedor para Opus 5.
G2: 4.7 (112 reseñas), consultado en agosto de 2026 · Coste: incluye un nivel gratuito; Pro $17/mes con facturación anual o $20 mensual; Max $100 o $200/mes; Team Standard $20/puesto/mes anual, Team Premium $100/puesto/mes anual; Enterprise $20/puesto/mes más el uso a tarifas de API, con facturación anual. El exceso se factura a tarifas de API mediante créditos de uso, con un límite de $2,000 canjeados al día. Consultado en claude.com/pricing, 21 de agosto de 2026.
Ventajas:
- Ocupa el primer puesto y tres de los diez primeros de la clasificación de Terminal-Bench 2.1, y va de la mano del modelo que un evaluador independiente sitúa en primer lugar de 86 en SWE-bench Verified.
- Un único motor en más de diez superficies, con
CLAUDE.md, permisos y servidores MCP que se aplican igual en todas partes y sesiones que pasan entre el terminal, el escritorio y la web. - Una ventana de contexto de 1M de tokens sin recargo por token por encima de 200K en los planes Max, Team y Enterprise.
Inconvenientes:
- Los límites de uso no se publican como cifras, solo como multiplicadores relativos, y han cambiado de forma visible: The Register informó el 5 de enero de 2026 de que los desarrolladores alcanzaban los límites «en 10–15 minutos», y una fuente hablaba de una reducción de aproximadamente el 60%. La respuesta oficial de Anthropic fue que los límites se habían duplicado como promoción del 25 al 31 de diciembre de 2025 y que los usuarios estaban viendo la vuelta a la situación normal: una réplica justa y, a la vez, un ejemplo de por qué es difícil planificar con límites que no se publican.
- Un defecto de facturación documentado, abierto el 1 de abril de 2026, describe errores del caché de prompts que producen una inflación del coste de tokens de 10–20× en todos los niveles de pago.
- La retención cero de datos no forma parte del plan Enterprise estándar (la activa un equipo de cuenta para cada organización) y las transcripciones de las sesiones se guardan localmente en texto plano durante 30 días por defecto.
Nuestra opinión: si tu problema es un repositorio de un millón de líneas que nadie entiende del todo, esta es la herramienta más potente de la lista, y lo respalda una evaluación independiente de SWE-bench y no la presentación de un proveedor. No la elijas si necesitas una factura mensual fija y previsible o un editor gráfico como superficie principal. Kenta Naruse, ingeniero de machine learning de Rakuten, describió una ejecución autónoma de siete horas en el caso de estudio de Anthropic: «No escribí nada de código durante esas siete horas. Solo di alguna indicación de vez en cuando».
2. OpenAI Codex — la mejor para delegar tareas en paralelo en distintas superficies
OpenAI Codex es un producto agéntico de ingeniería de software que asume tareas de programación delegadas y las ejecuta de principio a fin; se despliega como una CLI de terminal, una extensión para editores de la familia de VS Code, apps de escritorio para macOS y Windows, una superficie web de ChatGPT, un sandbox en la nube gestionado por OpenAI y bots dentro de GitHub, GitLab y Slack.
Tecnología: agéntica: ejecuta un ciclo de planificar-actuar-observar con uso de herramientas dentro de un sandbox impuesto por el sistema operativo. Se despliega sobre: tu editor y tu host de Git actuales; no existe un editor de código de OpenAI. Superficies: CLI, VS Code/Cursor/Windsurf, escritorio, web, iOS, Slack, GitHub, GitLab (beta desde el 19 de agosto de 2026). Acciones: edición de archivos, ejecución en shell dentro del sandbox, ejecución de tests, pull requests, revisión de PR y MR, tareas en la nube en segundo plano y en paralelo, automatizaciones programadas.
Rendimiento: GPT-5.6 Sol obtiene un 64.6% en SWE-Bench Pro y un 88.8% en Terminal-Bench 2.1 (ambas declaradas por el proveedor, OpenAI, 9 de julio de 2026; la cifra de Terminal-Bench no está registrada en la clasificación pública, donde lidera Claude Code con un 83.8%). GPT-5.3-Codex obtiene un 77.3% en Terminal-Bench 2.0 (declarado por el proveedor, OpenAI, 5 de febrero de 2026). La última cifra de SWE-bench Verified que OpenAI publicó para un modelo Codex es un 77.9% para GPT-5.1-Codex-Max en noviembre de 2025; desde entonces la empresa se ha pasado a SWE-Bench Pro, así que no existe ninguna cifra de SWE-bench Verified para el modelo actual. GPT-5.6 Sol obtiene 61 en el Artificial Analysis Intelligence Index (clasificación independiente, consultada el 21 de agosto de 2026).
Contexto: la familia GPT-5.6 ofrece una ventana de 1,050,000 tokens en la API, pero Codex utiliza los modelos con 272K, tras una reducción desde 372K en julio de 2026, bastante menos que el 1M de Claude Code o de Antigravity.
G2: 4.7 (19 reseñas), consultado en agosto de 2026; una muestra demasiado escasa para darle mucho peso · Coste: incluido en ChatGPT Plus por $20/mes, Pro $100 o $200/mes, Business $20/usuario/mes anual ($25 mensual), Enterprise personalizado. El uso local está limitado por cada ventana móvil de cinco horas (de 10 a 100 mensajes de GPT-5.6 Sol en Plus), con límites semanales adicionales que no se publican como cifras. Se pueden comprar créditos a unos 50 créditos por dólar. Tarifas de API: Sol $2.50 de entrada / $15 de salida por millón de tokens, que suben a $5.00 / $22.50 por encima de un prompt de 272K; Luna cuesta $0.20 / $1.20. Consultado en learn.chatgpt.com/docs/pricing y developers.openai.com/api/docs/pricing, 21 de agosto de 2026.
Ventajas:
- La cobertura de superficies más amplia de la categoría (terminal, IDE, escritorio, web, iOS, Slack, GitHub y GitLab), todo con una sola suscripción.
- Las tarifas por token de clase frontera más bajas de esta comparativa: GPT-5.6 Sol a $2.50 de entrada / $15 de salida por millón de tokens, y Luna a $0.20 / $1.20 para ejecuciones de agentes más baratas.
- El sandbox a nivel de sistema operativo es la opción por defecto, no una opción: Seatbelt en macOS,
bwrapmásseccompen Linux, acceso a la red desactivado salvo que se active expresamente y archivos de políticas que puede imponer el administrador.
Inconvenientes:
- El consumo de cuota ha empeorado en producción: desde alrededor del 10 de mayo de 2026, los usuarios informaron de que los límites de cinco horas se agotaban en una o dos horas, y la página de estado de OpenAI reconoció un «Increase in users hitting Codex rate limits» antes de darlo por resuelto el 23 de mayo de 2026.
- Windows es una plataforma de segunda, con regresiones del sandbox abiertas en el repositorio oficial, como la incidencia #27125, un helper del sandbox que falta en la CLI 0.138.0.
- La retirada de modelos va a contrarreloj: GPT-5.4 y GPT-5.4 mini dejan Codex el 31 de agosto de 2026 para los usuarios que inician sesión con ChatGPT.
Nuestra opinión: elige Codex cuando el patrón de trabajo sea «delegar cinco tareas y revisar cinco pull requests», porque el sandbox en la nube y los puntos de entrada de GitHub y Slack abaratan la delegación. No lo elijas si tu equipo trabaja principalmente en Windows o si necesitas un catálogo de modelos estable que puedas fijar durante un año. Tres Wong-Godfrey, tech lead en Cisco Meraki, describió el patrón: «Con Codex, delegué la refactorización y la generación de tests mientras me centraba en otras prioridades».
3. Cursor — la mejor para el desarrollo diario centrado en el IDE
Cursor es un editor de código con IA y una plataforma de agentes de programación de Anysphere, diseñada para ayudar a los ingenieros a escribir, refactorizar y revisar código en todo un repositorio; se despliega como un editor de escritorio independiente derivado de VS Code, además de una CLI, agentes en la nube en la web, apps para iPad e integraciones con chats y gestores de incidencias.
Tecnología: agéntica con una capa de recuperación: el agente ejecuta bucles de llamadas a herramientas sin límite sobre un índice de embeddings de tu repositorio. Se despliega sobre: nada; sustituye a tu editor, y esa es la contrapartida central. Superficies: editor de escritorio, CLI, agentes en la nube, iPad, Slack, Teams, Jira, Linear, plugins para JetBrains y Xcode. Acciones: ediciones de varios archivos, ejecución en shell, control del navegador para la verificación visual, agentes en la nube programados y activados por eventos, VM de subagentes aisladas, revisión agéntica de PR mediante Bugbot.
Rendimiento: Cursor publica CursorBench 3.2, una clasificación en vivo de 56 configuraciones de modelos actualizada el 11 de agosto de 2026, en la que lidera Grok 4.6 con un 70.8% y el propio Composer 2.5 de Cursor se sitúa en un 56.1% (publicado por el proveedor, cursor.com/evals, y llamativamente poco favorable para sí mismo). El informe técnico de Composer 2 de Cursor afirma un 73.7% en SWE-bench Multilingual y un 61.7% en Terminal-Bench (declarado por el proveedor). Un estudio del proveedor, firmado junto con Suproteem Sarkar, profesor ayudante de finanzas e IA aplicada en la Universidad de Chicago, concluyó que las empresas fusionan un 39% más de pull requests tras activar el modo agente, sin cambios significativos en las tasas de reversión (telemetría del proveedor, 11 de noviembre de 2025, no independiente). Cursor no publica la cifra de la ventana de contexto de ningún modelo.
G2: 4.6 (315 reseñas), consultado el 21 de agosto de 2026 · Coste: Hobby gratis; Pro $20/mes con $20 de uso de modelos de terceros incluidos; Pro+ $60/mes con $70 incluidos; Ultra $200/mes con $400 incluidos; Teams Standard $40/usuario/mes, Teams Premium $120/usuario/mes; Enterprise personalizado. Por encima de la cuota incluida, o bien añades uso bajo demanda a las tarifas de API del modelo, o bien subes de plan. Consultado en cursor.com/docs/account/pricing, 21 de agosto de 2026; la página pública de precios no muestra las cifras de Pro+ ni de Ultra.
Ventajas:
- El mayor despliegue enterprise verificado de la categoría: NVIDIA informa de 30,000 empleados que usan Cursor a diario y 3× más código enviado, en un caso de estudio publicado el 6 de febrero de 2026 con ingenieros de NVIDIA identificados que lo confirman.
- Su modelo propio, Composer 2.5, se factura a $0.50 de entrada / $2.50 de salida por millón de tokens, aproximadamente una vigésima parte del precio de salida de los modelos de frontera dentro del mismo producto.
- Publica una clasificación en vivo que sitúa a los competidores por encima de su propio modelo, una información comprobable que no ofrece ningún otro proveedor de esta lista.
Inconvenientes:
- El uso incluido de los modelos propios de Cursor solo se describe como «un uso incluido generoso», sin número de solicitudes, de tokens ni valor en dólares, así que los compradores no pueden prever cuándo alcanzarán un límite. Los comentarios agregados de G2 señalan por su parte el deseo de tener «más visibilidad del consumo de tokens por solicitud».
- Cursor pidió disculpas públicamente el 4 de julio de 2025 por un cambio de precios de junio de 2025 que, según admitió, «no se comunicó con claridad», y reembolsó tres semanas de cargos inesperados.
- Los reseñadores de G2 informan de picos de RAM al indexar repositorios grandes, ralentizaciones en proyectos más grandes y pérdida de contexto que produce cambios demasiado amplios.
- La propiedad cambió en 2026. SpaceX completó la adquisición de Anysphere íntegramente en acciones, con un valor implícito de $60 mil millones, el 14 de agosto de 2026, según el formulario 8-K presentado ante la SEC por la empresa. Considera la continuidad de la hoja de ruta y de los precios como una incógnita en cualquier compromiso de varios años.
Nuestra opinión: Cursor ofrece la mejor experiencia de edición pura de esta lista y es la apuesta más segura si tus ingenieros van a adoptar de verdad la herramienta, lo cual es una restricción real. No lo elijas si tu organización no puede estandarizarse en un único editor, o si un cambio de propiedad de hace siete semanas pone nervioso al departamento de compras. Fabian Theuring, senior software architect de NVIDIA, planteó claramente el argumento de la adopción: «Usamos Cursor todos los días, y ya no hay vuelta atrás, porque ha cambiado por completo la forma en que funciona la ingeniería de software».
4. GitHub Copilot — la mejor para estandarizar una organización sin cambiar de editor
GitHub Copilot es la plataforma de IA para desarrolladores de Microsoft y GitHub, que abarca el autocompletado en línea, el chat, el modo agente dentro del IDE, un agente autónomo en la nube y la revisión automatizada de pull requests; se despliega como una capa de suscripción sobre más de doce editores existentes, github.com, una CLI y el móvil, y no como un entorno independiente.
Tecnología: híbrida: ofrece tanto una vía de autocompletado optimizada para la latencia como una ejecución agéntica completa en un entorno efímero de GitHub Actions. Se despliega sobre: todos los editores que tu equipo ya utiliza, que es todo su argumento. Superficies: VS Code, Visual Studio, JetBrains, Neovim, Xcode, Eclipse, Azure Data Studio, github.com, CLI, móvil, Raycast. Acciones: ediciones de varios archivos, comandos de terminal, de incidencia a pull request mediante el agente en la nube, revisión automatizada de PR y, a través de Agent HQ, asignación de trabajo a Claude de Anthropic y a Codex de OpenAI como agentes nativos de GitHub.
Rendimiento: Microsoft informó de 50 millones de usuarios de Copilot y de que «una de cada tres pull requests en GitHub implica ya a un agente» en su presentación de resultados del FY26 Q4, el 29 de julio de 2026 (declarado por el proveedor). La cifra de un 55% más rápido que GitHub cita a menudo procede de una prueba realizada por el proveedor en 2022 con una única tarea de juguete (escribir un servidor HTTP en JavaScript, n=95) y no debe leerse como actual. El hallazgo independiente más riguroso de esta categoría apunta en sentido contrario: el ensayo controlado aleatorizado de METR con 16 desarrolladores experimentados de código abierto sobre 246 incidencias reales concluyó que eran un 19% más lentos con herramientas de IA, aunque creían ser un 20% más rápidos (independiente, 10 de julio de 2025; ten en cuenta que los participantes usaron Cursor con Claude, no Copilot, así que léelo como evidencia sobre la categoría y no sobre este producto). GitHub no publica ninguna puntuación de SWE-bench para su agente en la nube.
G2: 4.4 (394 reseñas); Capterra 4.5 (50 reseñas), ambas consultadas en agosto de 2026 · Coste: ten en cuenta que el modelo cambió el 1 de junio de 2026, cuando las unidades de solicitudes premium se sustituyeron por AI Credits a razón de 1 crédito = $0.01, consumidos según el uso de tokens a las tarifas de API publicadas para cada modelo. Free $0; Pro $10/mes (1,500 créditos, $15 de valor); Pro+ $39/mes (7,000); Max $100/mes (20,000); Business $19/puesto/mes (1,900); Enterprise $39/puesto/mes (3,900). Los créditos no se acumulan: la cuota no usada se pierde a las 00:00 UTC del primer día de cada mes. Consultado en docs.github.com/copilot/get-started/plans, 21 de agosto de 2026.
Ventajas:
- La cobertura de editores más amplia de todas las herramientas de esta lista, incluidos Xcode, Eclipse y Neovim, así que nadie tiene que migrar.
- Elección de modelos de varios proveedores dentro de un mismo puesto: se pueden seleccionar Claude Opus 5, GPT-5.6, Gemini 3.1 Pro, Grok 4.6 y Kimi K3.
- Ejecuta de forma nativa los agentes de sus rivales: Claude y Codex se pueden asignar en Copilot Business y planes superiores a través de Agent HQ.
Inconvenientes:
- El paso a créditos medidos por tokens en junio de 2026 provocó sustos documentados en las facturas. En el debate de la comunidad de la propia GitHub, el usuario @mtaheri8541 escribió el 1 de junio de 2026: «Hoy, en solo dos horas de trabajo de desarrollo normal, ya he agotado el 8% de mis créditos mensuales. A este ritmo, mi cuota de 7,000 unidades se agotará en menos de dos días».
- La exclusión de contenido (el control enterprise que mantiene los archivos sensibles fuera del alcance del modelo) tiene agujeros documentados: la documentación de GitHub indica que no se aplica a enlaces simbólicos ni a sistemas de archivos remotos y que «actualmente no se admite en los modos Edit y Agent», que son precisamente los que leen de forma más amplia. Además, solo está disponible en Business y Enterprise.
- El agente en la nube tiene límites estructurales estrictos: una sesión máxima de 59 minutos, una rama por sesión, ningún cambio simultáneo en varios repositorios y solo repositorios alojados en GitHub.
Nuestra opinión: Copilot gana en gobernanza y alcance más que en capacidad bruta del agente, y para una organización de 200 ingenieros con cinco editores en uso suele ser el factor decisivo. No lo elijas si tus repositorios están fuera de GitHub o si necesitas que las sesiones del agente duren más de una hora. Jonathan Burket, senior engineering manager de Duolingo, planteó su valor como concentración más que como velocidad: «GitHub Copilot evita que te distraigas cuando estás haciendo un trabajo profundo».
5. Google Antigravity — la mejor para agentes de frontera sin coste por puesto
Google Antigravity es la plataforma de desarrollo de Google centrada en los agentes, diseñada para que los desarrolladores deleguen tareas de programación de varios pasos en agentes autónomos impulsados por Gemini que planifican, editan código, ejecutan comandos y manejan un navegador; se despliega como una aplicación de escritorio para Windows, macOS y Linux, una CLI de terminal escrita en Go, extensiones para VS Code, Visual Studio, JetBrains y Zed, un SDK de Python y Gemini Enterprise en Google Cloud.
Lee esto primero: Gemini CLI ya no es el producto de consumo actual. Google dejó de atender las solicitudes gratuitas, de AI Pro y de AI Ultra a través de Gemini CLI y de las extensiones de IDE de Gemini Code Assist el 18 de junio de 2026, y trasladó a esos usuarios a Antigravity CLI. Gemini CLI sigue disponible para las organizaciones con una licencia de Gemini Code Assist Standard o Enterprise y para el uso de pago con clave de API. Varias recopilaciones de la competencia todavía lo incluyen como un producto de consumo activo.
Tecnología: agéntica: el comando /goal ejecuta un agente hasta completar la tarea sin intervención intermedia, y Manager View orquesta subagentes en paralelo. Se despliega sobre: tu editor actual si usas las extensiones; la app de escritorio lo sustituye. Superficies: app de escritorio Antigravity 2.0, CLI, extensiones de IDE, SDK de Python, Android Studio. Acciones: edición de archivos, ejecución en shell, depuración con el navegador en el circuito, orquestación de agentes en paralelo, modo de Git worktree aislado, tareas en segundo plano programadas y Artifacts de verificación (planes de implementación, recorridos guiados, capturas de pantalla y grabaciones del navegador). La creación nativa de pull requests no figura como capacidad publicada.
Rendimiento: Gemini 3.7 Flash obtiene un 65.3% en DeepSWE v1.1 y un 43.6% en FrontierCode 1.1 (declarado por el proveedor, blog de Antigravity, 13 de agosto de 2026). Alcanza 1588 Elo en WebDev Arena (clasificación de terceros, citada por el proveedor, misma fecha). No se publica ninguna cifra de SWE-bench Verified para Antigravity, y no hemos encontrado ninguna evaluación independiente del propio producto.
G2: sin ficha; el producto anterior, Gemini Code Assist, tiene un 4.4 (73 reseñas) y Product Hunt muestra un 4.6 (19 reseñas), ambos consultados el 21 de agosto de 2026 · Coste: gratis para desarrolladores individuales, con niveles de cuota que la página de planes de Google describe solo como «significativa», «generosa» y «la más alta»; esa página no publica precios ni cifras de solicitudes al día. Google AI Pro cuesta $19.99/mes y Google AI Ultra empieza en $100/mes. Gemini Code Assist factura por horas: Standard sale por aproximadamente $19/usuario/mes con un compromiso de 12 meses y Enterprise, por unos $45 (cloud.google.com/products/gemini/pricing). Tarifas de API: Gemini 3.1 Pro a $2 de entrada / $12 de salida por millón de tokens hasta un prompt de 200K, que suben a $4 / $18 por encima; Gemini 3.7 Flash a $0.75 / $3.75 hasta el 31 de diciembre de 2026 (ai.google.dev/gemini-api/docs/pricing). Todo consultado el 21 de agosto de 2026.
Ventajas:
- Gratis para desarrolladores individuales en Windows, macOS y Linux, con acceso a Gemini 3.1 Pro y autocompletados con tabulador ilimitados: el único agente de frontera realmente sin coste de esta lista.
- Elección de modelos de varios proveedores dentro de un entorno propio de Google, incluidos Claude Sonnet 4.6, Claude Opus 4.6 y GPT-OSS-120B.
- Los precios por token de clase frontera más baratos de la comparativa: $0.75 / $3.75 por millón de tokens para Gemini 3.7 Flash hasta finales de 2026.
Inconvenientes:
- Antigravity no tiene ninguna certificación SOC ni ISO. La propia matriz de cumplimiento de Gemini Enterprise de Google indica que Antigravity no admite FedRAMP, IL4/IL5, certificaciones ISO ni SOC 1/2/3, algo sustancialmente más débil que Gemini Code Assist, que tiene ISO 27001/27017/27018/27701 y SOC 1/2/3.
- Se han revelado públicamente vulnerabilidades repetidas de inyección de prompts que llevan a ejecución remota de código, incluida una forma de eludir el Strict Mode descubierta por Dan Lisichkin, investigador de Pillar Security, revelada el 7 de enero de 2026 y corregida el 28 de febrero de 2026.
- La retirada de Gemini CLI fue abrupta, Google reconoció que no habría «paridad de funciones 1:1 desde el primer momento», y las pruebas prácticas revelaron que Antigravity CLI exige OAuth a través del navegador, algo hostil para una CI sin interfaz.
Nuestra opinión: para un desarrollador individual o una startup que vigila su consumo de caja, es realmente difícil discutir un agente de frontera gratuito de Google, y el modelo de Artifacts (planes, recorridos guiados y grabaciones del navegador como resultado verificable) es una idea real que nadie más ofrece. No lo elijas para trabajo regulado ni para nada que toque datos de clientes hasta que se cierre la brecha de cumplimiento. Callum Anderson, head of engineering de WPP, informó de que integrar Antigravity «agilizó los flujos de trabajo, automatizó tareas repetitivas y dio a los equipos de ingeniería la capacidad de entregar más rápido soluciones de alta calidad a nuestros clientes».
6. CodeRabbit — la mejor para la revisión de código automatizada como filtro de merge
CodeRabbit es una plataforma comercial de revisión de código con IA que revisa las pull requests teniendo en cuenta el contexto (comentarios línea a línea, resúmenes de cambios y correcciones con un clic); se entrega como un bot instalado en los hosts de Git existentes, además de extensiones de IDE y una CLI, con el autoalojamiento reservado a las grandes cuentas enterprise.
Tecnología: agéntica dentro del ámbito de la revisión: modelos de frontera orquestados con recuperación sobre los repositorios vinculados, más linters deterministas, SAST y detección de secretos, ampliada ahora con Agent Skills reutilizables y triaje de PR según el riesgo. Se despliega sobre: tu flujo de revisión actual; añade un revisor y no sustituye nada. Superficies: GitHub, GitLab, Bitbucket, Azure DevOps, VS Code, Cursor, Windsurf, CLI, Slack, Discord, Jira, Linear. Acciones: revisión línea a línea, resúmenes de PR y diagramas de secuencia, correcciones con un clic, análisis estático, detección de problemas de seguridad y de secretos, chat agéntico, planes de programación a partir de incidencias, generación de tests unitarios, resolución de conflictos de merge, aprobación y resolución de hilos.
Rendimiento: CodeRabbit informa de más de 2 millones de revisiones de código a la semana entre más de 17,000 clientes y más de 150,000 proyectos de código abierto (declarado por el proveedor, BusinessWire, 12 de agosto de 2026). Su propio benchmark de modelos, sobre unos 100 patrones de error verificados de código abierto, sitúa su referencia de producción en una tasa de acierto del flujo completo del 61.1% (todas las clases de comentarios, incluidos los detalles menores de baja confianza) con una precisión accionable del 35.2% (publicado por el proveedor, 24 de julio de 2026). El benchmark de un proveedor de la competencia le da una puntuación más baja; como ese benchmark lo publica un rival directo, no lo citamos como independiente. No se ha publicado ningún benchmark de precisión de terceros neutral.
G2: 4.4 (113 reseñas); Gartner Peer Insights 4.2 (21 reseñas), ambas consultadas en agosto de 2026 · Coste: el nivel Free solo incluye resúmenes: la revisión real de PR exige un plan de pago o la vía del IDE/CLI. Los proyectos de código abierto que cumplen los requisitos obtienen las funciones de Pro+ sin coste. Pro $24/desarrollador/mes anual ($30 mensual); Pro+ $48 anual ($60 mensual); Enterprise personalizado. Prueba de Pro+ de catorce días sin tarjeta (docs.coderabbit.ai/management/plans). Un complemento de Security cuesta $40/usuario/mes (coderabbit.ai/pricing). Ambos consultados el 21 de agosto de 2026.
Ventajas:
- La cobertura de hosts de Git más amplia de todos los revisores dedicados (GitHub, GitLab, Azure DevOps y Bitbucket con disponibilidad general), mientras que Greptile solo documenta GitHub y la revisión de Copilot llega a Azure DevOps en preview pública.
- Los proyectos de código abierto que cumplen los requisitos reciben gratis el nivel Pro+ de $48/desarrollador; CodeRabbit afirma haber cubierto más de $5M en costes de revisión para el código abierto desde el 1 de febrero de 2025.
- Precios planos por desarrollador, así que el volumen de revisiones no cambia la factura: la única herramienta de esta comparativa cuyo coste es realmente previsible.
Inconvenientes:
- El autoalojamiento está restringido a 500 puestos o más, e incluso entonces los prompts de revisión y el código fuente siguen viajando al proveedor de LLM que hayas configurado; no existe un modo aislado de la red.
- El ruido de las revisiones y la carga de ajuste son quejas recurrentes: los reseñadores de G2 citan comentarios «demasiado cautelosos o que no tienen en cuenta el contexto del proyecto», instalaciones sin ajustar que generan comentarios excesivos y pull requests grandes que tardan más de 20 minutos, lo que es un problema cuando la comprobación es un filtro obligatorio para el merge.
- Una brecha en la cadena de suministro de 2025 fue significativa: Kudelski Security logró ejecutar código de forma remota en la producción de CodeRabbit mediante una configuración maliciosa de Rubocop en una pull request, extrajo la clave privada de la GitHub App y obtuvo acceso potencial a aproximadamente un millón de repositorios. Se reveló el 24 de enero de 2025 y se corrigió el 30 de enero de 2025.
Nuestra opinión: la revisión de código es donde el código generado por IA se detecta o se publica, y CodeRabbit es el revisor dedicado más completo que existe: debe acompañar a uno de los cinco agentes anteriores, no sustituirlo. No lo elijas si necesitas un despliegue aislado de la red o si tu equipo no va a invertir las horas de ajuste de .coderabbit.yaml que mantienen el ruido bajo control. Nathan Esquenazi, CTO y cofundador de CodePath, describió la instalación como inmediata: «CodeRabbit fue fácil de configurar y, desde el primer momento, dio a cada pull request un resumen de los cambios generado por IA y una revisión de código línea a línea».
Lo que cuestan realmente las herramientas de programación con IA
Pongamos un escenario concreto: 10 desarrolladores, un mes, uso agéntico diario, es decir, cada ingeniero lanza varias tareas de agente sobre varios archivos al día en lugar de aceptar autocompletados ocasionales. Esto es lo que factura cada herramienta antes del exceso.
| Herramienta | Plan | Por puesto / mes | 10 desarrolladores | Qué pasa cuando se agota la cuota incluida |
|---|---|---|---|---|
| Claude Code | Team Standard (anual) | $20 | $200 | El trabajo se detiene salvo que estén activados los créditos de uso; esos créditos se facturan a tarifas de API sin un techo fijo por debajo de $2,000/día. Enterprise también cuesta $20/puesto más el uso. |
| Claude Code | Team Premium (anual) | $100 | $1,000 | 5× la cuota del puesto estándar y, después, los mismos créditos medidos |
| OpenAI Codex | ChatGPT Business (anual) | $20 | $200 | Se reinicia la ventana de cinco horas, o el espacio de trabajo compra créditos a ~50 por dólar |
| Cursor | Teams Standard | $40 | $400 | Uso bajo demanda a las tarifas de API del modelo, facturado a mes vencido |
| GitHub Copilot | Business | $19 | $190 | 1,900 créditos ($19 en tokens) por usuario, sin acumulación, y después exceso a las tarifas de API de cada modelo |
| Google Antigravity | Nivel gratuito individual | $0 | $0 | La cuota se renueva en un ciclo de cinco horas o semanal; los suscriptores de Pro/Ultra pueden comprar créditos |
| CodeRabbit | Pro (anual), añadido junto a un agente | $24 | $240 | Nada: tarifa plana, el volumen de revisiones no cambia la factura |
La lectura honesta de esta tabla es que los precios por puesto se concentran entre $190 y $400 al mes para diez desarrolladores, y después divergen enormemente según un consumo de tokens que ninguno de estos proveedores va a prever por ti. GitHub es el más explícito al respecto: 1,900 créditos son exactamente $19 en tokens, y una sola pull request agéntica con un modelo de frontera puede consumir una parte considerable de esa cifra. Un usuario del hilo de la propia comunidad de GitHub informó de 822 créditos (unos $8.22) gastados en una sola solicitud.
Costes ocultos que hay que presupuestar. El exceso es el más evidente y el mayor. Además: los créditos de Copilot caducan cada mes sin acumulación, así que infrautilizarlos es puro desperdicio; el Max Mode de Cursor tiene un recargo del 20% sobre las tarifas de API y está limitado a los planes antiguos; Codex duplica aproximadamente su tarifa por token en cualquier solicitud con un prompt de más de 272K; la detección de seguridad de CodeRabbit es un complemento aparte de $40/usuario; y la Zero Data Retention de Claude Code, si tu equipo legal la exige, no está en el plan Enterprise estándar y hay que negociarla.
La trampa de lo «gratuito». Los harnesses de código abierto como Cline, Aider y OpenCode son software gratuito que funciona con modelos de pago. El harness no cuesta nada; un usuario intensivo con un modelo de frontera puede gastar más que un puesto de Cursor Ultra. Cualquier comparativa que los clasifique como «gratuitos» está comparando un envoltorio con una suscripción.
Cómo elegir la herramienta de programación con IA adecuada
- Si tu base de código es grande, antigua y está mal documentada, elige Claude Code, porque una evaluación independiente de SWE-bench Verified sitúa a Claude Opus 5 en primer lugar de 86 modelos, Claude Code lidera la clasificación de Terminal-Bench 2.1 y el contexto de 1M de tokens está incluido en los planes de equipo en lugar de cobrarse con recargo.
- Si el trabajo de tu equipo llega como tickets y pull requests más que como sesiones en el editor, elige OpenAI Codex, porque el sandbox en la nube y los puntos de entrada de GitHub, GitLab y Slack convierten la delegación en la interacción por defecto y no en un paso adicional.
- Si tus ingenieros van a cambiar de editor de verdad, elige Cursor, porque su experiencia de edición es la mejor de esta lista y el despliegue de 30,000 puestos de NVIDIA demuestra que escala.
- Si tus ingenieros no van a cambiar de editor, elige GitHub Copilot, porque es la única herramienta que cubre Xcode, Eclipse, Neovim, JetBrains y Visual Studio con un solo puesto y una sola consola de administración.
- Si el presupuesto es la restricción decisiva, elige Google Antigravity, porque es gratis para desarrolladores individuales con acceso a modelos de frontera, pero no para cargas de trabajo reguladas, porque Antigravity no tiene ninguna certificación SOC ni ISO.
- Si tu cuello de botella es la revisión y no la escritura, añade CodeRabbit, porque el código generado por IA multiplica la carga de revisión y una tarifa plana por desarrollador es la única partida previsible de esta categoría.
- Si el departamento de compras exige una cifra mensual fija, evita todos los planes por token y negocia un acuerdo enterprise con un límite de gasto, porque los precios por puesto publicados en esta categoría describen un mínimo, no una factura.
- Si vas a estandarizar para más de 50 ingenieros, haz una prueba comparativa de dos semanas con tu propio repositorio antes de firmar, porque todos los benchmarks citados en esta página miden un conjunto de tareas público, no tu código.
¿Qué es un agente de programación con IA y en qué se diferencia de un asistente de programación con IA?
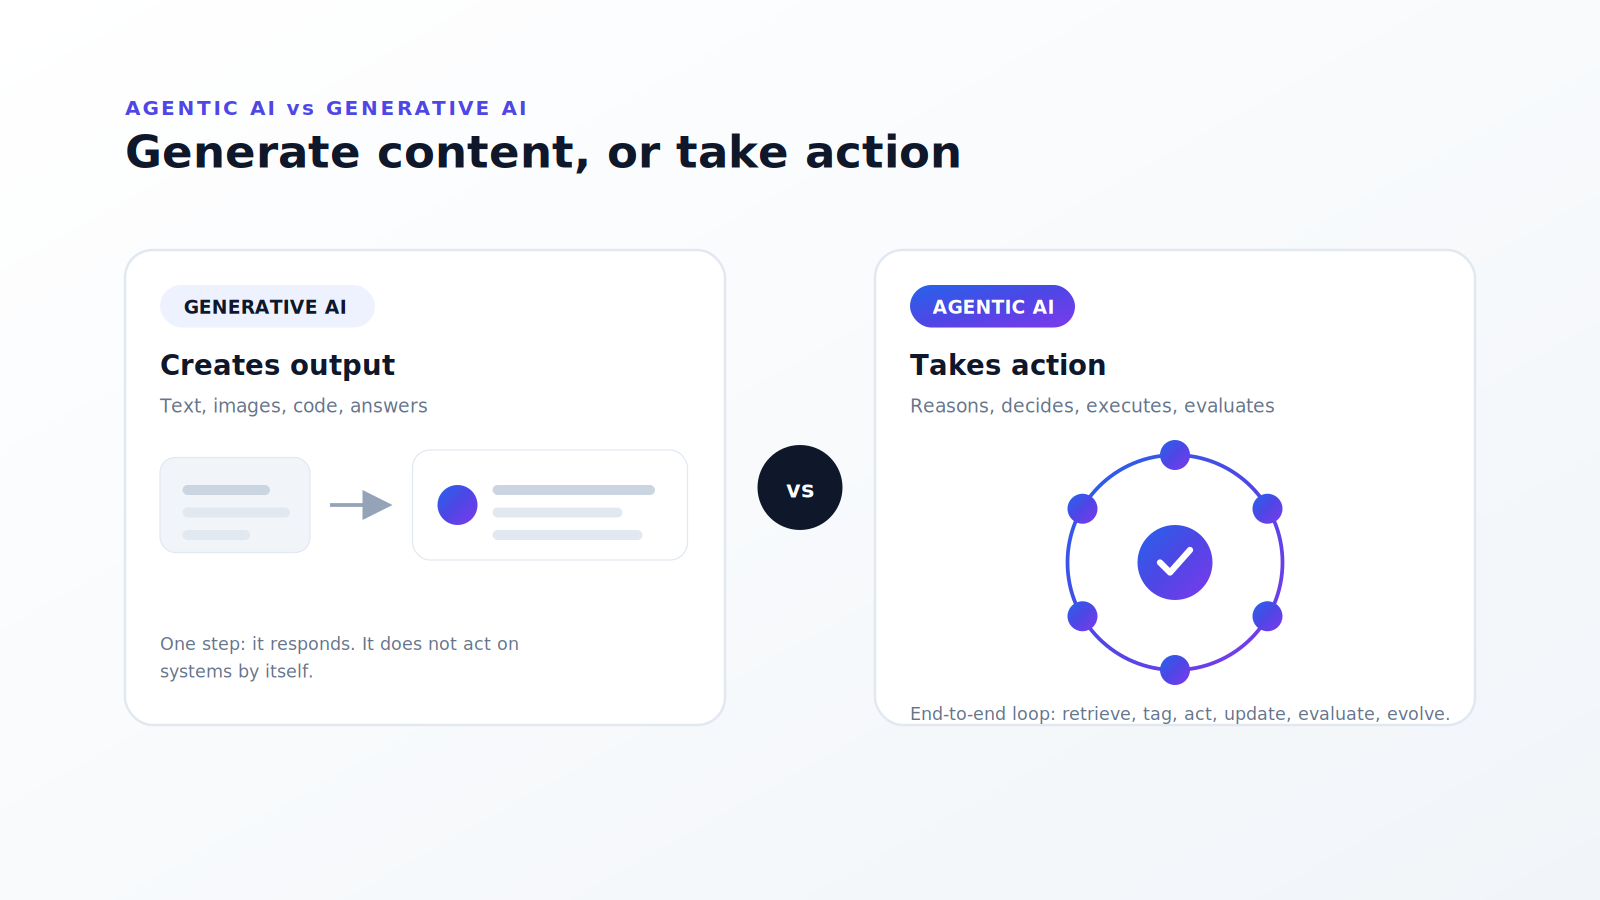
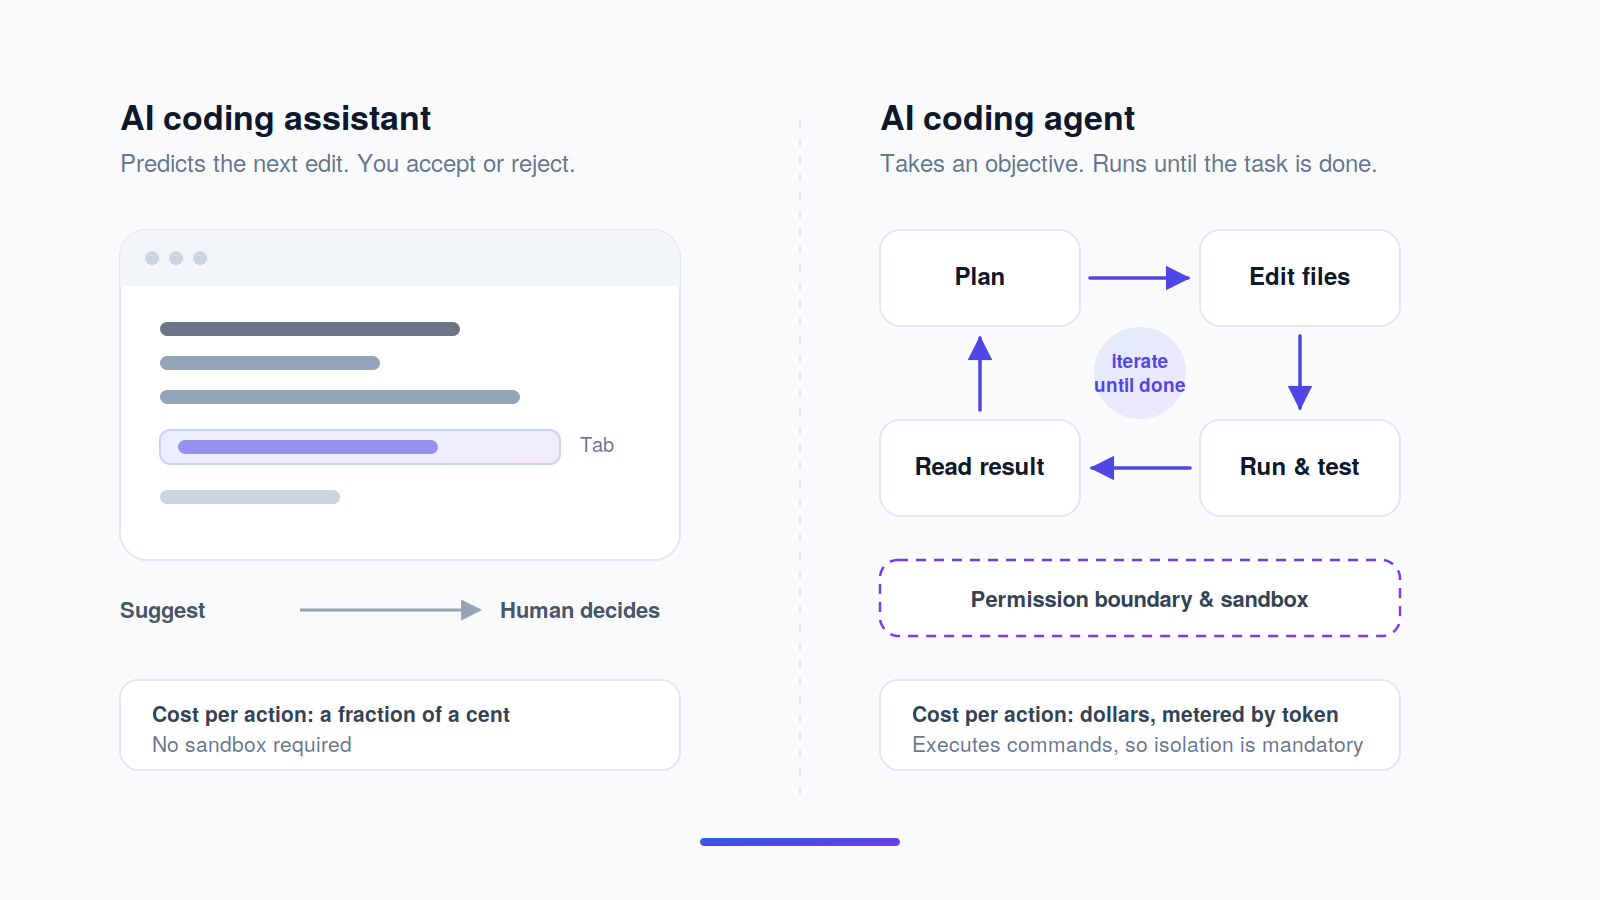
Un asistente de programación con IA predice la siguiente edición; un agente de programación con IA completa la tarea. El asistente te muestra un autocompletado que aceptas o rechazas, sugerencia a sugerencia. El agente recibe un objetivo, planifica los pasos, edita varios archivos, ejecuta la batería de tests, lee el fallo y vuelve a intentarlo, y lo hace dentro de un límite de permisos que defines tú, no dentro de tu flujo de pulsaciones.
Esa distinción decide casi todo lo demás en esta comparativa. Determina la unidad de facturación, porque un autocompletado cuesta una fracción de céntimo y una ejecución de agente cuesta dólares. Determina el modelo de seguridad, porque una herramienta que solo sugiere texto no necesita sandbox y una herramienta que ejecuta comandos de shell necesita uno robusto. Y determina lo que significa en la práctica la «ventana de contexto»: un asistente necesita el archivo actual, mientras que un agente necesita una parte suficiente del repositorio para razonar sobre las consecuencias tres archivos más allá.
La misma línea arquitectónica recorre la IA operativa fuera de la ingeniería. Nosotros la trazamos entre los sistemas que recuperan una respuesta y los sistemas que razonan sobre una arquitectura multiagente para resolver un caso de principio a fin: la misma diferencia que hay entre desviar un ticket y cerrarlo. Los modos de fallo también se parecen: un agente que actúa con seguridad sobre un contexto incompleto es un problema tanto si está refactorizando un servicio de pagos como si está emitiendo un reembolso, y por eso la gobernanza y la verdad de referencia importan más que la capacidad bruta del modelo en ambos entornos.
Lo que los benchmarks te dicen y lo que no. SWE-bench Verified es un subconjunto de 500 casos, filtrado por humanos, de incidencias reales de GitHub en el que un modelo tiene que producir un parche que supere los propios tests del repositorio. Terminal-Bench mide si un agente puede completar tareas en una shell. Ambos son útiles y ambos son limitados: miden la corrección de los parches en repositorios públicos con mucho Python, no el criterio arquitectónico, ni tus convenciones internas, ni si el agente sabe cuándo parar. Usa una clasificación como filtro para la lista corta y luego prueba con tu propio código, por la misma razón por la que defendemos en otros artículos que la evaluación tiene que estar integrada en el sistema en lugar de tomarse prestada de un marcador público.
Por qué no coinciden las cifras de productividad. La prueba del proveedor de GitHub encontró una finalización un 55% más rápida en una tarea de juguete en 2022. El ensayo aleatorizado independiente de METR encontró que, en 2025, los desarrolladores experimentados eran un 19% más lentos en incidencias reales de sus propios repositorios, aunque creían ser un 20% más rápidos. Ambos son resultados reales que miden cosas distintas. El código nuevo sobre un framework desconocido es donde brillan estas herramientas; el trabajo profundo en un repositorio que ya conoces bien es donde el esfuerzo de revisión puede superar el ahorro en generación. Presupuesta en consecuencia y mide a tu propio equipo en lugar de fiarte de cualquiera de las dos cifras.
Preguntas frecuentes
¿Cuánto cuestan realmente Cursor, Claude Code y GitHub Copilot por desarrollador al mes?
Para diez desarrolladores en planes de equipo consultados el 21 de agosto de 2026: GitHub Copilot Business cuesta $19 por puesto, Claude Code Team Standard cuesta $20 por puesto al mes con compromiso anual y Cursor Teams Standard cuesta $40 por puesto. Los tres miden además el uso agéntico a las tarifas de API del modelo, así que la factura real depende de cuánto funcionen tus agentes. Copilot es el más explícito: concede exactamente $19 en créditos de tokens por usuario, sin acumulación.
¿Son realmente gratuitos Cline, Aider y OpenCode?
No. El harness es gratuito y de código abierto; las llamadas al modelo no lo son. Aportas una clave de API y pagas directamente al proveedor del modelo por cada token que consume el agente, lo que con un modelo de frontera durante un trabajo agéntico intensivo puede superar los $200 de un puesto de Cursor Ultra. «Gratis» describe la licencia del software, no el coste mensual.
¿Qué herramientas de programación con IA tienen la certificación SOC 2 y cuáles entrenan con mi código?
Claude Code (SOC 2 Type I y II, ISO 27001:2022, ISO 42001:2023), GitHub Copilot (SOC 1 y 2 Type 2, ISO/IEC 27001:2022), OpenAI Codex (SOC 2 Type 2), Cursor (SOC 2 Type II) y CodeRabbit (SOC 2 Type II, ISO 27001) tienen certificaciones. Google Antigravity no: la propia matriz de cumplimiento de Google indica que no admite SOC 1/2/3 ni ISO. Ninguno de estos proveedores entrena por defecto con los datos de los niveles para empresas; los niveles de consumo varían, y los planes de consumo de Anthropic solo entrenan con consentimiento expreso.
¿Qué ha pasado con Windsurf y sigue teniendo soporte Gemini CLI?
Cognition cambió el nombre de Windsurf a Devin Desktop en junio de 2026, así que cualquier recopilación de 2026 que siga incluyendo «Windsurf» como producto actual está desactualizada. Por otro lado, Google dejó de atender las solicitudes gratuitas, de AI Pro y de AI Ultra a través de Gemini CLI el 18 de junio de 2026 y trasladó a esos usuarios a Antigravity CLI; Gemini CLI sigue disponible para las organizaciones con una licencia de Gemini Code Assist Standard o Enterprise y para el uso de pago con clave de API.
¿Cuál es la diferencia entre un asistente de programación con IA y un agente de programación con IA?
Un asistente predice tu siguiente edición y espera a que la aceptes. Un agente recibe un objetivo, planifica el trabajo, edita varios archivos, ejecuta comandos y tests, lee los resultados e itera hasta terminar la tarea o hasta chocar con un límite de permisos. La diferencia práctica es el coste y el riesgo: los agentes consumen muchos más tokens y necesitan un sandbox, porque ejecutan en lugar de sugerir.
¿Puedo autoalojar un agente de programación con IA o mantener mi código dentro de mi propia nube?
En parte. Claude Code funciona a través de Amazon Bedrock, Google Cloud y Microsoft Foundry, lo que mantiene la inferencia dentro de tu cuenta en la nube. CodeRabbit ofrece autoalojamiento a clientes enterprise a partir de 500 puestos, aunque los prompts siguen llegando al proveedor de LLM que hayas configurado. Ninguna herramienta de esta comparativa ofrece un modo totalmente aislado de la red. Si es un requisito imprescindible, la única vía son los harnesses de código abierto combinados con un modelo autoalojado.
¿Debo fiarme de las puntuaciones de SWE-bench Verified para elegir una herramienta?
Úsalas para elaborar una lista corta, no para tomar la decisión. SWE-bench Verified mide si un modelo puede corregir incidencias reales de GitHub de forma que pasen los propios tests del repositorio, una señal realmente útil, pero extraída de repositorios públicos con mucho Python. No dice nada sobre tus convenciones internas, tu arquitectura ni si el agente sabe cuándo parar. Comprueba también la procedencia: una puntuación evaluada de forma independiente pesa más que el gráfico de un proveedor.
¿Qué herramienta de programación con IA gestiona mejor una base de código heredada de un millón de líneas?
Claude Code, según la evidencia actual. Claude Opus 5 ocupa el primer puesto de 86 modelos en la evaluación independiente de SWE-bench Verified de Vals AI con un 97.00%, Claude Code encabeza la clasificación de Terminal-Bench 2.1 con un 83.8% (una ejecución enviada por el proveedor, y OpenAI afirma una cifra superior no registrada) y su ventana de contexto de 1M de tokens no tiene recargo por token por encima de 200K en los planes Team y Enterprise.
¿Cuánto debería presupuestar un equipo de ingeniería de 10 personas para herramientas de programación con IA?
Presupuesta de $200 a $400 al mes en licencias por puesto y, después, de dos a tres veces esa cantidad en uso medido si el equipo ejecuta agentes a diario. Una cifra de planificación defendible es de $60 a $120 por desarrollador al mes en total para un uso agéntico intensivo. Añade unos $24 por desarrollador si también quieres revisión de código automatizada. Negocia un límite de gasto antes de firmar nada a escala.
¿Hacen realmente más rápidos a los desarrolladores las herramientas de programación con IA?
A veces, y menos de lo que sugiere el marketing. La prueba de 2022 realizada por GitHub encontró una finalización un 55% más rápida en una única tarea de juguete. El ensayo aleatorizado independiente de METR de 2025 encontró que los desarrolladores experimentados eran un 19% más lentos en incidencias reales de repositorios que conocían bien, aunque creían ser un 20% más rápidos. Las ganancias se concentran en el código desconocido, el código repetitivo y los proyectos nuevos; las pérdidas, en el esfuerzo de revisión del código que ya entiendes.
La misma pregunta decide tu stack de soporte. La IA agéntica se juzga igual en la atención al cliente que en la ingeniería: ¿resuelve el caso o solo sugiere una respuesta? Consulta las tasas de resolución y los costes con los que trabajan equipos reales. Reserva una consulta →
Registro de cambios
- Agosto de 2026: primera publicación. Se revisaron seis herramientas y se puntuaron según una rúbrica publicada de cinco criterios; todos los precios se consultaron en las páginas de los proveedores el 21 de agosto de 2026. Se recogen la transición de Gemini CLI a Antigravity CLI (18 de junio de 2026), el paso de GitHub Copilot de las solicitudes premium a los AI Credits (1 de junio de 2026), el cambio de nombre de Windsurf a Devin Desktop (junio de 2026), la reducción de la ventana de contexto operativa de Codex de 372K a 272K (julio de 2026) y la finalización de la adquisición de Anysphere por parte de SpaceX (14 de agosto de 2026).
- Próxima revisión prevista: enero de 2027.